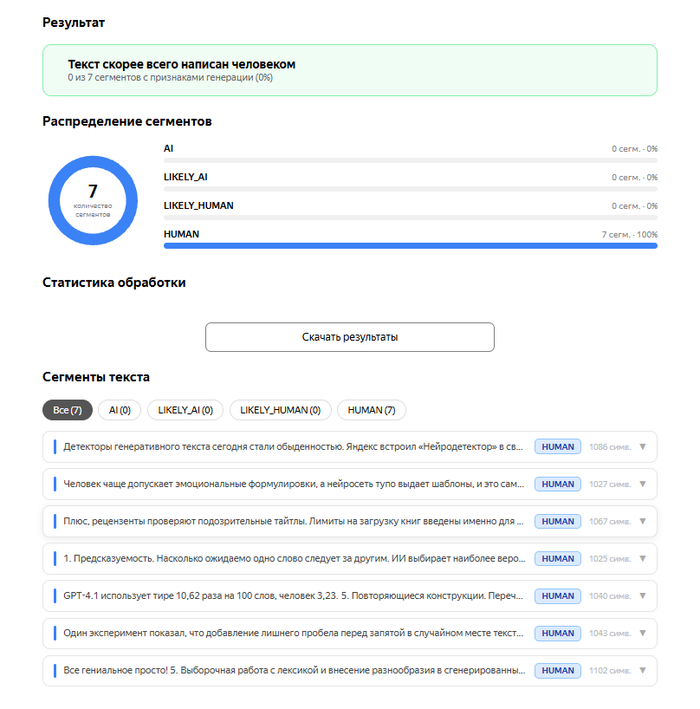
Генерация текста с помощью нейросети — дело пяти минут. А вот объяснить потом преподавателю, редактору или заказчику, почему детектор показывает 95% ИИ, — задача посложнее. Вопрос, как убрать следы ИИ в тексте, встает перед каждым, кто хоть раз доверял создание черновика искусственному интеллекту. И дело не в обмане: часто нейросеть всего лишь помогает оформить мысли, а итоговый материал все равно «фонит».
В этой статье я разобрал, откуда берется этот «фон», по каким маркерам детекторы вычисляют машинный текст и что с этим делать: руками и с помощью сервисов. Внутри — конкретные приемы редактуры, обзор пяти инструментов для проверки и гуманизации, а также способы, которые сегодня действительно работают.
Как определить признаки ИИ в тексте и проверить текст на ИИ-маркеры
Прежде чем что-то исправлять, стоит разобраться, за что именно детекторы «цепляются». Алгоритмы проверки опираются не на смысл, а на статистику: они оценивают предсказуемость слов, длину предложений, частотность оборотов и ритм текста. Чем ровнее и «глаже» материал, тем выше вероятность, что его сгенерировала языковая модель. Такой параметр в среде разработчиков называют перплексией: показателем «удивления». Низкая перплексия означает, что каждое следующее слово легко угадать, а это типичная черта машинного текста.
На практике ИИ-маркеры проявляются вполне конкретно. Вот признаки, по которым детекторы — и внимательные читатели — вычисляют нейросетевой текст.
Однородный ритм. Предложения примерно одной длины идут друг за другом без пауз и перепадов. Живая речь так не работает: человек чередует короткие фразы с развернутыми, делает отступления, возвращается к мысли. Нейросеть же выдает ровный, почти метрономный поток.
Клишированные связки и вводные конструкции. «Стоит отметить», «в современном мире», «в заключение хочется подчеркнуть» — у языковых моделей есть набор любимых конструкций, которые появляются в тексте снова и снова. Детекторы знают эти паттерны и присваивают за них штрафные баллы.
Избыток тире. Характерная особенность русскоязычной генерации — тире чуть ли не в каждом предложении. Нейросеть использует его вместо двоеточий, скобок, запятых просто потому, что в обучающей выборке тире встречается часто и выглядит «красиво».
Отсутствие конкретики. ИИ любит обобщения: «многие эксперты считают», «существует множество способов», «это играет важную роль». За такими формулировками не стоит ни одного факта, примера или цифры. Детекторы фиксируют высокую концентрацию подобных фраз как сигнал о машинном происхождении материала.
Идеальная структура без «шероховатостей». Каждый абзац содержит ровно одну мысль, каждый абзац начинается с тематического предложения, переход между блоками безупречно логичен. Парадокс в том, что «слишком хорошо» для детектора означает «подозрительно». Настоящий автор иногда перескакивает, уточняет на ходу, вставляет ремарки — и именно эти неровности маркируют текст как человеческий.
Эмоциональная стерильность. Нейросеть редко шутит, еще реже — неудачно. Она не раздражается, не сомневается, не делает оговорок. Текст получается вежливым и сбалансированным, но лишенным авторского голоса. Детекторы умеют замерять эту «ровность тональности» и учитывают ее в итоговом результате.
Знание этих маркеров — половина дела. Если вы видите, где именно текст «фонит», вы понимаете, что и как убрать: признаки ИИ в тексте поддаются точечной коррекции, а не тотальному переписыванию. О конкретных приемах — в следующем разделе.
Как убрать маркеры ИИ из текста: ручная правка и помощь нейросети
Итак, маркеры найдены. Теперь — два пути: править самостоятельно или поручить часть работы той же нейросети, но уже с другим подходом. Оба варианта рабочие, а лучший результат, как мне кажется, дает их комбинирование.
Ручная редактура: что делать с текстом
Разбейте ритм. Откройте документ и посмотрите на длину предложений. Если все они примерно одинаковые — это первое, что выдает машину. Разрежьте длинное предложение на два коротких. Объедините два коротких в одно сложное. Вставьте риторический вопрос. Сделайте одно предложение из трех слов. Именно перепады ритма формируют образ живой речи.
Замените клише конкретикой. «Существует множество способов» — это пустая фраза. «Я перепробовал четырнадцать сервисов, прежде чем нашел рабочую связку» — это опыт. Детекторы реагируют на концентрацию обобщений, а конкретные примеры, цифры, названия и личные наблюдения понижают «ИИ-процент» сразу на несколько пунктов.
Уберите лишние тире. Пройдитесь поиском по тексту и посчитайте тире. Если их больше одного на абзац (и они не обоснованы грамматикой и правилами пунктуации русского языка) — это перебор. Детекторы знают об этой привычке нейросетей и обращают на нее внимание, поэтому часть замените двоеточиями, а часть перестройте в придаточные предложения.
Добавьте своего голоса. Вставьте ремарку в скобках. Выскажите сомнение: «не уверен, что это сработает в каждом случае, но у меня результат был стабильным». Пошутите — пусть даже не слишком удачно. Идеальный текст без единой оговорки настораживает и алгоритмы, и людей.
Перестройте вводные конструкции. «Стоит отметить, что» — выбросьте. «Важно подчеркнуть» — туда же. Если мысль и правда важная, она сработает без предупредительных фанфар. И если вы убрали вводную, а смысл абзаца не изменился, значит, вводная изначально была балластом.
Поработайте с лексикой. Нейросеть тяготеет к нейтральным, «безопасным» словам. Замените их на более точные: не «осуществлять», а «делать»; не «являться», а «быть» или вовсе переформулируйте предложение. Синонимы выбирайте не ради разнообразия, а ради точности: именно так пишут живые авторы.
С помощью нейросети: как обойти проверку текста на ИИ через промпт
Парадоксально, но нейросеть способна помочь в борьбе с собственными маркерами. Только не через промпт вида «перепиши текст человечнее»: такие запросы почти не дают результата. Модель просто заменит одни клише на другие.
Гораздо лучше работает детальное техническое задание внутри промпта. Вот принципы, которые я проверял на практике.
Давайте нейросети конкретные ограничения. Например: «Перепиши этот абзац. Не используй тире. Чередуй предложения от 4 до 20 слов. Убери все вводные конструкции. Добавь одно предложение с личным мнением». Чем точнее указанные вами рамки, тем менее шаблонным получится результат.
Задавайте стилистический референс. Попросите нейросеть писать в стиле конкретного автора, блога или издания. «Перепиши этот фрагмент в стиле колонки на vc.ru: живо, с примерами из практики, без канцеляризмов» — такой промпт выдаст совсем иной результат, нежели голое «сделай более живым».
Работайте блоками, а не целым текстом. Если скормить нейросети статью целиком с просьбой «убери ИИ-маркеры», на выходе получится еще один сгенерированный текст — просто с другими словами. Эффективнее брать по одному-два абзаца, давать точечные инструкции и каждый раз проверять результат в детекторе.
Просите нейросеть критиковать, а не переписывать. Промпт «Найди в этом тексте пять признаков, по которым детектор определит его как ИИ-контент, и предложи конкретные исправления» полезнее, чем «перепиши». Вы получаете диагноз и рекомендации, а финальную правку делаете сами — и это как раз то, что снижает процент ИИ.
Важное уточнение: даже лучший промпт не заменяет финальную вычитку. После работы нейросети пройдитесь по тексту еще раз глазами: проверьте, не появились ли новые клише, не «поплыл» ли смысл, не стали ли абзацы снова одинаковыми по длине. Комбинация «нейросеть + ручная правка» стабильно дает результат ниже 25–30% по большинству детекторов, и убрать ИИ-контент из текста таким способом — вполне реалистичная задача.
Сервисы для обхода ИИ-детектора онлайн и гуманизации текста в 2026 году
Ручная правка — это надежно, но долго. Особенно когда на столе лежит статья на 15 000 знаков, а дедлайн — этим вечером. В таких ситуациях выручают сервисы: одни помогают найти «фонящие» фрагменты, другие — переработать текст так, чтобы детектор перестал на него реагировать. Ниже — пять инструментов, которые я тестировал на русскоязычных текстах. Для каждого разобрал механику работы, ограничения, ценник и подводные камни.
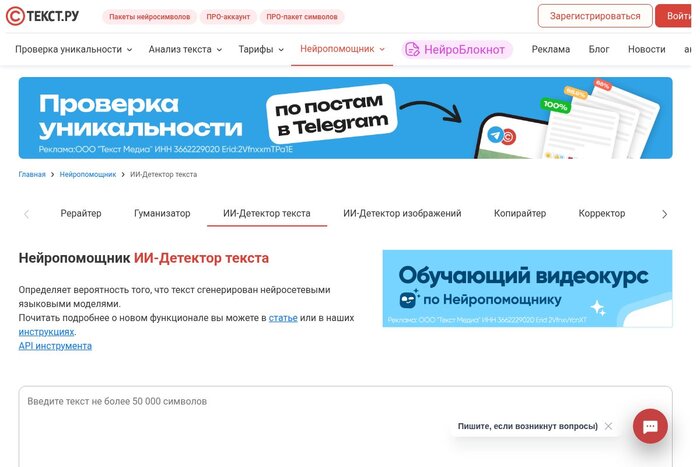
Давно известен как сервис проверки уникальности, но с недавних пор здесь появился и ИИ-детектор: «Нейропомощник ИИ-Детектор».
Как работает проверка. Алгоритм анализирует частотность слов и фраз, ищет повторяющиеся шаблоны и однотипные конструкции, а через несколько секунд выдает результат в процентах: какова вероятность, что текст сгенерирован нейросетью.
Как запустить проверку. Все стандартно: вставьте текст в поле на странице детектора и нажмите «Проверить текст».
Бесплатная версия. Ее нет. Проверка оплачивается нейросимволами — внутренней валютой сервиса. Стоимость 1 000 нейросимволов варьируется от 5,75 до 8 рублей в зависимости от размера пакета. Нейросимволы из пакетов не сгорают со временем, а вот нейросимволы в составе ПРО-аккаунта начисляются ежедневно и имеют срок действия.
Ограничения. Минимальный объем текста для проверки — 100 символов, максимальный — 50 000 символов за один запуск. Точность заметно выше на текстах от 1 000 знаков, короткие фрагменты анализируются менее стабильно.
Результат. Процент вероятности ИИ-генерации. Без подсветки конкретных фрагментов: вы получаете общую оценку текста, а не карту проблемных мест.
Особенности для русскоязычных текстов. Сервис заточен под русский язык, распознает контент от ChatGPT, DeepSeek, Gemini, Claude.
привычный интерфейс;
один баланс нейросимволов на все инструменты (детектор, гуманизатор, рерайтер);
большой лимит символов за одну проверку.
нет бесплатного доступа к детектору;
нет подсветки подозрительных фрагментов (только общий процент), что усложняет точечную правку.
Это целый набор текстовых инструментов: от проверки орфографии до синонимайзера. Для наших задач интересны в первую очередь два раздела: Детектор ИИ текста и ИИ Гуманайзер.
Как работает проверка. Детектор не просто выдает процент, а подсвечивает конкретные участки текста цветом: красный — высокая вероятность ИИ, желтый — подозрительные фрагменты.
Как запустить проверку. Вставьте текст или загрузите файл на странице детектора и нажмите кнопку проверки. Результат появится через несколько секунд: общая оценка и цветовая разметка по фрагментам. Стоит кликнуть на любой выделенный участок — и во всплывающем окне отобразится уровень уверенности алгоритма.
Бесплатная версия. Есть, и это серьезное преимущество. Гости без регистрации могут проверить тексты длиной до 10 000 символов, зарегистрированные пользователи — до 15 000 символов.
Ограничения. Проверяются тексты размером от 250 символов. При высокой нагрузке гости могут попасть в очередь ожидания. Точность на коротких текстах (менее 500 символов) заметно падает. ПРО-версия снимает лимиты: до 1 000 000 символов за проверку, приоритетная обработка без очереди — но она платная.
Результат. Два показателя: процент явной генерации и процент подозрительных фрагментов. Подсветка позволяет видеть, какие именно предложения вызвали сомнения у алгоритма, а это существенно упрощает редактуру.
Особенности для русскоязычных текстов. Алгоритм обучен на русскоязычных данных и распознает генерацию GPT-5, Claude, Gemini, YandexGPT, GigaChat. Заявленная точность — 85%. Разработчики отдельно подчеркивают принцип «презумпции невиновности» автора: система стремится минимизировать ложные обвинения.
бесплатный доступ с приличным лимитом;
подсветка подозрительных фрагментов;
есть гуманайзер на той же платформе — удобно работать в связке «проверил → исправил → проверил снова».
Экосистема SEO-инструментов, и детектор ИИ здесь встроен в общую логику работы с контентом.
Как работает проверка. Сервис анализирует лексику, синтаксис, стиль изложения и «скрытые» языковые признаки, сравнивая их с паттернами генеративных моделей.
Как запустить проверку. Введите текст в поле на странице инструмента, нажмите кнопку запуска. Сервис работает после быстрой регистрации.
Бесплатная версия. Тестовый доступ после регистрации. Дальше — платные тарифы: «Гуру» (от 2 653 рублей в месяц), «Бизнес» (от 17 493 рублей в месяц) и «Энтерпрайз» (от 45 980 рублей в месяц).
Ограничения. Принимает тексты объемом до 50000 символов за раз. Детектор ИИ — часть общего пакета инструментов, отдельно его не купить. Без дальнейшей оплаты тарифа после завершения тестового периода доступ к детектору закрывается.
Результат. Процент вероятности ИИ-происхождения с подсветкой сгенерированных фрагментов. Средняя заявленная точность — 85–95%, но она зависит от объема и степени редактирования текста.
Особенности для русскоязычных текстов. Распознает генерацию ChatGPT, Claude, Gemini, LLaMA и других популярных моделей. Плюсом является то, что на платформе можно выполнить комплексную оценку текста (спамность, плотность ключей, естественность по закону Ципфа), и все эти данные удобно анализировать вместе с результатом ИИ-детекции.
мощная SEO-экосистема вокруг детектора;
комплексный анализ текста в одном окне;
советы по «очеловечиванию» прямо на странице сервиса.
Специальный промокод EXPERTSHELLO дает 300 бонусов при первом пополнении баланса.
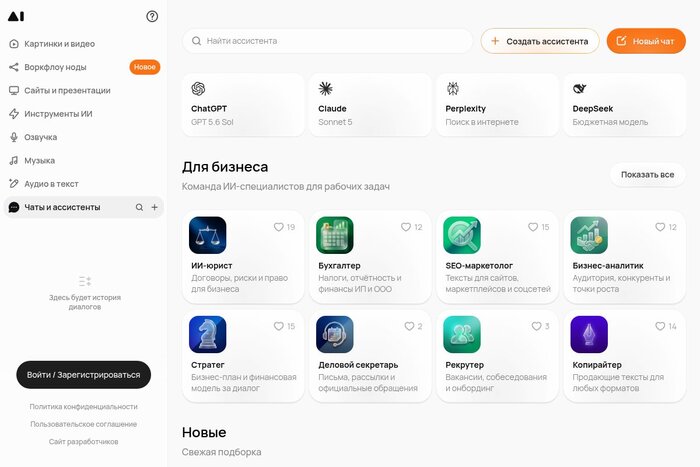
Это не классический детектор, а агрегатор нейросетей с библиотекой готовых ассистентов. Среди них — «ЧеловекоТекст», «Живой текст», «Перефразировщик», «Грамотей» и другие. Каждый заточен под свою задачу, но для гуманизации интереснее всего первые два: они перестраивают синтаксис, разбивают монотонный ритм, добавляют стилистические «шероховатости» — те самые неровности, которые детекторы считают признаком живого автора.
Как работает. Вы выбираете ассистента (например, «ЧеловекоТекст»), вставляете фрагмент и получаете переработанную версию. Под капотом — переключение между несколькими языковыми моделями: GPT, Claude, Gemini, DeepSeek и другими. Сервис не просто подставляет синонимы, а перестраивает предложения на уровне структуры. По сути, это рерайт с глубокой стилистической переработкой, и для обхода ИИ-детектора рефраз такого уровня — один из самых результативных.
Как запустить. Зарегистрируйтесь на платформе, откройте каталог ассистентов, выберите подходящий и начните диалог. Интерфейс — чат: отправляете текст, получаете результат, при необходимости уточняете задачу прямо в переписке.
Бесплатная версия. У сервиса есть собственная языковая модель Grom — запросы к версии Grom 1.5 полностью бесплатны: стоимость и входных, и выходных токенов составляет 0 рублей. Ограничение — в размере контекстного окна: 8 192 токена (примерно 6 000 слов), поэтому длинные тексты придется разбивать на фрагменты. Для тестовой гуманизации нескольких абзацев или проверки отдельных «фонящих» участков этого лимита хватит с запасом. Остальные модели (GPT, Claude, Gemini, DeepSeek) — платные, однако минимальное пополнение составляет всего 50 рублей, а оплата идет только за фактическое использование, без подписок.
Ограничения. У бесплатной модели Grom 1.5 ограниченное по объему контекстное окно, поэтому длинные тексты придется разбивать на фрагменты. Нет встроенного детектора ИИ — после гуманизации результат придется проверять на сторонней площадке. Качество сильно зависит от того, как вы сформулируете задачу ассистенту.
Результат. Переработанный текст, который в идеале выглядит так, словно его писал живой автор. Степень переработки зависит от выбранного ассистента и ваших инструкций в чате: от легкой стилистической правки до радикальной перестройки.
Особенности для русскоязычных текстов. Русский язык поддерживается полноценно: это не формальная локализация, а реальная работа с синтаксисом, интонацией и лексикой. Сервис работает из России без ограничений, что сегодня остается важным фактором.
доступ к 200+ нейросетям через единый баланс;
гибкие настройки через промпт прямо в чате, адекватные цены без обязательной подписки;
бесплатные запросы к собственной модели сервиса, Grom 1.5.
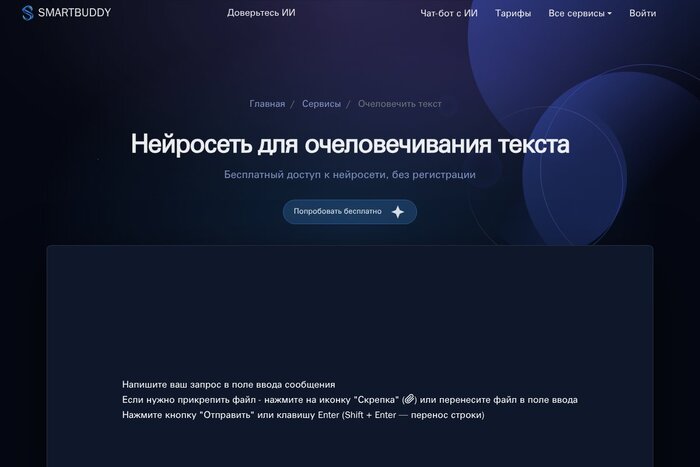
Еще один агрегатор нейросетей, где очеловечивание текста вынесено на отдельную страницу. Сервис позиционирует себя как универсальный инструмент: от генерации контента и создания изображений до работы с документами. Для нашей задачи важна именно страница «Очеловечивание текста», где алгоритм анализирует исходник и переписывает его с учетом «человеческих» языковых паттернов.
Как работает. Вставьте текст в поле на странице очеловечивания, выберите нейросеть-исполнителя и запустите обработку. Искусственный интеллект оценивает структуру, выявляет машинные паттерны и перестраивает формулировки: меняет порядок слов, разбивает или объединяет предложения, заменяет шаблонные обороты на менее предсказуемые.
Как запустить. На странице без регистрации доступны 2 запроса — этого хватит, чтобы оценить качество на коротком фрагменте. После регистрации на счет начисляется стартовый бонус. Интерфейс простой: поле ввода, каталог AI-моделей, кнопка запуска, результат — в одном окне.
Бесплатная версия. Условно бесплатная: 2 запроса без регистрации и стартовый бонус (около 20 запросов) после нее. Тем, кто ищет, как убрать следы ИИ в тексте бесплатно, этого лимита хватит для пробной проверки небольшого фрагмента. Дальше — платный личный кабинет с доступом к 120+ нейросетям.
Ограничения. Без регистрации — всего 2 запроса и лимит на длину текста в 500 символов. На длинных текстах качество очеловечивания менее стабильно: результат стоит проверять в детекторе и при необходимости дорабатывать вручную. Встроенного детектора ИИ на платформе нет.
Результат. Переработанный текст с сохранением исходного смысла. Степень «очеловечивания» варьируется: короткие фрагменты сервис обрабатывает увереннее, на длинных текстах результат стоит проверять в детекторе и при необходимости дорабатывать вручную.
Особенности для русскоязычных текстов. Русский язык заявлен как один из основных. Сервис справляется с типичными маркерами русскоязычной нейрогенерации: избытком тире, вводными конструкциями, однотипными связками. Однако на сложных стилистических задачах (художественный текст, ирония, авторский голос) результат бывает неровным.
низкий порог входа: попробовать сервис реально без оплаты;
понятный интерфейс без лишних элементов;
поддержка файлов популярных форматов (PDF, Word, Excel).
нет встроенного детектора ИИ; платформа позволяет сделать текст человечнее, но проверять результат придется на стороннем ресурсе;
на длинных текстах качество очеловечивания менее стабильно.
Как обойти ИИ-детектор: рабочие способы
Сервисы — это удобно, но ни один гуманайзер не даст гарантированного результата, если не понимать логики детекторов. Ниже — приемы, которые стабильно снижают процент ИИ-детекции. Я проверял каждый из них на нескольких детекторах и отобрал те, что работают не от случая к случаю, а системно.
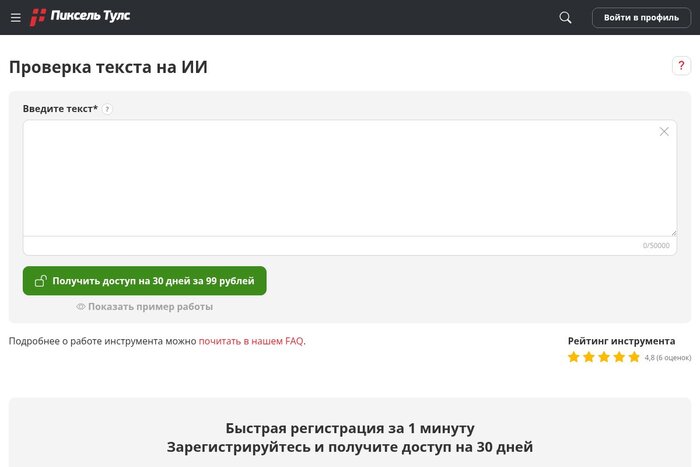
Точечная правка по подсветке. Самый экономный по времени способ. Загрузите текст в детектор с подсветкой (Текстовод или Пиксель Тулс), найдите красные и желтые фрагменты и исправьте именно их. Часто оказывается достаточным заменить два-три слова или переставить части предложения, чтобы детектор перестал реагировать на конкретный участок. Не тратьте силы на абзацы, которые уже проходят проверку, — работайте только с проблемными зонами.
Перефразирование с переменой структуры. Обычная замена синонимами почти бесполезна: детекторы давно научились видеть сквозь нее. А вот смена структуры предложения — рабочий прием. Переверните порядок: вместо «Детекторы анализируют текст по нескольким параметрам» напишите «По нескольким параметрам (длине предложений, частотности связок, ритму) детекторы и выносят свой вердикт». Изменилась структура, добавилась конкретика, появилась интонация. Для обхода ИИ-детектора рефраз на уровне синтаксиса эффективнее, чем на уровне отдельных лексем.
Добавление личного опыта и деталей. Нейросеть не знает, что у вас за окном шел дождь, когда вы дописывали статью в три часа ночи. А детекторы не умеют генерировать такие детали — они их только распознают как «человеческие». Любое конкретное наблюдение, цифра из собственной практики, отсылка к реальной ситуации снижают ИИ-процент.
Нарушение «идеальной» структуры. Вставьте короткое предложение между длинными. Задайте риторический вопрос — и не отвечайте на него сразу. Начните абзац с союза «И» или «Но». Вернитесь к мысли из предыдущего раздела. Все эти «нарушения» воспринимаются детекторами как признаки живого авторства: именно потому, что языковые модели так не пишут.
Комбинация нейросети и ручной правки. Если объем большой, разумнее действовать в два этапа. Первый — прогнать текст через гуманайзер (GPTunneL, SmartBuddy или Текстовод), чтобы сбить основные паттерны. Второй — открыть результат в детекторе с подсветкой и доработать оставшиеся «красные» участки вручную. Такая связка стабильно приводит к результату ниже 25–30% по большинству популярных детекторов. Тем, кто хочет обмануть детектор ИИ, эта двухшаговая схема обеспечивает наиболее предсказуемый эффект.
Промпт-инженерия на этапе генерации. Проще предотвратить проблему, чем исправлять. Если вы генерируете текст с нуля, сразу задайте нейросети жесткие стилистические рамки: запретите вводные конструкции, укажите диапазон длины предложений, попросите добавить одну-две оговорки от первого лица. Чем конкретнее промпт, тем меньше маркеров окажется в черновике — и тем меньше работы у вас будет на этапе редактуры.
FAQ
Получится ли полностью убрать маркеры ИИ?
В большинстве случаев — да, если сочетать автоматическую гуманизацию с ручной правкой. Стопроцентной гарантии не дает ни один метод: детекторы обновляются, алгоритмы обучаются на новых данных, и то, что проходило проверку вчера, завтра может вызвать подозрение. Однако снизить ИИ-процент до 15–20% — задача вполне выполнимая, и для абсолютного большинства площадок (от университетских антиплагиат-систем до бирж контента) этого достаточно.
Почему ИИ-детекторы ошибаются?
Потому что они опираются на статистику, а не на понимание смысла. Детектор оценивает предсказуемость слов, длину предложений, частотность оборотов — и если живой автор пишет ровным, академическим языком с обилием клише, алгоритм вполне способен посчитать его текст машинным. Ложные срабатывания не редкость, особенно на текстах с канцелярским или научным стилем. Верно и обратное: хорошо отредактированный ИИ-контент проскальзывает мимо детекторов, потому что статистические паттерны «сбиты» правками.
Как проверить текст на ИИ после редактирования?
Оптимальный вариант — прогнать материал через два-три детектора одновременно. Один сервис может ошибиться, но если Текстовод, Текст.ру и Пиксель Тулс выдают схожий низкий процент — значит, редактура сработала. Обращайте внимание на подсветку: если конкретные фрагменты все еще «горят» красным, исправьте именно их и проверьте еще раз. Два-три цикла «правка → проверка» обычно решают вопрос.
Что не помогает убрать признаки ИИ?
Простая замена синонимами: детекторы видят сквозь нее. Промпт «перепиши человечнее» без конкретных указаний: модель заменит одни клише другими. Перестановка абзацев местами: структура текста на уровне предложений не изменится, и алгоритм это заметит. Добавление опечаток или случайных ошибок: современные детекторы не ориентируются на орфографию, они анализируют статистические паттерны, поэтому искусственные ошибки не собьют алгоритм, зато испортят текст для читателя.
Парадокс сегодняшнего дня заключается в том, что текст, написанный живым автором, иногда приходится «оправдывать» перед алгоритмом, а материал, собранный нейросетью, — вручную доводить до состояния, в котором тот же алгоритм признает его человеческим. Инструменты, которые я разобрал в этой статье, — от детекторов с подсветкой до гуманайзеров и промпт-инженерии — помогают в обеих ситуациях. Вы получили конкретные приемы: точечную правку по маркерам, переформулирование на уровне структуры, двухшаговую связку «нейросеть + ручная доработка». Каждый из них проверен на практике и работает с русскоязычными текстами. Попробуйте начать с малого: возьмите доступный черновик, загрузите его в любой детектор из обзора, посмотрите на подсветку, подправьте проблемные зоны — и вы увидите, что вопрос, как убрать следы ИИ в тексте, решается не магией, а методичной работой с конкретными фрагментами. Несколько циклов «проверка → правка» — и от машинного «фона» не останется и следа.