Нейросетевой тамагочи
1 пост

1 пост
9 постов
22 поста
7 постов
Короче, упало мне 500 млн токенов от одной китайской нейросети. А идеи куда их потратить не упало. Поэтому я решил собрать тамагочи с нейросетями.
Идея давно витала в воздухе, т.к. я в свободное время занимаюсь попытками имитировать поведение человеческого мозга в языковой модели, с помощью нейросетей. Это не классическая LLM, а скорее попытка сделать виртуального человека на нейросетях и посмотреть что из этого выйдет.
В ОБЩЕМ! Крупная идея несёт в себе какую-то несусветную сложность. Поэтому я решил "смоделировать" эту затею в крохотном искусственном мире с искусственной мышью (гыгы, эксперименты на мышах)
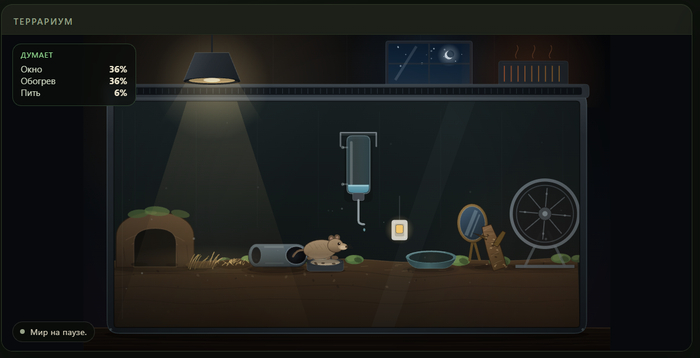
Квартира мыши
Не было цели имитировать настоящую мышь, цель была сделать и научить нейросеть жить в каком-то организме. Какой-то организм получился. Это своего рода тамагочи, где ты не управляешь зверьком. Но можешь вызывать функции мира: дать еду, дать воду, открыть окно, погладить. Мышка видит все эти функции тоже, сама тыкает по ним и учится на последствиях.
Внутри неё — четыре нейросети. Три учатся, одна заморожена с рождения. Написаны руками (*несильнозаебался.jpeg*) агента конечно же, на целочисленной математике, без TensorFlow: обычные целые числа, умножение и сложение, никаких видеокарт.
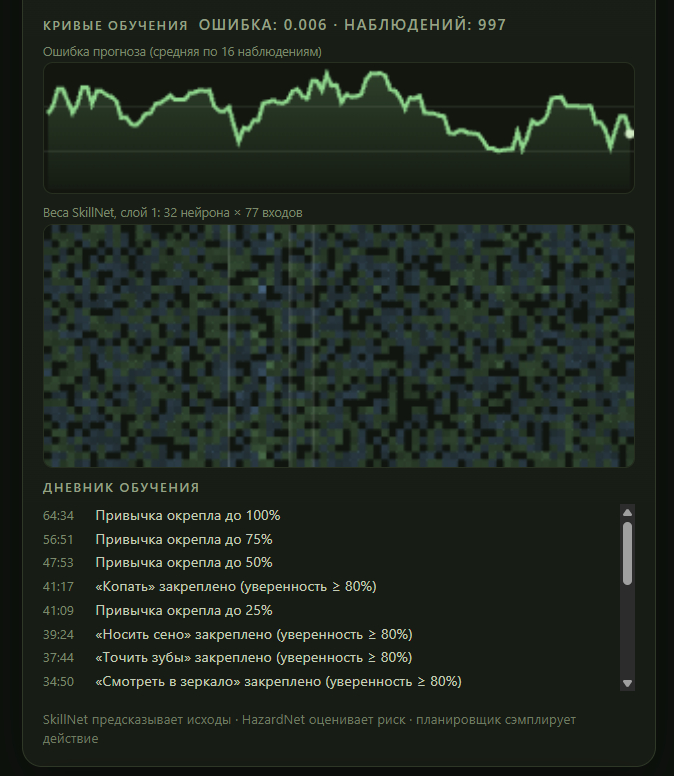
1. SkillNet — предсказывает «что будет с моим телом, если я сделаю вот это». На вход 77 чисел: статусы, гормоны, что лежит в миске, открыто ли окно и описание самого действия. На выход 31 число: каким станет тело, каким станет мир и насколько вероятен успех. Про функции мира новорождённая не знает ничего — её первая догадка «ничего не изменится». Что делает еда, свет и колесо, она выясняет сама, тыкая в них. Все пятнадцать освоенных функций за жизнь — это пятнадцать самостоятельных открытий.
2. Инстинкт — замороженная копия той же сети, обученная ровно на четырёх действиях: есть, пить, спать, исследовать. Она не меняется никогда — иначе мышка, набрав мусорных наблюдений, разучилась бы считать еду полезной. Так что врождённое знание у неё есть, но только про собственное тело и только про эти четыре действия.
3. HazardNet — выученный страх смерти. Её учили на тысячах прогонов симуляции тела: смотрели, сколько тело протянет, и просили отвечать «вот это состояние умрёт быстро». Тоже заморожена. Имён статусов ей не показывали — только числа.
4. HabitNet — привычки. Стартует с нулевыми весами, то есть с абсолютно пустой головой, и всю жизнь подглядывает за решениями системы повыше, потихоньку переписывая их на себя. Примерно к пятой минуте жизни привычки набирают полную силу. Как у людей: сначала каждый раз думаешь, потом идёшь на автопилоте. У неё это видно по полоске «Привычка», которая растёт от 0% на глазах. Перекричать логику она всё равно не может — главный контур всегда сильнее, так что от старых привычек можно уйти.
Итого: тело ей задали, а поведение — нет. Ни одного правила «если голоден — иди к миске» внутри нет. Только числа, сети и гормоны.
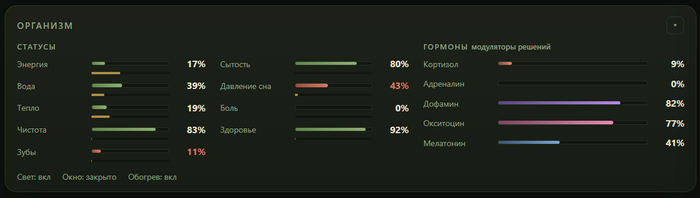
Мотивация у неё не «очки награды», а гормоны. Кортизол реально вредит телу. Успех выбрасывает дофамин. Сон сбрасывает стресс. Гнездо из сена улучшает сон. Всё как у людей, только просто и прямо как палка.
Первые эксперимент: провал
Первая полёвка прожила меньше 5 минут и умерла от истощения: в момент первых признаков истощения она начала неистово дергаться между действиями и ничего не сделав, голод убил её. В первую очередь проблема была в том, что мышка выполняла действия мгновенно и так же мгновенно про это забывала. Не было длительности действия. И некоторый дисбаланс мотиваторов.
HazardNet дал нужный баланс, и следующие полёвки пошли в рост. Последняя прожила почти час (а это много — после 30 минут жизни у них начинается старость, тело ветшает, и жить становится всё труднее).
- 0:04— открыла добавку кормушки (за ЧЕТЫРЕ секунды, буквально ломанулась к миске с рождения)
- потом окно, вода, звук, свет, мытьё, обогрев, игра, уборка
- колесо — последним, к 4-й минуте
- дальше: ела, пила, спала, крутила колесо — сама, без меня. За всю жизнь я вмешался дважды, когда она забыла добавить себе еды.
Умерла от старости: «тело подвело, голова была в порядке». Новый зверёк — новый мозг, ничего не помнит. Смерть тут окончательная, и именно поэтому она важна.
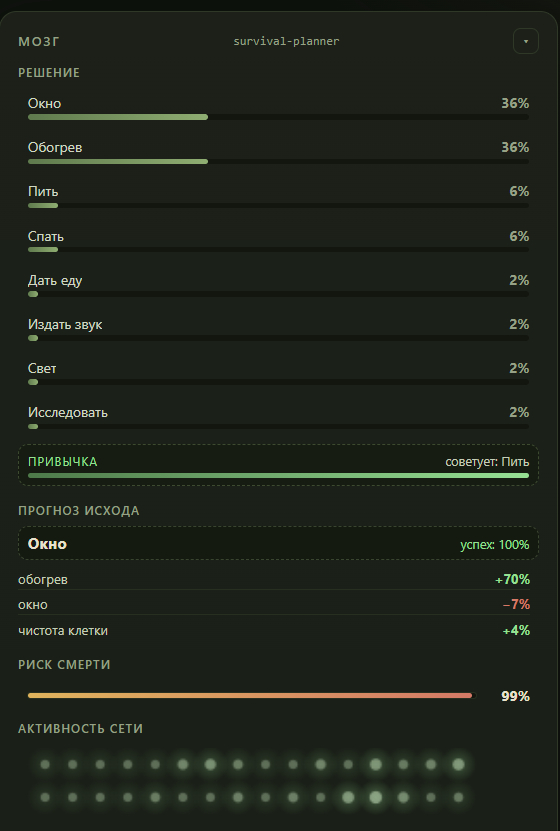
Я сделал панель мозга, где видно всё в реальном времени
- вероятности «что она выберет сейчас» (её настоящие нейроны решают);
- прогноз «что случится с телом, если она это сделает»;
- уровень риска смерти по её внутреннему страху;
- активность скрытого слоя сети — вот эти зелёные точки реально мигают, когда она думает;
- и полоска «Привычка», которая растёт от 0% — привычки образуются на глазах.
Иногда она грызёт ветку, потому что зубы выросли и болят. Иногда закапывается в тоннель, когда стрессует. Один раз пискнула в стену — и из-за стены кто-то пискнул в ответ (соседа я так и не показал, он есть только звуком). Такие маленькие истории складываются сами, я их не программирую.
Что дальше
Планирую накинуть ей сенсоров, и добавить брата-акробата с минимальный социальным функционалом (пищать то она уже имеет).
ИНТЕРАКТИВ:
Что бы добавили такой полёвке?
Что бы вы проверили первым — зрение, речь или больше соседей за стеной?
P.S.
Уже есть приколесные ситуации, где мышь дуреет почти как человек. Так же планирую остановится подробнее на архитектуре, расскажу как всё работает более подробно. Но в следующих постах.
Достал оригинал. И перевёл для вас с помощью моего дубляжа одной кнопкой
Я буду носится со своим переводчиком как курица с яйцом. Смотрите, качайте, пробуйте, выпустил бета-версию. Дубляж одной кнопкой
Приветули! Пару недель назад мне понадобилось перевести пачку старых видео, с озвучкой. В наш век нейросетей мне показалось что нейросети есть для всего.
В целом я был прав, но отчасти. Наткнулся на программулину pyvideotrans
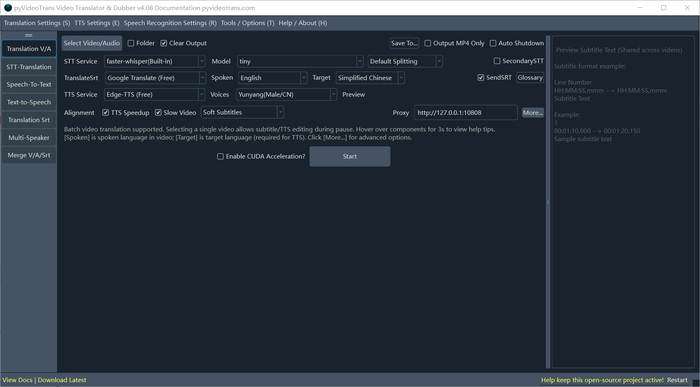
Тыкался мыкался, взлетело тяжело, и не так как я рассчитывал. Она конечно всё перевела. Но во 1 прям очень плохо, во 2 звук мне пришлось сводить потом вручную. Согласитесь для того что бы посмотреть видео с русским дубляжом, слишком много возни.
Ну и так как количество видео убавилось на 1, а впереди их было много и в планах ещё больше. Я решил что надо исправить недоразумение и собрать что-то своё. Благо нейронки позволяют.
Так родилась идея, родить фабрику по переводу видео. Мы на вход кидаем видео, выбираем настройки, нажимаем старт, уходим, возвращаемся и получаем готовое видео.
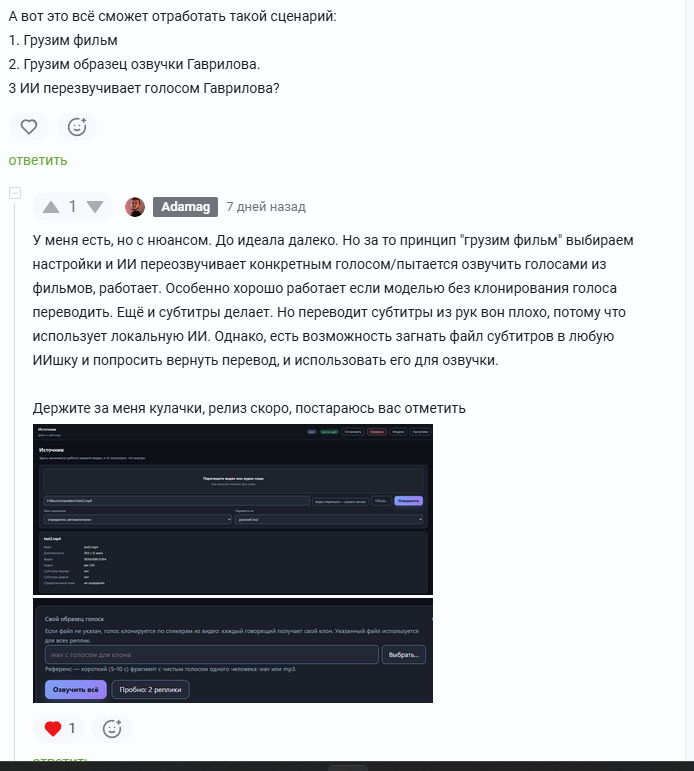
А тут ещё на пикабу (@Magor15, как и обещал, я тебя тегаю.) задал вопрос про простой сценарий. На что я справедливо решил, что такая идея вероятно все же имеет спрос.
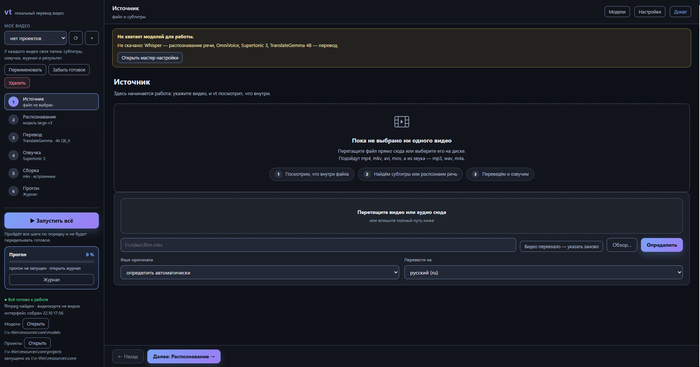
К тому моменту программа была готова где-то наполовину. Я выбрал самые стабильные модели из возможных.

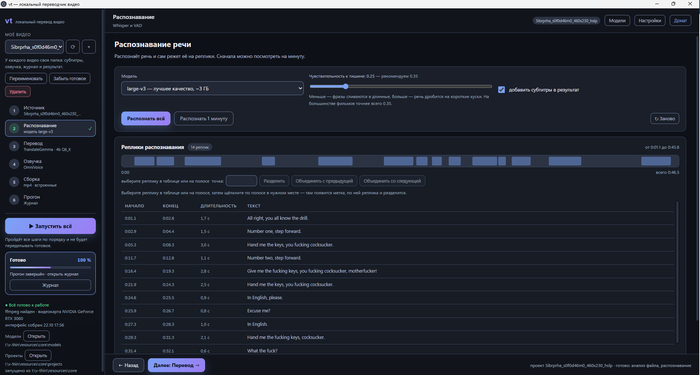
И всё шло хорошо. Whisper хорошо определял текст, алгоритмом мы их размечали и получалось меньше 1% промахов в распознавании и разметке реплик. Что мотивировало работать дальше.
Из принципиального, хотелось иметь возможность закольцевать пайплайн локально. Для чего потребовалась LLM как переводчик текста. По началу я использовал qwen на 8b параметров, но во 1 он был квантованный, т.е. сжатый, и работы по переводу не специализированной моделью, занятие честно не благодарное. Поэтому я пошерстил информацию и обнаружил TranslateGemma 4B, более скормная модель, из плюсов, в нашей сборке она почти без квантования, и потому работа переводчика у неё лучше. Но опять же с оговоркой, что на высокую художественность тут расчитывать не стоит. Однако. После распознания речи, у нас генерируются субтитры на языке оригинала. И тут есть некоторый фокус, если хочется больше художественности.
Мы просто отгружаем srt файл с субтитрами в любую топовую нейросеть, прямо в чат, и просим красиво перевести. Результат получается кратно лучше, высокохудожественно, но немного не автоматизированно.
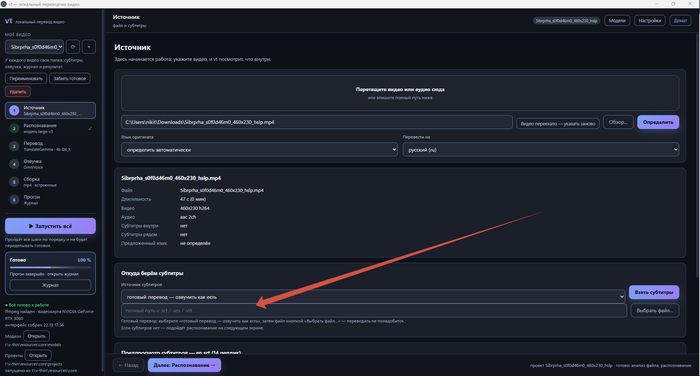
И после этой манипуляции выбираем в настройках "Только озвучить" подтягиваем полученные субтитры и смело озвучиваем выбранной далее нейросетью для озвучивания.
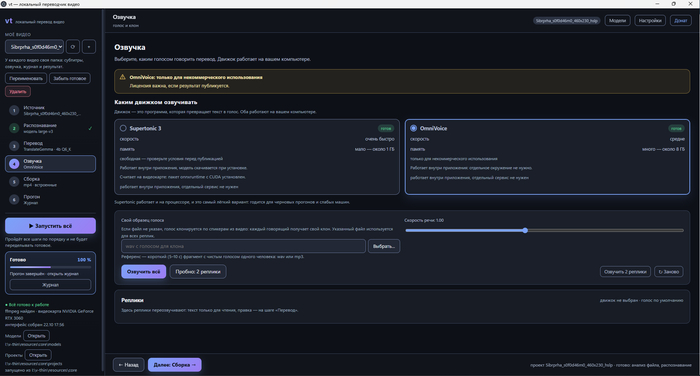
И тут мы подходим к этапу который съел больше всех времени. На выбор для озвучки есть две нейросети. Supertonic, простой как палка, есть пачка предобученных голосов от самого поставщика, работает как на процессоре так и на видеокарте, достаточно шустро. С ним было буквально 0 проблем, он работает с самой первой версии.
А вот его коллега OmniVoice, мммм, сколько нервов он мне промотал. Фокус в том, что omnivoice умеет клонировать голоса. Но для этого ему нужно хотя бы 10 секунд чистого звука. А если вы озвучиваете длинный фильм, то их надо правильно достать и отдать ему. Ошибок было много. О них я расскажу в следующих постах. Пока в общем.
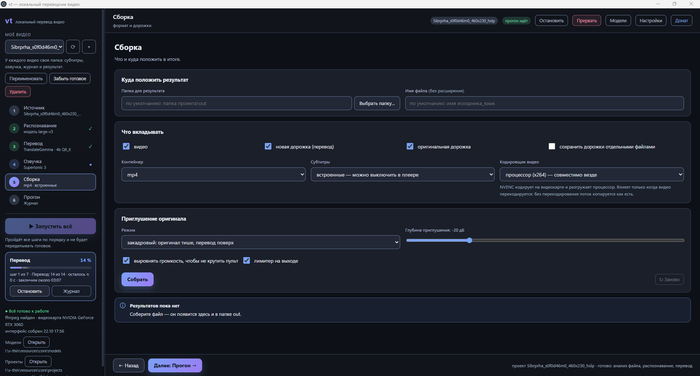
Финальный штрих, который закрывал мою боль, это автоматическая сборка. Т.е. после озвучки, нужно было её добавить в оригинальное видео. А т.к. озвучка у нас идёт в чистом виде, без фоновых звуков фильма, нужно было применить алгоритм приглушения оригинала, который вставлял переведенную фразу в тайминги оригинала, и заглушал оригинальную дорожку.
И в итоге я получил готовое видео, переозвученное на русский язык. Да, результат далек от фантастики. Но если желание посмотреть видео с переводом сильно выше, чем желание ждать дубляж. И есть хотя бы rtx 3060 на 12 гб, то у меня есть что вам предложить :) Кстати вы можете оценить работу озвучивания supertonic вот в этом посте
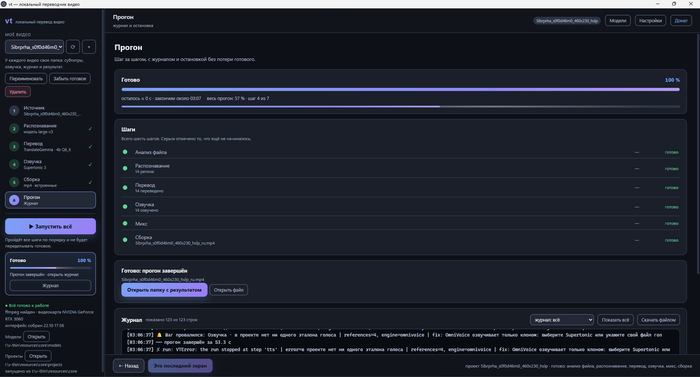
Что по итогу. Работает всё. Я бросил все силы на то, что бы максимально отладить функционал. На моём пк, всё работает великолепно. И потому я предлагаю вам присоединится к бета тесту функционала. Однако должен предупредить, интерфейс пока болезный. Доверять полосам прогресса нельзя. Поэтому я дальше вам дам немного известных багов, а вы будете их иметь в виду во время пользования.
Если программа будет пользоваться спросом, интерфейс я приведу в порядок, но лично мне такого костыльного интерфейса хватает. Там не очень много проблем на самом деле.
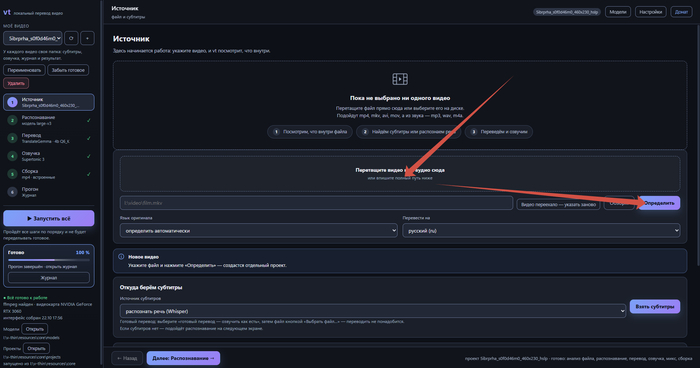
И самая первая проблема в обманчивом окне для перетаскивания видео. Бросаем видео во вторую зону, а потом ОБЯЗАТЕЛЬНО нажимаем кнопку Определить. Всё, у вас создаётся проект для видео и вы можете выбирать модели, настройки и запускать. Это ключевая ошибка интерфейсная, на которой можно жестко споткнутся.
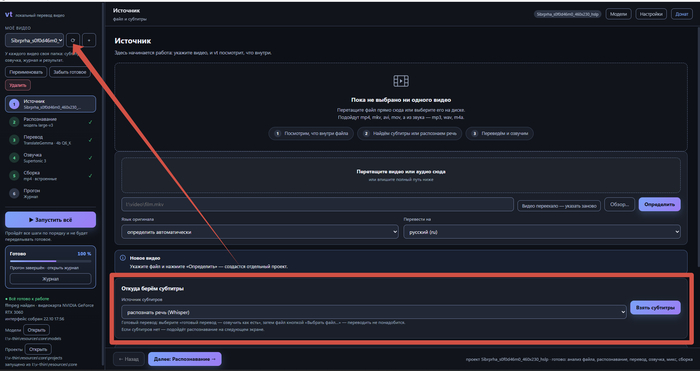
Ещё буквально пока писал пост обнаружил что окошечко "Откуда берём субтитры" может не появится, если ещё ни одного видео не перевели в принципе. Переводим одно видео, жмём несколько раз на кружок со стрелочкой, это обновляет интерфейс. И окошко должно появится.
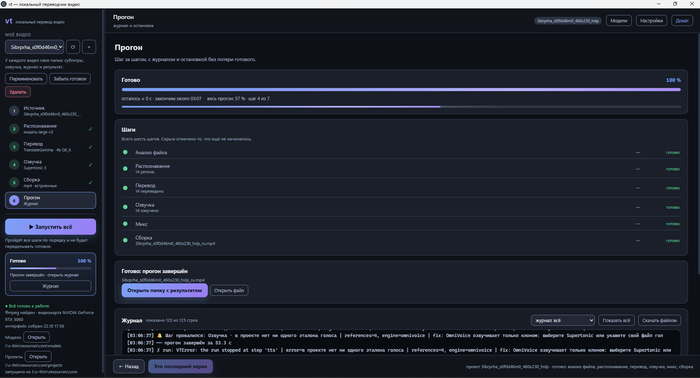
Ну и финальное, что полосы прогресса отображают хрен пойми что. Внизу есть журнал, когда прогон закончится, у вас появится уведомление о завершении. Просто не обращайте внимания.
Архив с программой весит чуть больше 1 гб, после распаковки, установки и скачивания моделей распухнет до 15+ гб, имейте в виду. Для комфортного пользования рекомендуется хотя бы RTX 3060, модельки небольшие, на каждом этапе выгружаются. Я постарался максимально всё оптимизировать в этом месте. Если будет возможность, поделитесь на каком железе запускали и как прошло.
Спасибо что прочли, ссылочка на vt - переводчик видео.
P.S. Программа кстати бесплатная, предоставляется as is, все модели вы скачиваете из их оригинальных источников, для этого вам предоставлен мастер для скачивания, коммерция и клонирование чужого голоса без согласия запрещены. Подробную информацию о моделях можете прочитать на их оригинальных сайтах.
И это был маленький апдейт по моему переводчику видео. На этот раз я отладил распознавание и деление на реплики, на том и остановился в разделе распознавания. Поменял перевод на специализированную модель (спойлер, помогло в ресурсах, в факте, переводит всё ещё говяно, поэтому перевод писал сам.)
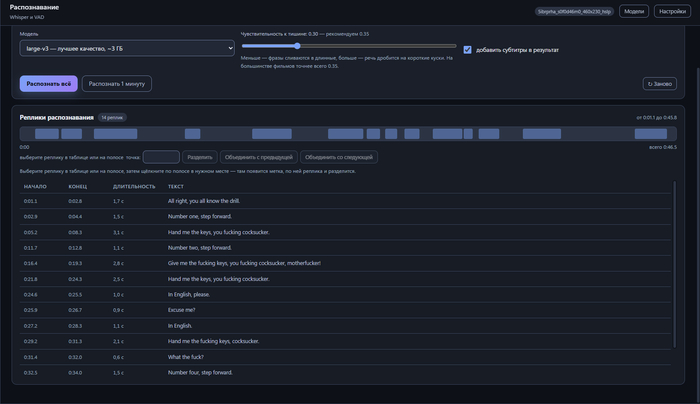
В принципе, есть вариант оставить одну модель для перевода, и упростить жизнь. Так как есть редактор переведённых реплик и там можно заморочится на вольный художественный перевод самостоятельно по приколу, либо оставить как есть, если не приниципиально.
Озвучка работает всё так же хорошо. Так как окончательно победили распознавание и разметку фраз, возможно модель с клонером будет теперь работать сильно качественнее, но признаюсь честно, ещё не тестировал.
Такие дела. Кому интересно, тому спасибо за интерес и подпски.
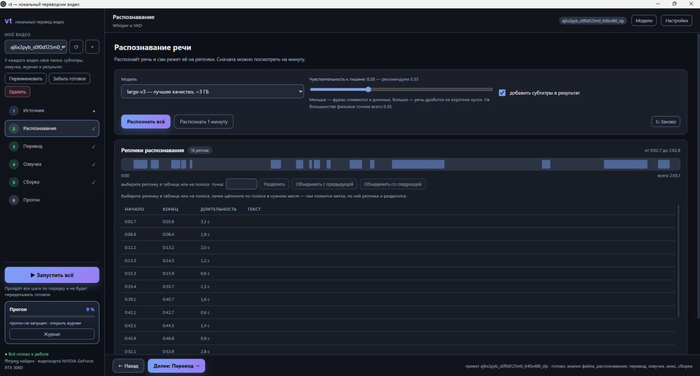
таймлайн распознанных текстов
Мне пришлось учился пользоваться своим же переводчиком
Короче из ключевых проблем что скорее всего не решиться, whisper large-3 бедолага, не смотря на всё качество определение реплики, разметить их по нему крайне непростая задача.
Я добавил таймлайн, но редактор для него полноценный ещё не сделал. На сколько это будет надо, покажет желание пользователей уже. Я пока думаю что это не самое приоритетное направление.
Локальный перевод вообще практически не имеет смысла, ресурсов жрёт тонну, а выход хуже чем в googletranslate просто. Это не смотря на то, что разработан алгоритм для перевода с "контекстом", а не просто в тупую. Вот это более важное направление и я думаю его добивать.
По этой же причине пришлось добавлять озвучку без генерации субтитров. Чисто взял готовые и бросил озвучивать.
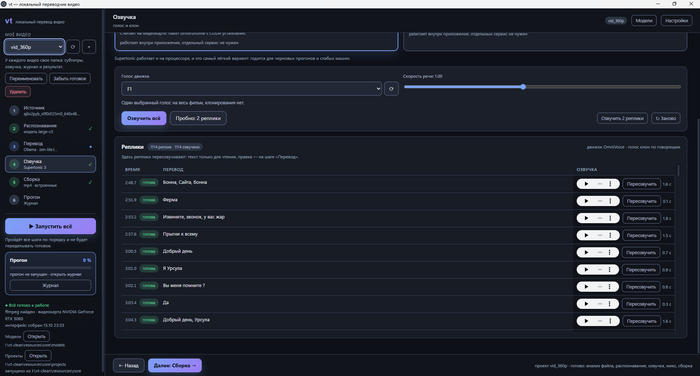
Окно озвучки
И вот озвучка и обратная сборка, работают на 10 из 10. Модель не клонирующая голос взлетела на 3060 12 гиговой и даже не вспотела. Модель с клонером это отдельная песня, она хорошо всё делает, но в фильме должно быть достаточно качественных реплик для клонирования голоса, иначе алгоритм будет озвучивать либо тем что сможет склонировать, либо озвучит стандартным своим голосом.
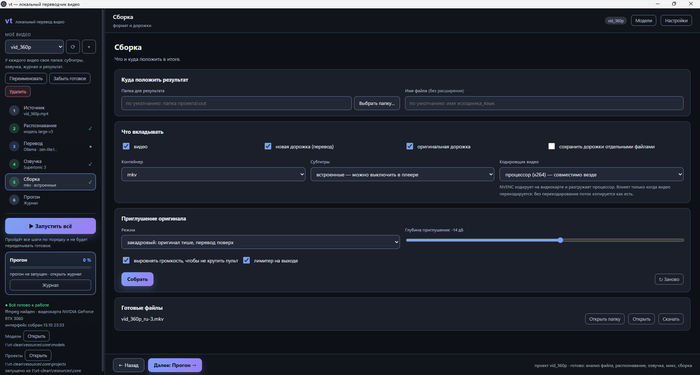
Окно сборки
Хорошо отработал алгоритм глушения реплик, так называемый "дакинг".
Короче для озвучки кино по готовым субтитрам вообще 0 проблем. А короткие ролики вполне себе можно и с авторазметкой даже делать.
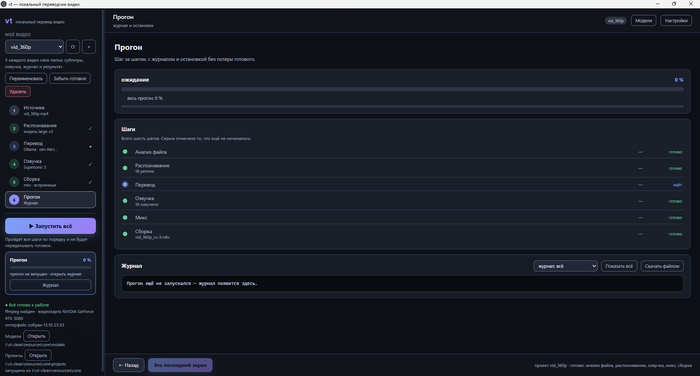
По ощущениям достигнуты цели где-то на половину. Думы думаю, стоит ли уже релизить или ещё пошлифовать бедолагу в области перевода. Потому что это по сути самое узкое место сейчас.
Оценить озвучку можете вот тут
Сразу отвечу на вопрос зачем я это делал. Мне надо было быстро перевести видео локально, без претензии на озвучку по ролям, все что я нашел это pyvideotrans. И он мне совершенно не понравился. Вот и всё. Релиз на вот вотах, даже если не получится улучшить перевод, БЕСПЛАТНОВО, не претендую на золотые горы в этом проекте. Надо было мне, но вдруг кому ещё подойдет, у кого непритязательные взгляды в отношении озвучки :D
Не Леонид Вениаминович конечно, но что есть.
Это если что я насобирал программулину для перевода видео нейронками, и пока дебажил его, наткнулся на оригинальный пост где люди просили перевода. Ну и оно само как то сложилось.
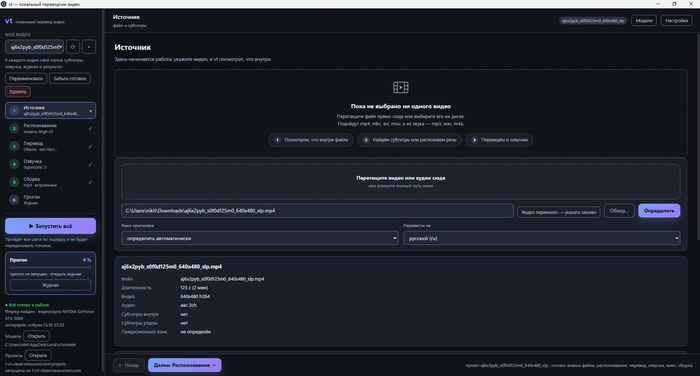
Программулину скоро выложу, будет бесплатновое, хотите подпишитесь что б на релизе поймать, не хотите, как хотите.