Сайт открывается, заказы приходят, ошибок не видно. Это ещё не означает, что серверное ПО можно оставить как есть. Особенно когда разработчики PHP выпускают срочное обновление безопасности.
Я обслуживаю сайты и уже развернул исправления примерно на ста из них. Ниже — памятка для тех, у кого есть интернет-магазин, корпоративный сайт или старый проект на PHP, но нет желания разбираться в устройстве уязвимостей.
Что произошло
21 октября 2026 года разработчики PHP выпустили исправления двух критических уязвимостей: CVE-2026-109618 и CVE-2026-109619. Они могут приводить к удалённому выполнению кода без входа в учётную запись. Проблема находится в PHP: обновить только CMS или поменять пароль администратора недостаточно.
Исправленные релизы соответствующих веток: PHP 8.2.35, 8.3.36, 8.4.27 и 8.5.12. Это минимальные исправленные версии для этих двух уязвимостей, а не обещание отсутствия всех других проблем. Официальное сообщение: https://www.php.net/archive/2026.php
Первый вопрос: какой PHP действительно обслуживает сайт?
Вывод команды php -v показывает версию запущенного консольного PHP. Веб-сайт может работать через другой PHP-FPM, другой контейнер или отдельную настройку панели хостинга. Поэтому ответ «я проверил PHP по SSH» сам по себе ещё не закрывает вопрос.
На обычном хостинге стоит спросить поддержку: какая сборка обслуживает мой домен, включены ли исправления этих двух CVE и перезапущены ли обслуживающие процессы? Если провайдер переносит исправления в старую версию пакета, попросите ссылку на его бюллетень: один номер версии без сведений о пакете может вводить в заблуждение.
На своём сервере нужно сопоставить домен с обработчиком PHP и проверить именно его. В Docker — проверить работающий контейнер, а не только имя образа в compose-файле. После замены сборки важно перезапустить все затронутые воркеры и проверить результат.
Если проект застрял на PHP 7.4 или 8.1
Здесь две разные задачи. Первая — закрыть конкретные известные уязвимости. Вторая — перенести приложение на поддерживаемую версию PHP, разобраться с несовместимыми плагинами, библиотеками и старым кодом.
Бэкпорт — это перенос определённого исправления в старую ветку. Он может дать время на миграцию, но не возвращает этой ветке полноценную поддержку и не закрывает автоматически остальные уязвимости. PHP 8.1 и более старые ветки уже не получают обычных обновлений от проекта PHP; для этих двух CVE команда опубликовала минимальные исходные бэкпорты.
В нём есть сборки PHP 8.2–8.5 в вариантах CLI, FPM и Apache, наборы расширений для разных приложений, а также сборки бэкпортов для 7.4 и 8.1. Ограничения и актуальные теги описаны в README. Это мой проект, не официальный образ команды PHP. Использовать его необязательно: сначала можно проверить исправленные пакеты своего поставщика или подходящий официальный образ.
До изменений нужны резервные копии файлов и базы с понятным способом восстановления, список расширений PHP и план возврата к предыдущей конфигурации. Большой переход между версиями лучше сначала проверить на отдельной копии приложения.
После обновления мало открыть главную страницу. Проверьте вход, формы, загрузку файлов, поиск, отправку почты, фоновые задания. Для магазина — корзину и оформление заказа в тестовом режиме. Посмотрите журналы ошибок. Если обнаружена несовместимость, план отката помогает восстановить работу, но возврат к уязвимой сборке не решает проблему безопасности.
Если нужна помощь
Если у кого-то из пикабушников возникли проблемы с обновлением PHP или запуском этих образов — пишите, могу помочь разобраться. Это касается и Docker, и обычных серверов. Опишите в комментариях, что не получается, какая у вас версия PHP и как размещён сайт.
Также можно написать мне в Telegram: https://t.me/stufently — @stufently. Пароли, ключи и дампы баз не публикуйте и не присылайте вместе с первым вопросом.
Если у вас уже есть администратор, эту памятку можно просто передать ему. Главное — получить проверенный результат для работающего сайта, а не только новый номер версии в отчёте.
Обновление 23.10.2026
В PHP 8.4.27 и 8.5.12, закрывших PHP2Shell, обнаружена регрессия php-src#24488: SimpleXML-объект после get_object_vars(), приведения к массиву или json_encode(), попавший в цикл ссылок под сборщиком мусора, может уронить процесс с ошибкой «zend_mm_heap corrupted». Проблема воспроизведена на официальных сборках 8.4.27 и 8.5.12; 8.3.36 и 8.2.35 не затронуты этой регрессией. Это падение воркера (DoS), не удалённое выполнение кода (RCE). Однострочный фикс f9634847 уже находится в ветках PHP-8.4 и PHP-8.5, но на дату этого обновления ещё не вошёл в релиз.
Наши образы https://github.com/stufently/php-patched-images уже пересобраны с этим исправлением: теги 8.4-* и 8.5-*, а также алиасы 8.4.27-p1-* и 8.5.12-p1-*. Наложенный патч указан в ENV PHP_PATCHES и метке org.opencontainers.image.php-src.patches. Патч снимем после выхода 8.4.28 и 8.5.13.
Отдельная проблема — use-after-free в unserialize() при повторном входе из деструктора (php-src#24481). Она есть во всех текущих версиях. PR с исправлением #24551 открыт и пока не слит; upstream не планирует исправлять её в 8.2 и 8.3. Реальный путь атаки — unserialize() недоверенных данных. В наших образах этого исправления пока нет.
Для серверов, где PHP нельзя пересобрать, например с Sury, cPanel или DirectAdmin, существует сторонний модуль Hosted Power php_uploadprogress_guard: https://github.com/HOSTED-POWER/php_uploadprogress_guard (лицензия MIT). Это временный мост. Проект молодой, с 21 октября: устанавливать следует закреплённый проверенный коммит. В наши образы модуль не встроен.
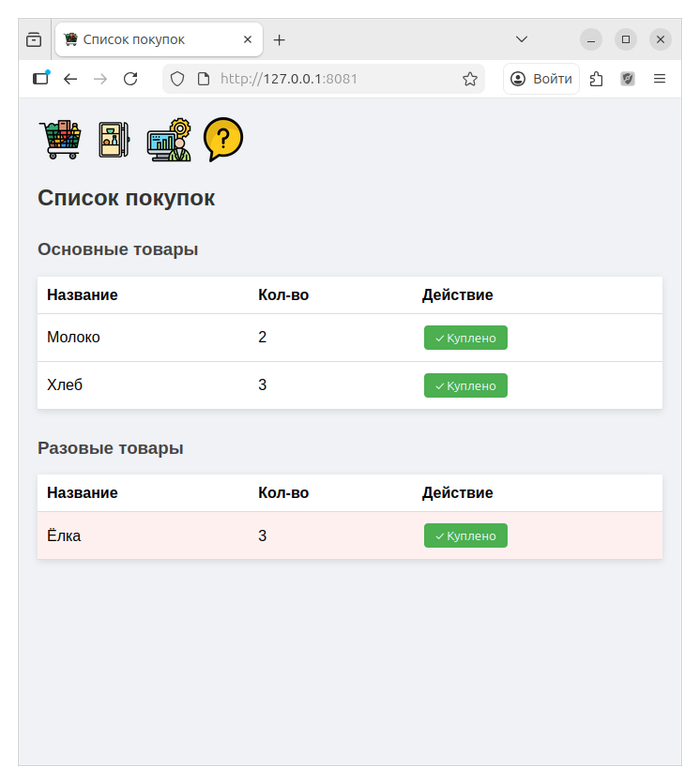
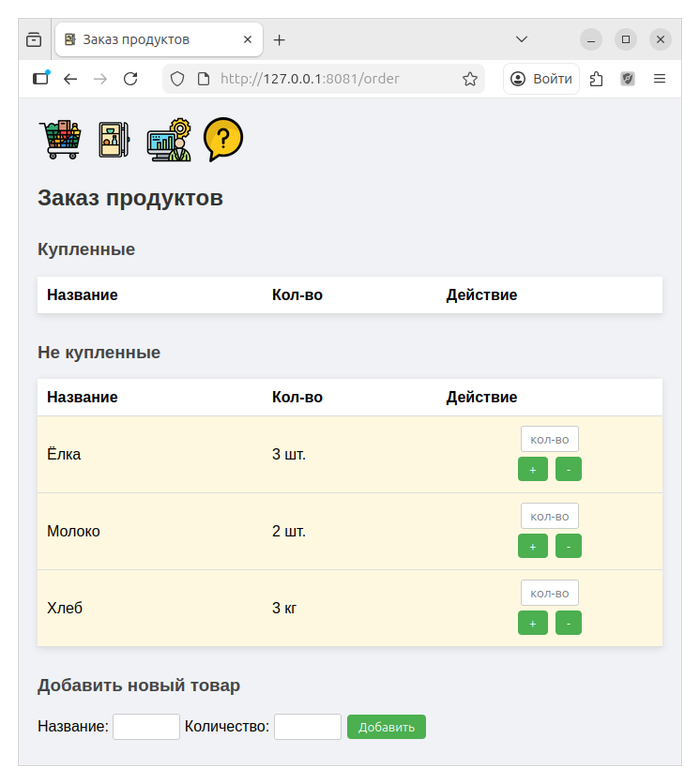
Наверное серия постов будет, или не будет, я вообще только закончил свой пробный первый проект в докере - список покупок с синхронизацией в группе пользователей, с авторизациями, избранным, голосовым вводом, с упором на минимум тапов и максимум удобства, с голосовым вводом, потом с LLM, которая обрезана чтобы из сумбурной речи выдернуть список покупок.
Тута здеся непонятные слова, можно не подглядывать даже.
Технологический стек проекта «Список покупок»:
Backend: Go 1.23, gorilla/mux
База данных: MySQL 8, SQL
Frontend: HTML5, CSS3, JavaScript
Инфраструктура: Docker, Docker Compose, Ubuntu Server 24.04 LTS, VMware
Локальный ИИ: Ollama, Qwen 3 4B
Распознавание речи: Whisper / faster-whisper
Взаимодействие компонентов: HTTP, JSON, REST-подобный API
Голосовой ввод в браузере: MediaRecorder, WebM/Opus
Администрирование и эксплуатация: Linux, systemd timers, автоматическое резервное копирование MySQL
Естественно я с помощью chatgpt писал, но это была боль, про которую я хотел просто рассказать и поделиться впечатлением и тем как добавлял всякие фишечки, как оно чуть ли не из хелловорлда стало тем, что как по мне не стыдно даже показать.
Для начала, коротко вводная. Последние уже пару лет курьером работаю, то в самокате, то в яндексе, даже пост писал про это, но забыл пароль от аккаунта, и даже почту через которую входил. Так что пост будет от "Пикабушника 20 секунд". Если что погромирование я в школе только изучал - там паскаль был, всякие устройства ввода-вывода, потом тетрис на паскале, попытки в какую-то симуляцию гравитации. Один раз еще были попытки подружиться adnroid studio - но не срослось. С тех пор я максимум там эникей - чуть лучше мастера по обьявлению.
Начну вообще сильно сначала, как я до такого докатился от курьерства. Так случилось, что наткнулся сначала на пост, что как обновление компа можно занедорого взять какую-нибудь китайскую материнку с xeon на 28 ядер и 32гб ddr4. Подумал, присмотрел на маркетплейсе, получил, собрал вместо своей сборки на селероне, воткнул туда свою lowprofile geforce 750 4gb, да NVME. Как-то на этой сборке даже KCD2 прошел. Но сидел, и не понимал, а на кой мне эти 28 не самых быстрых ядер? Посмотрел игрульки которым бы это пригодилось - да не особо, кроме stellaris (нравится как времяпровождение вечером). Подумал еще - ну можно виртуалки поднять типа win serv, попробовать себя в доменах, да тоже без задач не прёт - непонятно что и зачем делаешь. Спросил у chatgpt, а он мне говорит - чувак, ты девопс будущий, сиди докер изучай. Я на тот момент о Docker знал что это такой синий кит для айтишников, а у девопсов положено фурсьюты носить. И что там можно на уаленке работать и деньги даже за это получать.
Штош, началось обучение. Накатил Убунту, под руководством уже устаревшего ChatGpt 3.5 вроде бы, началось - поставить докер, всё окружение к нему, какой-то go, всякое остальное, чтобы я свой первый Hello World увидел в окошке браузера на 127.0.0.1. Далее был затуп. А что можно сделать, что-то реальное, что бы я мог сам использовать. Пока думал - пытался через chatgp попробовать сделать в браузере древнюю новосибирскую забаву gopnik.exe (из промпта в начале был только readme и копипсата "игрового" процесса). Ну увидел, что через жопу, но оно работает так.
Вспомнил, что у родителей часто было такое, что регулярно им надо было согласовывать что надо в супермаркете домой купить. Каждый раз звонки - это надо? А хлеб надо? А что-то еще кончилось? Каждый раз уточнения и всё время по кругу. Решил - сделать какой-нибудь список покупок онлайн. Но так, чтобы тапов по экрану было минимум. Чтобы то что постоянно берут можно было в пару тапов отметить, что-то из редкого - вписать на раз. А в магазине это сразу увидеть и тоже отметитить в один тап, что куплено. Ну и началось.
Я скриншотов не делал особо, не думал что пост буду писать
А началась жопа. Из html у меня были только совсем основы, когда еще в школьные годы пытались свои странички рисовать в web 1.0. Накидал полукилометровый промпт в чатгпт, что я хочу, как оно должно работать, всё остальное - и получил результат - он мне сразу скинул почти готовое решение в несколько файлов. Я подкинул их - вроде даже что-то работает, кнопочки жмутся, количество увеличивается.
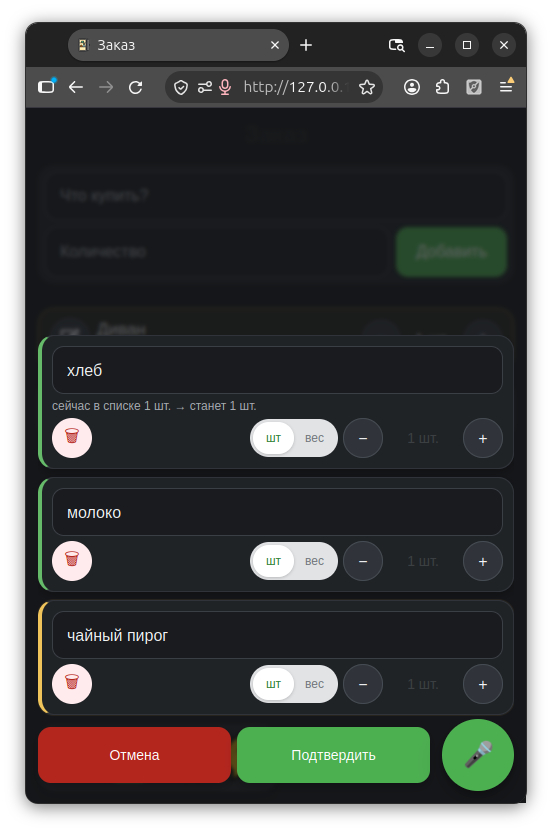
Это оно в начале так выглядело
Но оно же не могло заработать с первого раза. Я первый раз вообще писал в окошко ИИ что я хочу, он ловко отвечал, что нужно поменять какую-то функцию, или перепиши там в css чтото. А я вот эти ваши питоны от go не отличаю, а тут сразу в разных места и sql и go и js и css и html и json и всё это непонятное. Но хуже того, я кидаю в чат все файлы разом (они тогда еще влезали в окно контекста, но только единожды) и этот ваш ИИ начинает мне переписывать их. Вот ваши файлы с функцией онлайн обновления списков - если добавили на одной странице, где заказ делать, хлеб, то на странице с которой в магазин идти - там тоже будет хлеб, причем сразу. Но только что-то докер не собирался. Я кидаю ошибку в чат - а chatgpt мне - да, точно, как филигранно написан у вас код, но вот только версии go друг с другом несовместимы. Просто исправьте на более новую, вот команда в консольку.
Я меняю, компилтся и на следующей итерации, он опять пишет на другой версии go. Ну ладно. Через эти попытки, постоянные уточнения что ему нужно делать и на какой версии приходим так скажем к версии, которая хотя бы работает
Работает так, что у меня порт через роутер проброшен наружу, я белым айпишником свечу в интернет, любой може зайти и увидеть и править список покупок, технологический стек безопасности "неуловимый джо".
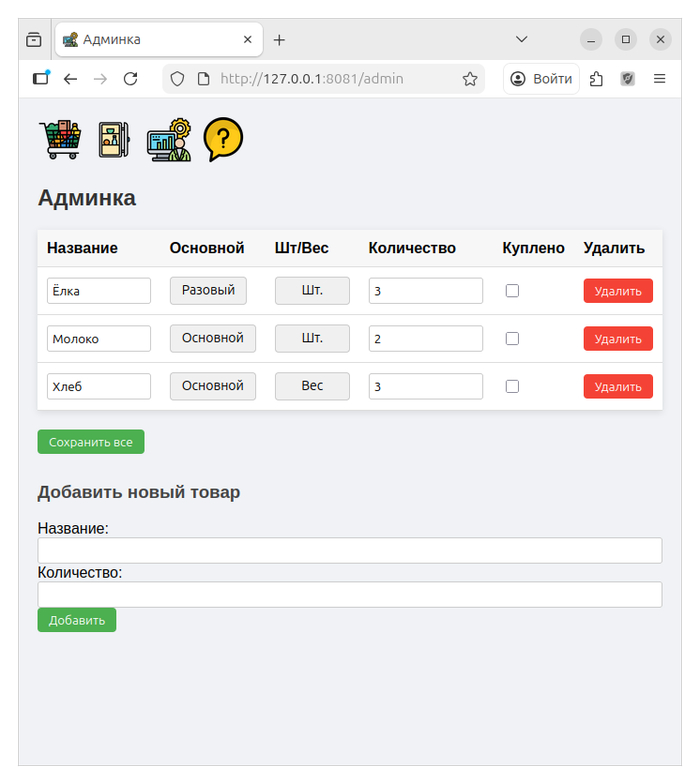
Админка стала не нужна - вся стала жестами, тапами, свайпами
Окей, я за это время немножечко наловчился - кидать не весь порект разом, а промпт был уже более технологичным - вот те файл, вот дерево файлов, вот что я хочу сделать/что не работает - он правил. Правда через полчаса уже забывал свои функции, и это как с бухим в усмерть друганом общаться - он забывал наглухо вообще что сделали, как сделали - одно чинил, ломал всё остальное. То разметка сьедет, то кнопки не жмутся, то вообще компиляци не происходит. Тем не менее, этот процесс был быстрее, чем если бы я сам сел что-то писать. Вайбкодинг как есть.
Ну и когда оно примерно так начало работать - я такой думаю - а может я в домовой чат скину, чтобы там соседи попользовались, может кто спасибо скажет. Но для этого надо хотя бы чтобы разные пользователи были. И это была фатальная ошибка что будет просто. Естественно, для этого надо было сначала переписывать как у нас сама база товаров работает, потому что пользователями там и не пахло. А значит что это алкоgpt мне похерил вообще все на первой же попытке. Я пару дней пытался чтобы у меня обратно что-то работало.
Вот с этой плюшкой, чтобы в один жест можно было купить не все товары сразу, а часть я провозился часов 5-6, чтобы оно на телефоне работало.
Яже погромист - я в дефолтном терминале код делал. Я VS Code на прошлой неделе поставил, но про это в следующем посте. Я нихера не понимал вообще что сломалось и где и как смотреть и как чинить. Было обидно, и я почти забросил это на какое то время. Но потом увидел новость про версию chatgpt поновее, да откопал в архивах убунты примерно последнее что у меня не работало и решил продолжить прогресс, ведь планов было - громадье. Ну и за примерно неделю вывел несколько в более удобный вид уже считай сервис.
Кстати, одна из штук, которая мне больше всего зашла как задумка - это реально голосовой ввод просеяный через LLM - он всё что угодно понимал и в список переводил, я почти день только промпт нужный допиливал. А вот и тестовая фраза для промпта, чтобы он учел всякое и лишнего не нёс.
Так, запиши, пожалуйста, что надо купить, а то я сейчас всё забуду. Значит, молока возьми три бутылки, хотя нет, не три, две хватит. Хлеба батон обычного и ещё один нарезной, если нарезного не будет, тогда второй обычный. Яйца десяток... нет, стоп, яйца не бери, я только что увидела, что у нас ещё две упаковки есть. Грибов возьми немного, ну килограмм, наверное, хотя если шампиньонов нет, можно вешенки.
Ещё надо что-нибудь к чаю, только не слишком сладкое — ну там печенье, вафли какие-нибудь, короче сам выбери. И для пиццы всё, потому что вечером будем делать пиццу. Тесто я вроде сама сделаю, мука дома есть, сыр тоже кажется есть, надо посмотреть. Колбасу возьми, помидоры возьми, а, нет, помидоры не надо, они у нас есть. Огурцы тоже не бери, я их сначала зачем-то сказала, не знаю.
А ещё на завтра хочу пельменей налепить, поэтому возьми муку, мясо трёх видов и минералку. Мясо — ну говядину, свинину и курицу, наверное. Хотя курицу можно индейкой заменить, если индейка нормальная будет, тогда курицу не бери. И сметаны возьми, нет, сметану не надо, она уже есть.
Для окрошки всё купи, квас дома есть, картошка тоже есть, яйца мы уже выяснили есть, так что их точно не надо. Колбаса, кажется, нужна. Огурцы нужны. Зелень какая-нибудь. Редиску возьми. И вообще если чего-то важного для окрошки не хватает — добавь сам, но не тащи всякую ерунду.
Ещё коту еды надо, обычный корм, какой-нибудь нормальный для стерилизованных. И наполнитель. Конфет дочке не надо, она вчера сама купила. А свечки для торта возьми, маленькие, потому что торт будем ставить на стол. Хотя торт мы вроде не покупаем, его испечём сами.
И ещё красной рыбы на бутерброды... нет, отбой, рыба осталась после праздника, её не покупай. Масла сливочного пачку возьми. Нет, погоди, масла тоже не надо, его буквально вчера купили. Лимоны два штуки. И кофе, обычный молотый, одну пачку.
Вроде всё. А, чуть не забыл: если будешь проходить мимо овощного, возьми картошки килограмма три. Хотя картошку мы для окрошки уже вроде дома имеем... но три килограмма всё равно возьми, потому что потом пригодится. Всё, теперь точно всё.
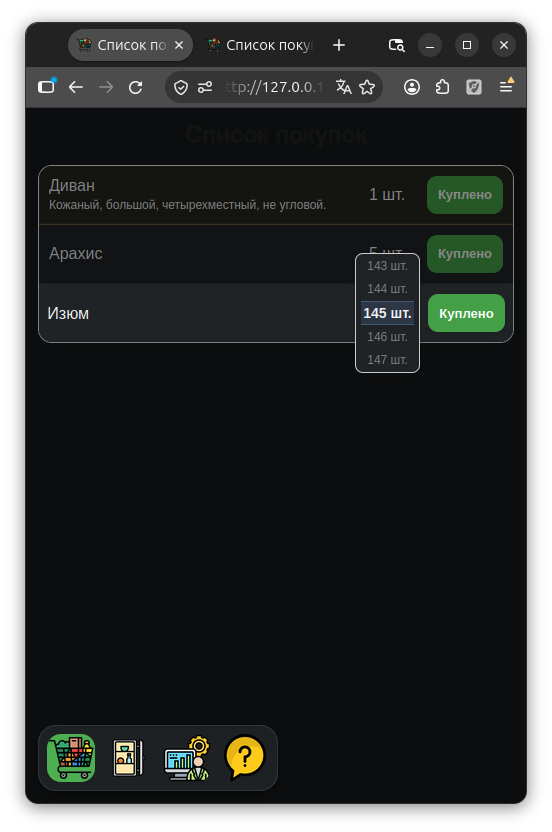
Теперь всё реально удобно, голосовое распознавание есть, тёмная тема, PWA, офлайн режим который помнит список даже на парковке, логины по приглашениям, группы, сейчас следующий этап - это алису прикрутить чтобы вообще без тапов добавлять себе в список покупок, потом динамическую фильтрацию товаров, если списочек большой. И еще несколько приколюх, которые не будут засирать интерфейс, но кажется, что будут удобнее. Единственное, у меня QWEN сейчас на процессоре крутится, и обрабатывает голосовой список несколько секунд, так что если кто хочет попробовать - не ругайте голосовой ввод, я и так постарался, чтобы он не сразу всё отадавал, а по мере формирования списка.
Это мне qwen чайный пирог предлагает к чаю. Нерешаемо на данный момент - qwen поумнее будет отвечать минут по 5.
И да, если кто-то хочет попробовать, у меня там сейчас регистрация по приглашениям, чтобы мой процессор дома не охренел LLM крутить. Напишите, я кину ссылку в личку и код приглашения. Я бы очень рад был любым отзывам.
А то что оно в темном режиме на пикабу похоже - это я случайно увидел, уже когда темную тему доделывал вчера. В следующем посте расскажу уже про то как всякие плюшки для удобства придумывал.
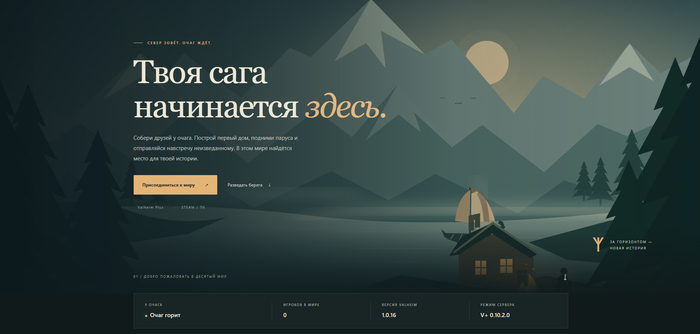
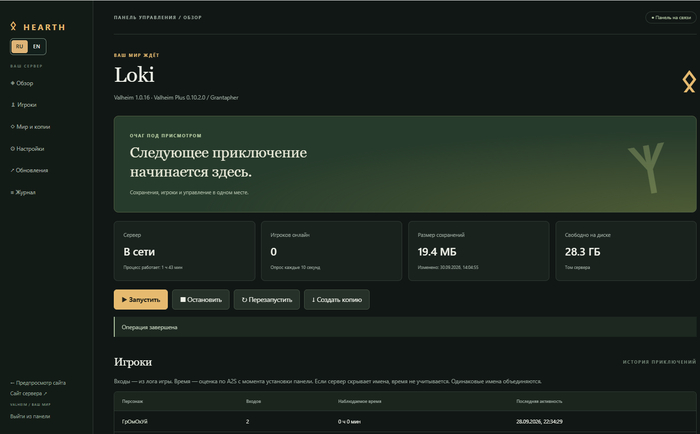
Последние пару недель ковырял свой self-hosted сервер Valheim и в какой-то момент понял, что больше не хочу каждый раз лезть в конфиги, перезапускать контейнеры и объяснять друзьям, как поставить нужный клиентский мод.
В итоге получился Hearth — open-source панель для Valheim-сервера.
Сейчас умеет:
vanilla и Valheim Plus;
мастер первого запуска в браузере;
управление миром и настройками;
резервные копии и восстановление;
безопасное обновление с тестовым запуском и откатом;
перенос мира между серверами;
публичную страницу сервера для игроков;
установщик Valheim Plus для Windows и Linux;
RU / EN интерфейс.
Запуск пока максимально простой:
docker compose up -d --build
Дальше открываешь браузер и проходишь мастер настройки.
Проект свежий, поэтому буду рад любому фидбеку — особенно от тех, кто сам держит dedicated server. Интересно, чего вам обычно не хватает в существующих решениях?
В апреле 2023 года мы запустили необычный для нас проект - ремонтный сервис нового формата. Первого клиента нашли только в начале лета, но уже с первого проекта удалось достичь запланированной прибыли. Расскажу, как мы создали современную компанию для поколения "новых денег", которые не готовы к тому, что прораб будет класть половину стоимости ремонта себе в карман, а сроки растягиваются без ограничений и почему это оказалось прибыльным бизнесом.
Как всё начиналось
Конец 2022 года. Я работал менеджером проектов в крупной IT-компании, мой друг Антон - тимлидом в другой известной технологической компании, а Дима занимал позицию backend-разработчика в третьей. У всех стабильные зарплаты, интересные проекты - жизнь шла своим чередом, пока Антон не решил купить квартиру в новостройке.
После долгих поисков он остановился на 85-метровой квартире в ЖК около метро Саларьево - современный комплекс с подземным паркингом и зелёным двором. Как типичный программист, к поиску ремонтников он подошёл педантично: изучил десятки предложений, провёл собеседования с кандидатами. В итоге выбрал бригаду с Авито с "15-летним опытом работы".
Денис (это я:) - один из создателей сервиса
За время ремонта у Антона мы с Димой часто приезжали к нему - помочь, посоветовать, и просто поржать над очередными косяками строителей. У нас обоих за плечами был серьёзный опыт управления командами, внедрения процессов, автоматизации и контроля качества. И знаете что? Нам казалось, что главное в ремонтном бизнесе - это грамотный менеджмент и организация процессов. И на самом деле, все примерно так и есть.
День когда мы решились
Если честно, мысли о собственной ремонтной компании появились у нас задолго до этого случая. В IT-тусовке часто шутят, что в России есть три верных пути: вебкам, айти и стройка. И мы, насмотревшись на хаос в ремонтной сфере, не раз обсуждали возможность открытия своей “фирмы”.
Мы выделили основные проблемы, которые должны были исправить с помощью своего сервиса
Первое - это постоянно растущие сметы и "задранная стоимость" на работы. Ну вы серьезно? Почему для меня ремонт в квартире должен чем-то отличаться от заказа носков на Вайлдберриз? Почему-то там нет такого, что цена носков может вырасти в 2 раза за время доставки. А тут начальная смета в 1 миллион превратилась почти в 1,7! И каждый раз это "ой, тут стены кривые", "ой, а тут придется докупить", "ой, а это мы не учли".
Второе - это бесконечно растущие сроки. Это еще хуже. Как люди с опытом в менеджменте, мы прекрасно знали, что растущие сроки – это всегда раздолбайство управления и ленивые рабочие. Но тут было чуть посложнее, об этом чуть позже. У Антона обещали сделать за 4 месяца, а в итоге растянули на 8.
Третье - хитрые прорабы. Это вообще отдельная история. Когда прораб говорит "давайте я сам закуплю материалы, у меня скидки", знайте - он накинет сверху процентов 30-40. А еще есть "срочные работы", которые почему-то не были учтены в смете. И конечно, вечная классика - экономия на материалах: заказываешь одно, а привозят что-то попроще, но по той же цене.
Целевая аудитория
А параллельно с этим мы определили нашу целевую аудиторию. Чтобы выделиться на конкурентном рынке, мы решили ориентироваться на молодых IT-специалистов и представителей “современных” профессий, живущих в Москве в возрасте 30-40 лет. Тех, кто покупает квартиру в новостройке и привыкших к хорошему сервису. Кто не готов, что его будут водить за нос и разводить на деньги.
Что с ценой?
При этом очень важно было держать цены НИЖЕ, чем у других компаний, иначе на рынке просто не выжить. В премиум сегмент нужен "пропуск" в виде большого количества работ для определенного типа клиентов, поэтому нам было понятно, что "брать" много - пока что, непозволительно. Но мы нашли способ: автоматизация процессов, прямые поставки материалов, четкое планирование работ и никаких скрытых накруток. Но несбыточной мечтой это покажется только обывателю: на самом деле сервис и правда должен быть таким, вообще любой.
История первого заказа летом 2023 года
А теперь самое интересное - наш первый заказ. Это была отдельная эпопея. Начало лета 2023, звонок от потенциального клиента.
Первый клиент оказался прямо "в яблочко" - тоже айтишник (пришедший из первой контекстной рекламы в яндексе запущенной на 20 тыс.), работал в крупной компании, купил двушку в панельке 80-х годов. Причем достаточно убитую - стены местами с дырками, старый паркет, трубы помнящие еще Горбачева... Но нам, если честно, даже повезло что первый объект был не новостройкой. На старом фонде учиться легче - там хотя бы есть на что посмотреть, в отличие от новостроек, где все "сюрпризы" спрятаны в голых стенах.
Дырка в стене была ДО демонтажа. Клиент купил квартиру с "убитым" ремонтом подешевле, в надежде сэкономить
Как мы мастеров искали
Начали с поиска бригады. Вот тут был первый холодный душ - оказалось, что найти классных специалистов без своей наработанной базы очень сложно. Мастера хорошего уровня либо уже при деле, либо просят космос. А те, кто сразу соглашается - ну, вы понимаете. За две недели провели больше 10 собеседований (назовем их так😊). Причем процесс собеседования мы сразу сделали "как в айти" - тестовые задания, проверка портфолио, разбор технологий работы. Бригадиры были в шоке - некоторые прямо уходили с собеседований, когда мы начинали распрашивать про технологии укладки плитки и показывали фотографии косяков с объектов с форумов.
В итоге нашли бригаду - два брата, которые до этого работали в крупной ремонтной компании, но ушли потому что устали от "серых" схем – по отношению К НИМ ЖЕ. В основном - задержки з/п и прорабы.
В том же санузле, но уже после демонтажных и некоторых черновых работ. Братья очень помогли нам с первым ремонтом, кроме этого, они дали нам контакты проверенных рабочих, которые впоследствии делали ремонт вместе с ними
Купили первый комплект инструмента - это отдельная история на 100 тысяч рублей. Ещё сразу купили свою тепловую пушку - это из необычного. Большинство компаний привлекают "потолочников" на субподряд. Мы захотели сразу начать формировать свой инструментарий для будущих сотрудников. Зато потом эта закупка очень помогла - не зависели от того, что принесет с собой бригада. Позже, когда начали расширяться купили свою штукатурную станцию. Это, на удивление, было самой выгодной покупкой.
Первые сложности
Начали ремонт. И тут поехало... Первый сюрприз - когда начали снимать старую штукатурку, оказалось что стены буквально рассыпались. Плюс под старым линолеумом в коридоре нашли деревянный пол с насыпью под ним.
Тут был первый серьезный разговор с заказчиком. Объяснили ситуацию, показали все фотки, рассказали что сколько будет стоит в соответствии с прайс-листом. Тут очень помогло то, что мы сразу взяли за правило - фотографировать вообще все. Каждый этап, каждый слой, каждую трубу.
С материалами тоже было весело. Первый месяц я лично объездил все крупные строительные магазины в радиусе 30 км. Искал поставщиков, договаривался о скидках. Помню, как чуть не купили партию плитки по "супер-выгодной" цене, а потом выяснилось что это условно "второй сорт" - брак, который продают через "серые" схемы.
Cделали систему закупок: (Первый заказ полностью сделан из материалов, купленных в Петровиче и на маркетплейсах). Бригада присылает список - мы проверяем цены у 3-4 поставщиков и заказываем где дешевле.
Мы сразу внедрили систему ежедневных фото-отчетов и еженедельных созвонов. Плюс сделали чат в телеграме, куда скидывали все чеки, все накладные, все фотки. Такая прозрачность очень помогла - клиент видел, что мы не химичим с ценами и не пытаемся на нем нажиться.
В итоге сделали.
Братья советовали нам недостающих специалистов по ходу ремонта и постепенно, укладываясь в срок мы сдавали клиенту новый и новый этап. Честно, это было не так сложно как казалось в начале, но нужно понимать, что на самом деле, проблем по ходу ремонта и мелких трудностей было ОЧЕНЬ много, просто мы как люди привыкшие, понимали что сейчас это и есть наша работа , за которую нам платит клиент - взять на себя все заботы по ремонту. Но серьезных форс-мажоров не возникало, максимум понервничали, когда внесли предоплату потолочникам, которых нашли по объявлению, после чего они явно начали задерживать сроки, но в итоге, все обошлось. Нам и до этого было ясно, что чем быстрее мы соберем свой , хотя бы, небольшой штат, тем лучше и выгоднее. Но для этого надо быть уверенным в постоянном потоке заказов, что мы на тот момент, не могли себе позволить.
Главное - мы поняли как надо и как не надо. Все закупки только через нас. Все договоренности - только в письменном виде.
По деньгам первый проект получился условно в ноль - не считая наших вложений в инструмент и рекламу. Но мы получили бесценный опыт, наработали связи с поставщиками (если это можно назвать так пафосно) и главное - поняли, что наша модель рабочая, хотя на тот момент не были в этом до конца уверены. Наши сомнения развеяло лето 2023 года.
1/5
Наша первая работа, которую нам помогли закончить "братья", советуя недостающих мастеров на каждый этап работ. Цена работ для заказчика вышла 750 000 рублей. Летом 2023 года, за аналогичный объём работ авитовские бригады просили до миллиона(!)
Сайт и маркетинг или как мы общаемся с клиентами ещё до первого звонка
Кстати, про сайт. Первую версию мы сделали за пару вечеров на Тильде - максимально простую: фотки, цены, контакты. Знаете что? Он у нас до сих пор такой – но с значительно изменённым UI/UX. Я иногда ловлю себя на мысли - вот мы же, можем сделать что-то крутое, с личным кабинетом, онлайн-сметами... Но потом смотрю вордстат, статистику и думаю - а зачем? Клиенты находят нас, звонят, все работает. Иногда лучшее решение - самое простое.
1/2
На главной странице "в лоб" о том кто мы, наши конкурентные преимущества, специализация и примеры работ
1/2
Сразу "ярко" заявляем о действующих скидках. Кроме этого, простым текстом пытаемся общаться с клиентом и убедить его в нашем сервисе, пока что, не общаясь с ним лично - конверсия в лиды увеличилась значительно, но важно, чтобы все предложения были реальны
А вот ворд стат. За последний месяц нас искали 680 раз не считая статистики переходов по прямой ссылке. Доказательство того, что дорогой сайт не нужен. Наш стоит 6 000 рублей в год, а сделан за 20 часов
Примеры лучших работ как маркетинговый инструмент
1/4
Оставляли подобные фото с примерами работ и вотермаркой в отзывах к жилым комплексам. Отличный маркетинговый инструмент - сразу определяем нужную ЦА и бесплатно заявляем о себе. Точно знаем, что минимум один клиент был из отзывов яндекс - поэтому работает
Как мы масштабировались и разбирались в проблемах ремонта
Теперь про то, как мы начали разбираться в проблемах ремонта и потихоньку расти. Знаете, за этот год мы много думали - почему вообще ремонтные компании задерживают сроки и не могут сделать работу по первоначальной цене? И нашли несколько интересных моментов.
Первое - сроки. Тут даже копать глубоко не пришлось - сам рынок сформирован так, что клиенты просто привыкли к задержкам. "А, ну это ремонт, тут всегда так" - классическая фраза. Благо тут нам помог опыт организации процессов из айти. Четкие спринты, ежедневные отчеты, календарный план. Работает как часы, если не филонить.
Второе - вечно растущая цена. Вот это было сложнее. В новостройках еще можно точно посчитать, а во вторичке... Но благодаря наработкам этот вопрос стал гораздо яснее. При правильно организации процессов, непредвиденные работы лучше оплатить из своих средств, чем терять клиента. Только так и делается сервис.
Третье - больная тема - воровство на материалах. Тут мы конкретно закрутили гайки. Завели строгий учет, до последнего мешка штукатурки. Прорабам сразу сказали - любая жалоба от клиента на нечестность - это конец сотрудничества. Знаете что самое смешное? Когда начали работать честно, оказалось что маржа все равно хорошая. Просто многие привыкли что надо обязательно накручивать еще и еще.
Неприятные особенности прозрачного сервиса
Большинство компаний, которые начинают работать честно, быстро сдуваются. Потому что сам потребитель привык к плохому сервису. Приходишь к клиенту, говоришь "мы все сделаем четко по смете и в срок", а он смотрит с недоверием - "да ладно, так не бывает". Сейчас в 2024-м ситуация получше, но рынок все еще очень консервативный.
Продвижение или как мы брали “Новую Москву”
Наш любимый Прокшино в Новой Москве - в 2024 году, это самый перспективный район в котором покупатели - наши потенциальные клиенты
Расти начали потихоньку. Сначала сделали специальные цены для новой Москвы - там как раз много новостроек, где мы хорошо научились работать. Потом пошли заказы по рекомендациям. Когда я говорю “пошли” заказы нужно понимать, что это 1-3 заказа в месяц стабильно, что на самом деле, тогда казалось не мало. С рекламой экспериментировали забавно - оставляли визитки в подъездах (да, просто старые добрые визитки!), ставили рекламные ящики у офисов продаж в дни выдачи ключей.
Был случай, когда на одном ЖК поставили такую стойку, а через неделю риелтор оттуда сам позвонил и предложил взять себе процент, если клиент пойдет к нам.
Сейчас берем 2-5 заказов в месяц, (летом было 5 в месяц, если разделить). Большинство клиентов приходят по рекомендациям. Штат за год работы постепенно собрали свой. Трудоустроено 14 сотрудников. Если их не хватало (как летом), привлекали мастеров с которым уже работали раньше, по договору ГПХ. Просили всех регистрировать самозанятость или ИП – это было тяжело, но зато честно платим налоги по Доходы – расходы.
Как устроен процесс
Знаете, что самое сложное в ремонтном бизнесе? Нет, не поиск клиентов и не работа с материалами. Самое сложное - это выстроить систему, которая будет удовлетворять запросы клиента и при этом позволит компании зарабатывать. Мы долго думали над этим и придумали несколько интересных решений.
Начнем с оплаты. Если посмотреть на московский рынок, там забавная система - вроде бы без предоплаты, но это только за первый, самый дешевый этап. А потом - бац, и клиент должен внести 50% от всей суммы. И попробуй не внеси - бригада уйдет на другой объект. Мы сделали иначе: разбили весь ремонт на этапы (их получилось 12 для капитального ремонта), и берем предоплату только за текущий этап. То есть клиент всегда понимает, за что именно платит, и может контролировать процесс.
С договорами тоже интересно получилось. Сначала делали один стандартный, а потом поняли - люди разные, запросы разные. Сейчас у нас три варианта: просто на работы (для тех, кто сам хочет закупать материалы), на работы плюс материалы (самый популярный), и полный пакет с дизайн-проектом. Кстати, про дизайн - мы не держим штатных дизайнеров, работаем с фрилансерами. Так получается и дешевле для клиента, и качество выше - каждый дизайнер специализируется на своем стиле.
Первый образец договора, который ставили на сайт
Расчёт стоимости
Расчет стоимости работ - отдельная история. Когда начинали, было очень сложно. На рынке нет четких цен - один мастер берет 3 тысячи за квадрат стяжки, другой - тысячу, третий вообще говорит "ну давайте посмотрим по факту". Сначала работали по среднему прайсу, но часто уходили в минус по отдельным этапам - то бригада дороже встанет, то материала больше уйдет. Сейчас, когда появились постоянные сотрудники, стало проще - мы точно знаем их расценки и можем давать фиксированную цену.
Материалы
Выяснилось, что в крупных магазинах часто дешевле в сравнении с рынками стройматериалов, особенно если ловить акции. Плюс появились маркетплейсы - там вообще красота по ценам. И главное - полная прозрачность, клиент сам видит все позиции. Если находим материал дешевле - возвращаем разницу. Был случай, когда на керамограните сэкономили клиенту почти 30 тысяч - просто потому что, нашли ту же плитку в другом магазине по акции.
Как работаем сейчас
Сейчас берем 2-5 заказов в месяц, зависит от сезона и сложности объектов.
Процесс обкатан до мелочей: сначала выезд на замер, потом предварительная смета. Если клиента все устраивает - детальный расчет и договор. Дальше начинается самое интересное - согласование материалов, закупки, работа.
Особенности продвижения и подводные камни
С продвижением интересно получилось. Сначала, как все, полезли на Авито. И знаете что? Не зашло. Там своя специфическая аудитория и конкретно у нас, с Авито “ не пошло”.
Свежий пример страницы с авито в категории "Ремонт квартир". Как клиенты определяются с подрядчиком среди тысяч однотипных объявлений - хороший маркетинговый вопрос, который мы решаем, после чего полноценно "зайдём" на авито
Пробовали контекстную рекламу яндекс - тоже так себе результат. Клики дорогие, конверсия низкая. Зато отлично зашла таргетированная реклама в Instagram* (*запрещен в РФ) и реклама в районных пабликах ВКонтакте. Особенно в группах новостроек в ТГ - там как раз наша целевая аудитория.
Но главный канал - сарафанное радио. Причем работает оно интересно. Всегда знаешь , от кого пришли заказчики и проще выстраивать коммуникацию. Есть клиент - он доволен, рассказал коллегам - и понеслось. За три месяца получили еще два заказа от сотрудников той же компании. Выходит такой “корпоративный ремонт”)))
Были, конечно, и провалы в продвижении. Пытались работать с риелторами - предлагали им комиссию за клиентов. Не пошло - у них свои схемы, свои бригады. Пробовали давать рекламу в лифтах, входных группах - тоже мимо, ни одного обращения, но тут скорее из-за того что эта реклама буквально на день.
ИТОГ
Сейчас мы существуем уже чуть больше года и в целом смотрим на ремонтный рынок не так, как раньше. За это время мы сделали несколько важных заметок для себя:
Оказывается, большинство проблем в ремонте - это не технические сложности, а банальная организация процессов. Когда все четко спланировано и каждый знает что делать - даже самый сложный ремонт идет как по маслу.
Мы поняли, почему многие компании "химичат" с ценами и сроками - просто потому что не умеют нормально считать и планировать. Когда все процессы выстроены правильно, можно работать честно и все равно оставаться в плюсе.
Самое сложное - это не найти клиентов или научиться делать ремонт. Самое сложное - это переломить привычку рынка работать "по-серому". И заказчики, и исполнители настолько привыкли к непрозрачным схемам, что честный подход вызывает удивление.
Мы до сих пор учимся. Каждый объект - это новый опыт и новые вызовы (особенно по части коммуникаций с клиентами). Но главное - мы видим, что наша модель работает и пока что, нам удается держать ценник немного ниже рыночного, за счёт того что до сих пор не имеем в найме маркетологов, IT, отдела продаж и менеджеров по продажам. Стараемся нанимать именно рабочих, все остальное можно отдать на аутсорс.
Уважаемые пикабушники, были рады составить для вас эту статью! С любовью, СК Комната
Настройка VPS начинается со сверки: тот ли сервер выдали и кто, кроме вас, может на него войти. После первого входа нужно сверить параметры заказа, подтвердить SSH-отпечаток, создать отдельного администратора, ограничить входящие соединения и сохранить базовые метрики. Установка VPS по этой схеме рассчитана на образ Ubuntu 24.04 LTS с одним администратором. Панель или cloud-init могут менять эти шаги, поэтому некоторые пункты стоит проверять.
Что сделать сразу после получения доступа к VPS?
Для начала сверьте IP, регион, образ и ресурсы с заказом, затем найдите аварийную консоль и проверьте SSH-отпечаток. После входа создайте отдельного пользователя с sudo, подтвердите доступ по ключу во втором сеансе и только потом включайте firewall и запрещайте парольный вход. Для панели или готового образа сначала посмотрите уже открытые порты.
Что приходит после заказа VPS и что проверить до входа
В личном кабинете или письме указаны IPv4, логин, начальный пароль либо открытый ключ, а также IPv6, если он выдан. Сверьте с заказом регион, образ ОС, vCPU, RAM и диск. После загрузки проверьте их командами nproc, free -h, lsblk и cat /etc/os-release. С ошибкой в регионе или тарифе обратитесь в поддержку до размещения своих данных на сервер.
До первого SSH-входа найдите VNC или другую аварийную консоль, а также порядок запуска rescue mode. Это может понадобится, если ошибка в sshd_config или firewall закроет сетевой доступ. Инструкция Aéza по аварийному режиму показывает, где включается среда восстановления. Конечно, сама она не заменит резервную копию.
Пароль из письма нельзя считать постоянным секретом, так как он прошёл через почту и мог попасть в журнал уведомлений. Если после установки VPS доступен парольный вход, используйте его только для перехода на собственный ключ. Когда образ уже принимает заданный при заказе ключ, не включайте пароль ради удобства. Для нестандартного ISO также проверьте контрольную сумму или подпись.
Как подключиться к VPS и проверить отпечаток ключа
В Linux, macOS и Windows Terminal SSH-клиент вызывается одинаково. В примере данные замените на те, что в карточке сервера:
ssh root@203.0.113.42
При первом соединении OpenSSH показывает тип ключа хоста и SHA256-отпечаток.
The authenticity of host '203.0.113.42' can't be established. ED25519 key fingerprint is SHA256:Wq6...K3A. Are you sure you want to continue connecting (yes/no/[fingerprint])?
Не подтверждайте yes, пока не получите отпечаток другим путём. Откройте аварийную консоль и выполните ssh-keygen -lf /etc/ssh/ssh_host_ed25519_key.pub, затем сравните строку целиком.
После переустановки ключ хоста меняется. Если сервер не переустанавливали, предупреждение REMOTE HOST IDENTIFICATION HAS CHANGED требует остановки и проверки через консоль или поддержку. Команду ssh-keygen -R IP запускают только после подтверждения причины. На Windows запись хранится в %USERPROFILE%\.ssh\known_hosts, в Linux и macOS – в ~/.ssh/known_hosts.
Отдельный пользователь, sudo и вход по ключу
Сначала создайте учётную запись и каталог для ключа. Текущий сеанс пока не закрывайте:
На рабочем компьютере создайте ключ ssh-keygen -t ed25519 -a 100, если его ещё нет. В Linux перенесите открытую часть командой ssh-copy-id operator@IP. В macOS и Windows Terminal при отсутствии ssh-copy-id добавьте содержимое .pub в /home/operator/.ssh/authorized_keys через открытый сеанс, затем задайте владельца operator и права 600. Приватный ключ на сервер копировать не нужно. Войдите как operator во втором терминале и выполните sudo -v. После проверки можно продолжать настройку VPS сервера.
Как безопасно перейти с пароля на SSH-ключи?
Добавьте открытый ключ отдельному пользователю, войдите им во втором сеансе и проверьте sudo. Затем создайте конфигурационный фрагмент, который читается раньше остальных, выполните sshd -t и загрузите новую конфигурацию службы. Исходный сеанс держите открытым до повторного входа, а при ошибке исправьте настройки через аварийную консоль.
В Ubuntu файлы из sshd_config.d читаются раньше основного sshd_config, а для большинства директив действует первое найденное значение. Имя 00-local-hardening.conf помещает локальный фрагмент в начало порядка чтения.
sudo tee /etc/ssh/sshd_config.d/00-local-hardening.conf >/dev/null <<'EOF' PubkeyAuthentication yes PermitRootLogin no PasswordAuthentication no KbdInteractiveAuthentication no EOF sudo sshd -t sudo sshd -T | grep -E '^(pubkeyauthentication|permitrootlogin|passwordauthentication|kbdinteractiveauthentication) ' sudo systemctl reload ssh
После sshd -t выполните reload и, не закрывая текущую сессию, откройте вторую новым пользователем. Проверка вторым сеансом важнее самой команды: на Ubuntu 24.04 с сокет-активацией reload может вернуть ошибку, если ssh.service не запущен. Если вход не работает, исправьте фрагмент через VNC и повторите sshd -t.
Запретить входящие и открыть только нужные порты
UFW в стандартном Ubuntu изначально выключен, а в облачном образе пакет и вовсе может отсутствовать. Проверьте его, задайте политики и откройте SSH-порт. Если sshd слушает не 22-й порт, возьмите значение из sudo ss -utlnp.
if ! command -v ufw >/dev/null; then sudo apt update && sudo apt install ufw; fi sudo ufw default deny incoming sudo ufw default allow outgoing sudo ufw allow 22/tcp comment 'SSH' sudo ufw show added sudo ufw enable sudo ufw status numbered sudo ss -utlnp
Перед ufw enable оставьте SSH-сеанс открытым. Второй терминал понадобится, чтобы проверить, как подключиться к VPS при действующих правилах. ufw status показывает эти правила, а ss -utlnp – слушающие сокеты и связанные процессы. Сетевой экран не останавливает сами службы.
Порты 80 и 443 добавляют после запуска веб-сервера. Базу данных, Redis и административную панель не нужно открывать всему интернету только потому, что приложение к ним подключается. Смена SSH-порта уменьшает шум от сканеров в журнале, но не заменяет ключи и запрет входа по паролю. В руководстве Ubuntu по UFW описаны простые правила, однако сетевой экран в панели провайдера остаётся отдельным уровнем.
Docker направляет трафик к опубликованным портам в обход обычных правил UFW. Сервис за обратным прокси привязывайте к 127.0.0.1. Для iptables правила пишите в цепочку DOCKER-USER: она документирована и не перезаписывается при перезапуске Docker. При другом бэкенде фильтруйте трафик в панели провайдера.
Обновления, время, локаль и swap без лишнего тюнинга
Разобравшись, как подключиться к VPS серверу, обновите систему и сверьте часы. Просмотрите предлагаемые изменения, установите пакеты и проверьте, нужна ли перезагрузка:
В стандартной установке Ubuntu 24.04 пакет unattended-upgrades ежедневно применяет обновления безопасности. Сторонние репозитории без отдельного правила он не охватывает, а автоматическая перезагрузка по умолчанию выключена. Ответственного за окно обновлений и перезагрузку лучше всё равно назначить, а результат контролировать по /var/log/unattended-upgrades/.
Для серверных журналов удобно оставить UTC: sudo timedatectl set-timezone UTC. Локаль C.UTF-8 уменьшает расхождения в выводе скриптов, если приложение не требует другой: sudo localectl set-locale LANG=C.UTF-8. Менять локаль ради отдельной команды не нужно, достаточно запускать её с LC_ALL=C.
Swap даёт ядру запас при резком пике памяти. При нехватке RAM этот механизм может вызвать длительные задержки при обращении к диску. Сначала проверьте текущий swap и профиль приложения. Для базы данных или сервиса, чувствительного к задержке, размер и vm.swappiness выбирают после замеров. Если в vmstat постоянно растут столбцы si/so, пересмотрите лимиты или тариф до увеличения swap.
Как доказать, что VPS работает после настройки
Сразу после настройки сервер пустой, и это лучший момент снять базовую линию. Через месяц, когда появится жалоба на медленную работу, сравнивать будет не с чем. Зафиксируйте дату, исполнителя, ОС, ядро, vCPU, RAM, диск и версии утилит. Для CPU сохраните минутный лог mpstat, для диска используйте временный файл, а iperf3 запускайте до своего узла в целевом регионе.
Как проверить безопасность и базовую производительность VPS?
1. Сохраните эффективные параметры sshd -T, правила ufw status numbered и список слушающих сокетов ss -utlnp.
2. Сохраните минутный лог mpstat, запустите fio на две минуты и запишите p50/p95/p99, затем выполните прямой и обратный прогоны iperf3.
3. Приложите конфигурацию, версии и сырой вывод, затем повторите замеры в другое время. Один максимум не считается базовой линией.
fio нагружает диск, поэтому запускайте его в согласованное окно: на основном сервере и на соседних VM нагрузка будет заметна. iodepth=1 показывает задержку одиночной очереди, а не максимальные IOPS при глубине 32. Файл должен помещаться на диске с запасом. В документации fio JSON содержит IOPS и completion latency percentiles, включая заданные p50, p95 и p99.
На собственном контрольном узле запустите iperf3 -s, задайте его адрес в IPERF_HOST и выполните прямой и обратный прогоны с одинаковыми параметрами. Публичный узел не служит эталоном. По официальной документации iperf3 для теста нужны клиент и сервер. Между прогонами не меняйте конечные узлы и их конфигурацию. Сохраните JSON и повторите замер трижды. Оценивайте %steal вместе с загрузкой vCPU: одиночный всплеск не доказывает проблему хоста.
Привязать домен и не ждать TTL вслепую
A-запись содержит IPv4 сервера, AAAA-запись содержит IPv6. Перед добавлением AAAA проверьте маршрут, сетевой экран и прослушивание сервиса по IPv6. Первоначальная настройка VPS также требует проверить, проксирует ли DNS-провайдер веб-трафик и какой IP увидит пользователь.
TTL определяет, как долго резолвер может хранить ответ в кеше. После изменения запросите авторитетный сервер зоны, а потом несколько рекурсивных резолверов. До истечения прежнего TTL часть из них может возвращать старый ответ.
Если ответы расходятся, сравните их TTL с ответом авторитетного сервера. Очистка локального кеша не изменит запись у внешнего резолвера. Для HTTPS дополнительно проверьте сертификат и имя виртуального хоста, поскольку правильный A/AAAA ещё не подтверждает готовность приложения.
Для исходящей почты нужен PTR, который настраивает владелец IP-диапазона. Имя из PTR должно прямым запросом возвращаться к тому же адресу. Требования Gmail для всех отправителей включают согласованные прямую и обратную DNS-записи, а также SPF или DKIM. При отправке более 5000 писем в сутки на адреса Gmail нужны оба механизма и DMARC. Если сервер не отправляет почту напрямую, веб-сайту PTR не нужен.
Что добавить после первого часа: бэкап, мониторинг и сервис
После настройки сервер доступен для эксплуатации. Назначьте ответственных за обновления, резервные копии и секреты, а также зафиксируйте срок реакции на сбой. Без регулярной проверки списка ключей, заполнения диска и бэкапов даже завершённая настройка безопасности VPS быстро устареет.
Бэкапы храните вне VPS и регулярно восстанавливайте тестовую копию. Не стоит путать со снапшотами: они фиксируют состояние на момент создания, но не заменяют независимую копию и журнал восстановления. Частоту выбирают по RPO, а время восстановления по RTO. Для базы данных нужна согласованная копия средствами СУБД или остановка записи на время снимка.
В мониторинг включите доступность сервиса, свободное место, память, срок TLS-сертификата, обновления и дату последнего успешного бэкапа. Пороги задавайте после сохранения базовой линии. Секреты храните отдельно от истории команд, compose-файла и репозитория. Для каждого секрета укажите ответственного и период ротации.
Docker, панели и бэкапы требуют отдельных инструкций: у них разные сетевые правила, каталоги данных и процедуры обновления. Одного администратора и UFW недостаточно для командной работы, персональных данных, публичной БД или требований регулятора. В этих случаях нужны журналирование действий, раздельные роли, MFA, проверенное восстановление и контролируемый процесс выпуска изменений.
Перед размещением приложения соберите паспорт сервера: адреса, способ аварийного входа, ожидаемые порты, место хранения бэкапа, ответственных, команды проверки и условия замеров.
Через сутки после первого запуска повторите контрольные проверки. Убедитесь, что обновления завершились, место на диске не заканчивается, сервис отвечает, а задание бэкапа выполнилось успешно. Считайте, что настройка VPS закончена, когда текущее состояние можно проверить, а порядок восстановления понятен тому, кто будет сопровождать сервер.
еклама. ООО «Аеза Групп», ИНН: 7813654490. erid: 2RanymmyJYT
Система мониторинга конкурирует за те же ресурсы, состояние которых должна отслеживать. Prometheus держит активные ряды в памяти, пишет WAL и регулярно уплотняет блоки TSDB. Grafana создаёт всплески запросов при обновлении дашбордов, а неудачные правила превращают Alertmanager в источник повторяющихся уведомлений. Если сервер выбран только по числу целей, нехватка RAM или дисковых операций обнаруживается уже после запуска. Надёжнее заранее оценить число временных рядов, скорость приёма образцов, срок хранения и профиль запросов. Эти параметры дают основу для выбора CPU, памяти и NVMe, а затем уточняются нагрузочным тестом и наблюдением за самим стеком.
Почему VPS – рабочий вариант под Prometheus и Grafana
Отдельный VPS-сервер подходит небольшим и средним командам, которым нужен контроль над retention, сетевым доступом и версиями компонентов без обслуживания физического узла. По сравнению с managed-сервисом команда сама отвечает за обновления, резервные копии и доступность. Managed-сервис удобнее, если команда не готова обновлять стек и реагировать на сбои самого мониторинга. Выделенный физический сервер становится оправданным при миллионах активных рядов, тяжёлых запросах или требованиях к предсказуемым IOPS, которые конкретный тариф VPS не подтверждает.
Стек лучше отделить от приложений: перегруженный сервис не должен вытеснять Prometheus из памяти вместе с данными о сбое. Но VPS в том же дата-центре или аккаунте не увидит отказ всей площадки. Добавьте независимую проверку из другой сети и внешний контроль получения периодического heartbeat-сигнала. Shared vCPU и общий дисковый контур тоже могут искажать картину, поэтому отслеживайте CPU steal, задержку диска и время выполнения правил.
Resource overhead: сколько реально потребляет стек
Число целей само по себе мало что говорит о нагрузке. Для ориентиров ниже предполагается по 500 активных рядов на цель, scrape каждые 15 секунд, обычные системные дашборды и отсутствие рендеринга изображений. Это около 1,7 тыс., 6,7 тыс. и 33 тыс. образцов в секунду. Диапазоны нужны для первого запуска, после которого ресурсы сверяют с prometheus_tsdb_head_series, скоростью приёма образцов, RSS процессов и длительностью запросов.
Prometheus
50 целей / 25 тыс. рядов: 1–2 vCPU, 2–4 ГБ RAM
200 целей / 100 тыс. рядов: 2–4 vCPU, 4–8 ГБ RAM
1000 целей / 500 тыс. рядов: 4–8 vCPU, 12–24 ГБ RAM
Grafana
50 целей / 25 тыс. рядов: 2 vCPU, 2–4 ГБ RAM
200 целей / 100 тыс. рядов: 2 vCPU, 2–4 ГБ RAM
1000 целей / 500 тыс. рядов: 2–4 vCPU, 4–8 ГБ RAM
Alertmanager
50 целей / 25 тыс. рядов: 0,1–0,3 ГБ RAM, доля vCPU
200 целей / 100 тыс. рядов: 0,2–0,5 ГБ RAM, до 1 vCPU
1000 целей / 500 тыс. рядов: 0,5–1 ГБ RAM, 1–2 vCPU
node_exporter
50 целей / 25 тыс. рядов: обычно десятки МБ на каждой цели; нагрузка зависит от включённых коллекторов
200 целей / 100 тыс. рядов: обычно десятки МБ на каждой цели; расход не относится к центральному VPS
1000 целей / 500 тыс. рядов: обычно десятки МБ на каждой цели; необходимо контролировать длительность scrape
Основную нагрузку от роста числа целей принимает Prometheus. Grafana рассчитывают по числу пользователей, панелей и правил, Alertmanager – по числу активных алертов, групп и получателей.
Prometheus: TSDB, retention и IOPS
По оценке разработчиков Prometheus, постоянные блоки TSDB занимают в среднем 1–2 байта на образец. При 33 тыс. образцов в секунду это около 2,9–5,8 ГБ в сутки, или 86–174 ГБ за 30 дней. WAL, chunks_head и временное место для compaction требуют дополнительной ёмкости. Практический план должен оставлять не менее 20–30% свободного пространства и ограничивать хранение одновременно по времени и размеру.
Уменьшение scrape_interval с 15 до 5 секунд утраивает скорость приёма при прежнем наборе рядов. Ещё опаснее рост кардинальности меток, то есть числа уникальных значений: user_id, UUID и необработанный URL порождают отдельный ряд на каждое из них. Сначала исключайте ненужные метрики и метки, затем увеличивайте интервал там, где минутная детализация достаточна.
remote_write отправляет образцы во внешнее долговременное хранилище, но увеличивает расход RAM, CPU и сети. В документации Prometheus отмечено, что пользователи сообщают примерно о 25% дополнительной памяти, хотя результат зависит от частоты появления и исчезновения рядов, а также очередей. Следите за отставанием и числом ожидающих образцов. Федерация решает другую задачу: верхний Prometheus забирает выбранные, обычно агрегированные ряды с нижестоящих серверов. Она не заменяет резервирование и долговременное хранилище.
Grafana и Alertmanager: лёгкие, но со своими нюансами
Для запуска Grafana достаточно 512 МБ RAM и одного ядра. Для небольшого развёртывания руководство рекомендует 2 ядра и 2–4 ГБ RAM. Расход зависит от числа пользователей, панелей, правил и частоты обновления. Широкие диапазоны, короткий auto-refresh и панели с тяжёлым PromQL нагружают прежде всего источник данных. Recording rules сокращают повторные вычисления. Сервис рендеринга изображений лучше выносить отдельно, поскольку браузерные процессы потребляют значительно больше памяти, чем обычный интерфейс.
Alertmanager хранит активные алерты, silences и журнал отправок. Расход обычно невелик, пока не растут число событий, маршрутов и получателей. Каталог данных должен быть постоянным, иначе после перезапуска пропадут silences и состояние дедупликации. node_exporter работает на наблюдаемой машине, а не на центральном узле. Его порт открывайте только для адресов сборщика.
Подбор конфигурации VPS под задачи мониторинга
В таблице сохранён тот же профиль: 500 рядов на цель, интервал 15 секунд, 30 дней локального хранения. NVMe указан с запасом для WAL, compaction и рабочих запросов. Если Grafana одновременно используют десятки пользователей или в Prometheus выполняются длинные ad hoc запросы, выбирайте верхнюю границу RAM и CPU.
До 50 целей
vCPU: 2
RAM: 4–8 ГБ
NVMe: 80–120 ГБ
Профиль: 15–30 дней хранения, простые дашборды
Около 200 целей
vCPU: 4
RAM: 8–16 ГБ
NVMe: 160–250 ГБ
Профиль: 30 дней хранения, recording rules, умеренный remote_write
Около 1000 целей
vCPU: 8
RAM: 24–32 ГБ
NVMe: 400–600 ГБ
Профиль: 30 дней хранения, разделение scrape-групп, план горизонтального роста
Высокая доступность
vCPU: от 4 на каждый узел
RAM: от 8 ГБ на каждый узел
NVMe: рассчитывается отдельно для каждого узла
Две реплики Prometheus с одинаковыми целями и дедупликация во внешнем хранилище или слое запросов
Проверяйте не только маркировку NVMe, но и лимиты IOPS, задержку записи и поведение диска во время compaction. RAM нужна активным рядам и запросам, поэтому увеличение retention влияет на диск сильнее, чем на память. Для сети посчитайте входящий поток scrape и исходящий remote_write, затем проверьте квоту трафика и доступность приватной сети.
Держите 30–40% запаса на рост кардинальности, обновление компонентов и временные очереди. Если Prometheus устойчиво приближается к лимиту RAM или во время compaction растёт задержка дисковых операций, простого увеличения диска недостаточно. Разделите сбор по площадкам, вынесите долговременное хранение или добавьте второй сервер до того, как одиночный узел станет точкой отказа.
Установка и базовая настройка стека
Разворачивая мониторинг на VPS через Docker Compose, закрепляйте проверенные версии образов и храните конфигурацию в Git. Ниже показан минимальный compose-файл с закреплёнными версиями образов. Перед развёртыванием сверьте их с текущими стабильными релизами. Административные интерфейсы привязаны к localhost: публикуйте Grafana через reverse proxy с TLS или открывайте её только из доверенной сети.
Выдайте контейнерам доступ только к нужным каталогам. На VPS оставьте доступными SSH и порты обратного прокси. К node_exporter разрешите подключение только с адреса Prometheus. Сохраняйте резервные копии конфигурации, provisioning Grafana и её БД. Копирование работающего каталога TSDB не гарантирует согласованный снимок.
В этом примере Grafana использует встроенную SQLite. Она подходит для тестового или небольшого внутреннего стенда. Для продакшена и нескольких реплик подключите внешнюю PostgreSQL или MySQL.
prometheus.yml и scrape-конфиги
В Prometheus 3.13 retention можно задать в prometheus.yml. Значение 60GB в примере рассчитано на небольшой профиль и том объёмом не менее 80 ГБ. Для другой скорости приёма лимит пересчитывают отдельно. Если одновременно заданы время и размер, Prometheus применит ограничение, которое сработает раньше. WAL и head-блокам всё равно нужно свободное место. metric_relabel_configs выполняется после получения метрик и помогает отбрасывать ненужные ряды до записи в TSDB.
Не меняйте интервалы сразу для всех job. Короткий интервал нужен там, где изменения требуется обнаруживать за несколько секунд. Ёмкость диска или срок сертификата можно проверять реже.
Alerting без шума: правила и маршрутизация
Порог без выдержки времени реагирует на каждый короткий провал. Поле for оставляет алерт в состоянии pending, пока условие не выполняется непрерывно. Метки severity, team и service нужны маршрутизации, но не добавляйте в них динамические значения.
В Alertmanager настройка маршрутизации начинается с группировки связанных событий. group_wait собирает первые алерты, group_interval задаёт интервал отправки изменений в группе, а repeat_interval ограничивает повтор уже известного уведомления. Inhibition подавляет предупреждение, когда для той же цели сработал критический сигнал.
Не храните токены в открытом репозитории. После изменения отправьте тестовый алерт и проверьте уведомления о срабатывании и восстановлении, а также отсутствие дублей. Для каждого сигнала укажите действие или ранбук. Без понятной реакции он создаёт шум независимо от порога.
Оптимизация и типовые ошибки
Чаще всего стек перегружают лишние ряды и запросы. Сократите кардинальность и ненужные collectors, увеличьте интервалы для медленных показателей, вынесите повторяющийся PromQL в recording rules. Ограничьте auto-refresh и диапазон ad hoc запросов. Длительную историю храните снаружи, федерацию используйте для выбранных агрегатов.
Проверяйте здоровье стека по короткому списку:
· retention ограничен по времени и размеру, свободно не менее 20–30% диска.
· рост активных рядов и скорости приёма объясним.
· длительность scrape и evaluation укладывается в соответствующий интервал.
· remote_write не копит очередь, отказ приёмника проверен.
· для чувствительных к кратким провалам алертов задано for.
· проверены группировка, inhibition и инструкции по реакции.
· дашборды и правила версионируются, правила проверяются через promtool, изменения проходят ревью.
· собственные метрики Grafana, Alertmanager и Prometheus используются в алертах.
· независимая проверка обнаруживает недоступность VPS, а внешний контроль heartbeat-сигнала – отказ канала уведомлений.
Проверьте настроенный сервер под реальной нагрузкой и по метрикам, а восстановление резервных копий – отдельным тестом.
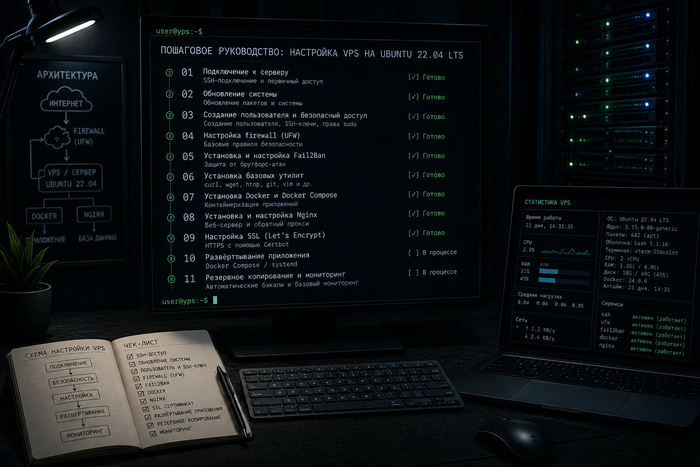
Вы арендовали VPS, получили IP и пароль от root. Между этим моментом и рабочим сервисом в продакшене лежит десяток шагов, которые важно пройти в правильном порядке. Пропустить один из них означает оставить сервер уязвимым или потратить часы на отладку в самый неподходящий момент. И здесь встаёт вопрос: как подготовить свой VPS к реальной работе?
Этот материал проведёт вас от первого SSH-подключения до полноценного окружения с безопасным доступом, настроенным firewall и рабочим стеком приложений. Руководство написано для Ubuntu 22.04 LTS: проверенного LTS-релиза, который часто используют для серверов и небольших проектов. В конце вас ждёт чек-лист, который удобно держать под рукой при каждой новой установке.
Что понадобится до начала установки VPS
Перед тем как приступить к установке VPS и первичной настройке, убедитесь, что у вас есть всё необходимое.
Во-первых, данные для подключения: IP-адрес сервера, имя пользователя (обычно root) и пароль или SSH-ключ. Всё это провайдер высылает на email сразу после создания машины. Если провайдер вместо пароля сразу добавил публичный ключ, убедитесь, что соответствующий приватный ключ есть у вас локально.
Во-вторых, терминал на локальной машине. На macOS и Linux SSH встроен по умолчанию. На Windows удобно использовать PowerShell со встроенным OpenSSH-клиентом.
Заранее найдите в панели провайдера KVM/VNC-консоль, она понадобится в случае потери SSH-доступа после изменений в конфигурации сети или firewall.
Первое подключение к серверу по SSH
Подключитесь к серверу из терминала. Замените YOUR_IP на IP-адрес сервера:
ssh root@YOUR_IP
При первом подключении терминал покажет предупреждение с отпечатком (fingerprint) сервера (уникальным идентификатором хоста) и предложит добавить его в список доверенных. Перед подтверждением сверьте fingerprint с данными в панели провайдера или документации к инстансу. Если он совпадает, введите yes. SSH сохранит ключ хоста в ~/.ssh/known_hosts. Если отпечаток изменится при повторном подключении, это может указывать на атаку посредника или на переустановку сервера.
Если провайдер настроил аутентификацию по SSH-ключу, а не по паролю, укажите путь к приватному ключу:
ssh -i ~/.ssh/id_rsa root@YOUR_IP
Возможные ошибки при первом подключении:
• Connection refused: SSH-сервис не запущен или порт закрыт. Проверьте состояние сервера через панель провайдера, иногда образ ещё инициализируется.
• Permission denied (publickey): ключ не добавлен на сервер или указан неверный путь к файлу ключа.
• Connection timed out: IP указан неверно или сервер ещё загружается. Подождите минуту и повторите.
Для удобства при частых подключениях настройте алиас в файле ~/.ssh/config на локальной машине:
Host myserver
HostName YOUR_IP
User root
IdentityFile ~/.ssh/id_rsa
После этого достаточно набрать ssh myserver. При необходимости подключаться под другим пользователем добавьте второй блок Host с другим значением User.
Обновление системы и базовые пакеты
Сразу после входа обновите список пакетов и сами пакеты.
apt update && apt upgrade -y
После обновления установите базовый набор инструментов:
apt install -y curl wget htop ufw fail2ban
Назначение каждого пакета:
• curl и wget: загрузка файлов и скриптов из сети;
• htop: интерактивный мониторинг процессов и потребления ресурсов;
• ufw: управление правилами firewall поверх iptables;
• fail2ban: автоматическая блокировка IP при многократных неудачных попытках входа.
Если после обновления терминал выводит System restart required, было обновлено ядро. Выполните reboot, дождитесь восстановления SSH-соединения (обычно 30–60 секунд) и продолжайте.
Создание пользователя и настройка безопасного доступа
Безопасная работа на своём VPS начинается с отказа от постоянной работы под root. Любая ошибка в команде или скомпрометированный пакет, запущенный с правами root, получает неограниченный доступ к системе. Создайте отдельного пользователя с правами sudo.
Если у вас ещё нет SSH-ключа, сгенерируйте его на локальной машине. Алгоритм ed25519 предпочтительнее RSA:
ssh-keygen -t ed25519 -C "myserver"
Публичный ключ находится в ~/.ssh/id_ed25519.pub. Его нужно добавить на сервере в файл ~/.ssh/authorized_keys того пользователя, под которым вы будете подключаться по SSH.
Создание пользователя и добавление в группу sudo:
adduser admin
usermod -aG sudo admin
Проверьте, что пользователь добавлен корректно:
id admin
В выводе должна присутствовать группа sudo. Зайдите под новым пользователем и проверьте работу sudo: выполните sudo whoami, вывод root подтверждает корректную конфигурацию. Скопируйте SSH-ключи из root-окружения:
Важно: откройте вторую сессию и убедитесь, что вход под admin работает, прежде чем вносить следующие изменения. Потеря доступа на этом этапе потребует входа через KVM/VNC-консоль провайдера.
Откройте конфигурацию SSH:
nano /etc/ssh/sshd_config
Найдите и задайте параметры:
PermitRootLogin no
PasswordAuthentication no
Перезагрузите конфигурацию через reload, а не restart: активные сессии при этом не прервутся.
systemctl reload ssh
Опционально: смена стандартного порта SSH с 22 на нестандартный снижает объём шума от автоматических сканеров в логах. Если решите изменить порт, сначала разрешите новый порт в UFW, затем внесите изменения в sshd_config и только после этого перезагрузите SSH.
Настройка брандмауэра и базовой защиты
Свежий сервер без firewall попадает под сканирование портов в первые минуты после выдачи публичного IP. UFW (Uncomplicated Firewall) снижает этот риск без необходимости работать с iptables напрямую. По умолчанию UFW блокирует весь входящий трафик и разрешает исходящий трафик.
Важный порядок действий: сначала создайте разрешающие правила, и только потом включайте firewall. Иначе вы заблокируете SSH и потеряете доступ к серверу.
Разрешите нужные порты:
ufw allow 22/tcp
ufw allow 80/tcp
ufw allow 443/tcp
Если используете нестандартный порт SSH, добавьте его вместо или дополнительно к 22 на период перехода. Включите firewall и проверьте статус:
ufw enable
ufw status
Вывод Status: active и список разрешённых портов подтверждают корректную работу. Все остальные входящие соединения будут отклоняться.
Настройка fail2ban. На Ubuntu 22.04 SSH-события пишутся в systemd journal, поэтому создайте файл /etc/fail2ban/jail.local с указанием backend:
[sshd]
enabled = true
backend = systemd
maxretry = 5
bantime = 1h
Перезапустите сервис и проверьте статус:
systemctl restart fail2ban
fail2ban-client status sshd
В выводе строки Currently banned и Currently failed покажут число заблокированных адресов и количество неудачных попыток за текущий период. Снять блокировку вручную можно командой fail2ban-client set sshd unbanip IP. Если fail2ban не видит попыток входа при реальных ошибках, проверьте значение backend = systemd в конфиге.
Установка рабочей среды: веб-сервер, БД, язык
Состав стека целиком зависит от задач проекта. Для большинства веб-приложений достаточно трёх компонентов: веб-сервер, база данных и runtime языка. Устанавливайте только то, что действительно нужно: каждый лишний запущенный сервис потребляет ресурсы сервера.
Nginx в роли веб-сервера и reverse proxy – стандартный выбор для большинства проектов:
apt install -y nginx
systemctl enable nginx
PostgreSQL для реляционных данных:
apt install -y postgresql
MySQL как альтернатива:
apt install -y mysql-server
Node.js. Версия в стандартном репозитории Ubuntu 22.04 может быть старее актуальной LTS-версии. Для установки свежей LTS-версии можно использовать NodeSource, предварительно сверив номер версии на nodejs.org:
Python 3 уже предустановлен в Ubuntu 22.04. Для работы с виртуальными окружениями добавьте:
apt install -y python3-pip python3-venv
Docker как универсальный вариант
Если проект допускает контейнеризацию, Docker избавляет от ручного управления зависимостями: приложение с окружением упаковывается в образ и запускается одинаково на любом хосте. Для продакшен-среды предпочтительнее установка через официальный apt-репозиторий Docker: так проще контролировать источник пакетов и обновления. Официальный скрипт тоже добавляет репозиторий Docker Engine и ставит актуальную версию, но его лучше использовать для быстрого старта или тестового окружения:
Добавьте пользователя в группу docker, чтобы команды выполнялись без sudo:
usermod -aG docker admin
Изменения применятся при следующем входе в сессию. Docker Compose v2 устанавливается как плагин и вызывается без дефиса:
apt install -y docker-compose-plugin
docker compose up -d
Пример минимального docker-compose.yml для сервиса с автоперезапуском:
services:
app:
image: myapp:latest
ports:
- "8080:8080"
restart: unless-stopped
Проверьте, что Docker установлен корректно и может запустить тестовый контейнер:
docker run hello-world
Домен, SSL и автозапуск сервисов
Привязка домена. В DNS-настройках у регистратора добавьте A-запись, указав IP сервера:
@ → YOUR_IP
www → YOUR_IP
Обновление DNS-записей занимает от нескольких минут до 24 часов. Проверить это можно командой dig yourdomain.com или через онлайн-сервисы вроде dnschecker.org. Не запускайте certbot до того, как запись распространится: это приведёт к ошибке валидации.
HTTPS через Let's Encrypt. Установите Certbot с плагином для Nginx:
Certbot изменит конфигурацию Nginx, добавит HTTPS-блок с путями к сертификату и предложит настроить редирект с HTTP на HTTPS. Обновление сертификата происходит через cron или systemd timer без вашего участия. Сертификат Let's Encrypt действует 90 дней. Проверьте, что продление пройдёт без ошибок:
certbot renew --dry-run
Автозапуск сервисов. Пакеты, установленные через apt, как правило, включаются в автозапуск автоматически. Для собственного приложения создайте unit-файл:
Каждая установка VPS проходит по схожему маршруту. Сохраните этот список и проходитесь по пунктам при каждой новой настройке.
1. Система обновлена: apt update && apt upgrade выполнены
2. Создан непривилегированный пользователь с правами sudo
3. Root-вход отключён: PermitRootLogin no в /etc/ssh/sshd_config
4. Аутентификация только по SSH-ключу: PasswordAuthentication no
5. UFW активен: ufw status показывает Status: active с нужными правилами
6. fail2ban работает: fail2ban-client status sshd показывает активный jail
7. HTTPS настроен: certbot renew --dry-run выполняется без ошибок
8. Сервисы добавлены в автозапуск: проверьте systemctl is-enabled nginx и другие
9. Настроены бэкапы или снапшоты через панель провайдера
10. Запланированы регулярные обновления безопасности: настройте unattended-upgrades для security-обновлений или другой контролируемый процесс обновления.
От первого ssh root до продакшен-среды вполне можно дойти за один рабочий день. Настройка VPS-сервера с нуля требует внимания прежде всего на этапе безопасности: шаги, пропущенные здесь, могут позже дать о себе знать. Не жалейте времени на проверку каждого пункта чек-листа до открытия сервиса пользователям.
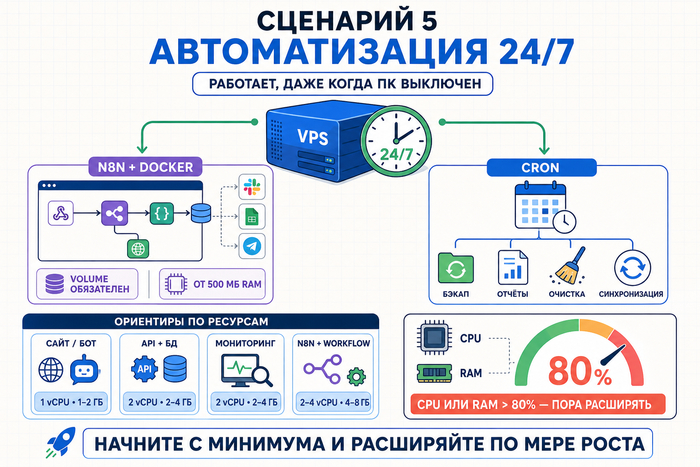
VPS куплен, SSH-сессия открыта. У многих здесь возникает пауза: непонятно, с чего начать и под какую задачу настраивать VPS-сервер. Разберём пять практических сценариев того, как использовать VPS: хостинг сайтов, запуск ботов, размещение API, мониторинг и автоматизация. У каждого – конкретный стек, ориентиры по ресурсам и нюансы, которые лучше знать до начала настройки, а не в процессе. Реальные требования зависят от сложности проекта, нагрузки, выбранного стека и числа одновременно работающих сервисов.
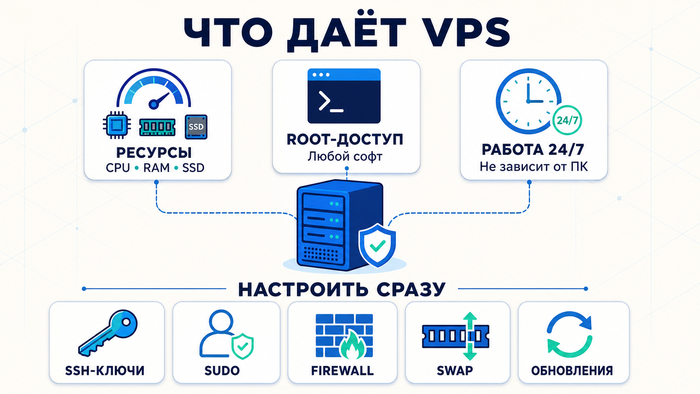
Что даёт VPS и почему его берут
VPS-сервер отличается от shared-хостинга тремя вещами. Первое – у вас есть заявленные параметры тарифа: CPU, RAM, диск и сетевой канал. На качество работы всё ещё может влиять общая инфраструктура хоста, но изоляция здесь выше, чем на shared-хостинге. Второе – root-доступ: можно установить любой софт, выбрать версию PHP, настроить nginx под конкретную задачу. Третье – VPS-сервер работает круглосуточно без вашего участия, независимо от состояния вашего компьютера или интернета. На shared-хостинге чужая нагрузка может повлиять на соседние сайты, если провайдер плохо ограничивает ресурсы аккаунтов.
От облачных функций (AWS Lambda, Yandex Cloud Functions) VPS отличается предсказуемостью: нет cold-start задержек, нет тарификации за каждый вызов функции, нет ограничений по времени выполнения. Для задач с постоянными процессами: баз данных, ботов, мониторинга – VPS часто проще и предсказуемее, чем serverless-архитектура с оплатой за вызов. При низкой или нерегулярной нагрузке serverless может оказаться дешевле.
Базовая подготовка: что сделать сразу после покупки
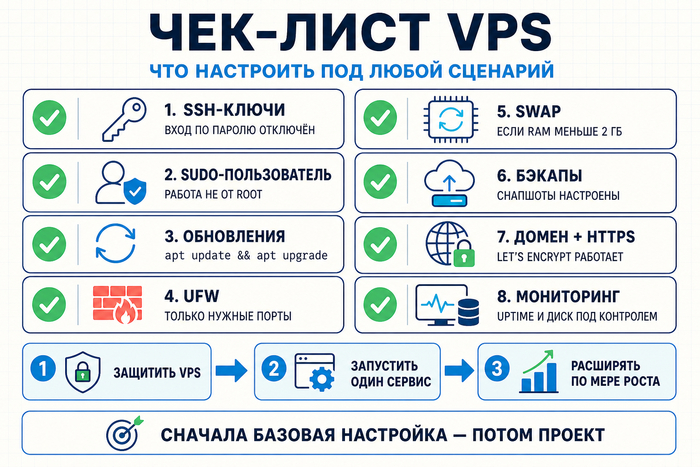
Настройка VPS начинается не сразу с рабочего проекта, а с базовой конфигурации. Базовая настройка снижает риск классических проблем: открытого SSH, устаревших пакетов, лишних портов и нехватки памяти при пиковых нагрузках. Пропуск таких шагов может увеличить риск потерять сервер из-за брутфорса или случайной команды от root.
• SSH-ключи. Сгенерируйте пару через ssh-keygen, передайте публичный ключ через ssh-copy-id, отключите аутентификацию по паролю в sshd_config.
• Пользователь без root. Создайте аккаунт с правами sudo. Работа от root в продакшене – плохая практика. Одна ошибка может стоить всей системы.
• Firewall. Откройте в UFW SSH-порт, 80 и 443, если они нужны вашему сценарию. Если используется стандартный SSH-порт, это 22. Fail2ban добавит защиту от брутфорса на SSH.
• Swap. Если RAM меньше 2 ГБ, добавьте swap-файл на 1–2 ГБ. Он снижает риск OOM при пиковой нагрузке, но при активном использовании может ухудшить производительность.
• Обновления. Запустите sudo apt update && apt upgrade сразу после входа на сервер, до начала любой работы.
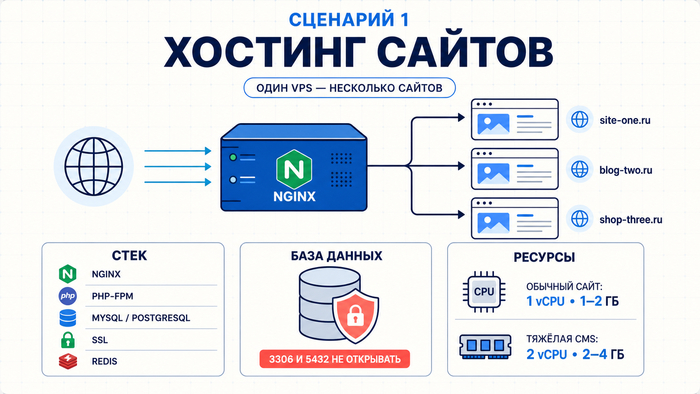
Сценарий 1. Хостинг сайтов и веб-проектов
Хостинг на VPS оправдан, когда shared-хостинг перестал справляться: нет нужной версии PHP или Python, не хватает памяти, несколько доменов требуют разных настроек или нестандартного ПО. На VPS больше свободы в настройке: можно выбрать версии ПО, настроить веб-сервер, подключить нужные модули и управлять несколькими проектами независимо. Именно поэтому многие переезжают сюда с первого же конфликта с техподдержкой shared-хостинга.
Стек: Nginx как веб-сервер и reverse proxy, PHP-FPM для WordPress или других CMS, MySQL или PostgreSQL как база данных. Для статических сайтов (Hugo, Astro, Next.js SSG) Nginx работает без интерпретатора, нагрузка минимальная. SSL – Let’s Encrypt через Certbot, бесплатно и с автообновлением. Один Nginx обслуживает несколько доменов через server blocks.
Порты СУБД (3306, 5432) наружу не открывайте: приложение обращается к базе внутри сервера. Для сайта с умеренным трафиком часто хватает 1 vCPU и 1–2 ГБ RAM; для тяжёлых CMS с кешированием, большим числом плагинов или высокой посещаемостью лучше закладывать 2 vCPU и 2–4 ГБ. Добавьте Redis для кеша сессий: это может снизить нагрузку на базу данных и улучшить отклик WordPress при росте трафика.
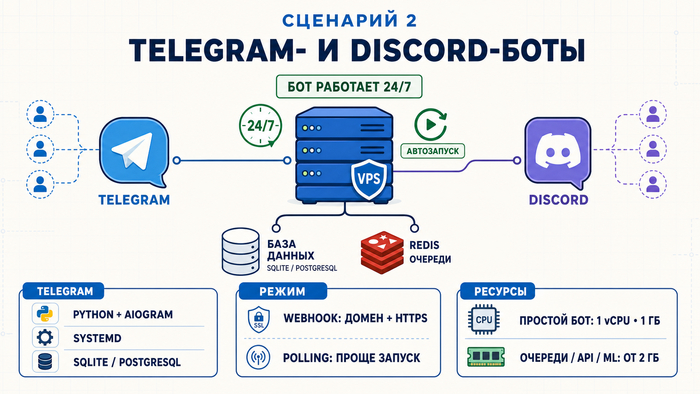
Сценарий 2. Запуск Telegram- и Discord-ботов
Боту часто нужно работать круглосуточно и хранить состояние: настройки пользователей, историю диалогов, очереди задач. Локальная машина для этого не подходит, а облачные функции удобны в основном для коротких команд без постоянного процесса. VPS решает обе задачи: бот постоянно запущен, а база данных может работать рядом на том же сервере.
Стек для Telegram: Python + aiogram, управление процессом через systemd, хранение состояния в SQLite или PostgreSQL. SQLite подходит для небольших ботов с умеренной нагрузкой, но при высокой конкуренции запросов или запуске нескольких экземпляров приложения лучше сразу выбирать PostgreSQL. Для Discord – Node.js + discord.js, для управления процессом удобен PM2. Redis подойдёт для быстрого хранения временных данных и очередей.
Для большинства продакшен-сценариев с Telegram-ботами удобен webhook-режим: сервер сам получает обновления, не опрашивая API Telegram. Для webhook нужен домен с HTTPS. Polling тоже остаётся корректным вариантом для небольших проектов: он проще в запуске и не требует домена с HTTPS. Простой бот без базы данных умещается на 1 vCPU и 1 ГБ RAM. Бот со сложными очередями, вызовами внешних API и ML-моделями потребует минимум 2 ГБ RAM. Через systemd настраивается автозапуск: после перезагрузки сервера бот поднимется сам.
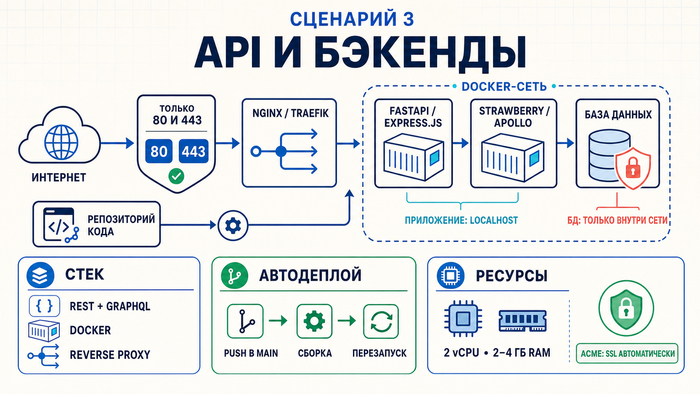
Сценарий 3. Размещение API и бэкендов
VPS-сервер даёт API постоянный адрес, свою базу данных и полный контроль над окружением, без vendor lock-in и без ограничений по времени выполнения запросов. Это важно для бэкендов с длительными операциями: обработкой файлов, парсингом, генерацией отчётов.
Стек: FastAPI (Python) или Express.js (Node.js) для REST, Docker для изоляции сервисов, Nginx или Traefik как reverse proxy. Приложение слушает на localhost, наружу открыты только 80 и 443. GraphQL – Strawberry (Python) или Apollo Server (Node.js). Для автодеплоя – GitHub Actions: пуш в main запускает пересборку и перезапуск контейнера.
Порты базы данных держите внутри Docker-сети, не открывайте наружу: бэкенд обращается к базе по имени сервиса внутри сети. Для API с базой данных начинайте с 2 vCPU и 2–4 ГБ RAM. При росте нагрузки Docker и reverse proxy позволяют масштабировать сервисы без переписывания архитектуры. Traefik автоматически получает и обновляет SSL-сертификаты через Let’s Encrypt при настроенном ACME, поэтому отдельная настройка Certbot не нужна.
Сценарий 4. Мониторинг и сбор метрик
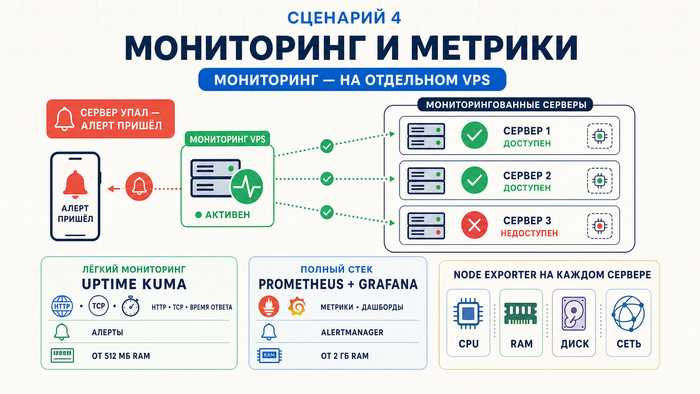
Сервер мониторинга должен работать независимо от мониторируемой инфраструктуры. Если основной сервер упал, система мониторинга должна увидеть это первой и отправить алерт, а не упасть вместе с ним. Отдельный небольшой VPS для мониторинга решает эту задачу.
Uptime Kuma – удобный инструмент с веб-интерфейсом: отслеживает HTTP-статусы, время ответа, порты TCP, отправляет алерты в Telegram, Slack и другие каналы. Разворачивается через Docker за несколько минут и обычно помещается в небольшой VPS. Для лёгкого мониторинга часто достаточно 512 МБ RAM, но потребление зависит от числа проверок и их типа.
Prometheus + Grafana – полный стек для сбора метрик, построения дашбордов и настройки алертов. Prometheus собирает данные с exporters, Grafana строит графики. Оба сервиса вместе могут потреблять примерно 600–1000 МБ RAM в покое, но фактическое потребление зависит от retention, числа targets и объёма метрик. Под этот сценарий обычно стоит закладывать не меньше 2 ГБ RAM. Node Exporter собирает системные метрики хоста – CPU, RAM, диск, сеть; добавьте его на каждый наблюдаемый сервер. Алерты в Telegram настраиваются через Alertmanager за несколько минут.
Сценарий 5. Автоматизация и рабочие процессы
Сервер не выключается. Это главное преимущество VPS для автоматизации: cron-задачи запускаются по расписанию в любое время суток, скрипты работают столько, сколько нужно, без ограничений по времени выполнения и без зависимости от того, включён ли ваш компьютер.
n8n – self-hosted инструмент для визуальной автоматизации, аналог Zapier на вашем сервере. Разворачивается через Docker, а потребление памяти может начинаться примерно от 500 МБ RAM и расти с числом workflow, интеграций и выбранной БД. Данные о задачах хранятся в БД, поэтому volume для персистентности обязателен. Настроенный VPS с n8n заменяет подписку на облачные сервисы автоматизации и не передаёт данные третьим сторонам.
Для простых задач достаточно cron: бэкап файлов, отправка отчётов, очистка временных директорий, синхронизация данных между сервисами.
Как выбрать свой сценарий и не перегрузить сервер
Примерные ориентиры по ресурсам под основные задачи:
• Сайт или бот без тяжёлых фоновых задач: 1 vCPU, 1–2 ГБ RAM
Несколько сценариев на одном VPS совместить возможно, но требования зависят от сложности проекта, выбранного стека, объёма трафика и числа одновременно работающих сервисов. Для простого сайта, небольшого бота и лёгкого мониторинга 2 ГБ RAM могут быть достаточны, если нет тяжёлых фоновых задач. Docker упрощает совмещение: каждый сервис в своём контейнере, порты не конфликтуют, ресурсы лимитируются. Постоянная загрузка CPU или RAM выше 80% может стать сигналом для апгрейда. Начните с минимального тарифа и расширяйте по мере роста – большинство провайдеров позволяют сделать это без пересоздания сервера.
Чек-лист: что настроить на VPS под любой сценарий
1. SSH-ключи настроены, аутентификация по паролю отключена
2. Создан sudo-пользователь, работа от root прекращена
3. Система обновлена: sudo apt update && apt upgrade
4. UFW включён: открыты только нужные входящие порты, например SSH-порт, 80 и 443 для веб-сценариев
5. Swap настроен при RAM < 2 ГБ
6. Автоматические снапшоты или бэкапы настроены
7. Домен привязан, HTTPS работает через Let’s Encrypt
8. Базовый мониторинг: uptime и диск под контролем
VPS это не готовый продукт, а платформа для разных задач: сайта, бота, API, мониторинга или автоматизации. Начните с одного сценария, не пытайтесь запускать всё сразу. Сначала закройте базовую настройку из чек-листа: SSH-ключи, firewall, обновления, бэкапы и мониторинг. После этого разверните минимальную рабочую версию сервиса и расширяйте конфигурацию по мере роста нагрузки.