Тут был интересный диалог в комментариях... Прошу присоединиться сочувствующим (или наоборот): Задал я тут вопрос очередному "адепту ИИ", который считает, что ИИ изменит все: "Что есть курсор"?... Ответить он не смог. Я задал наводящий вопрос: backend, базы данных - ответ тот же. Тут уже я предложил разобраться: Курсор - это цикл в SQL. В 99% случаев: оооочень (прямо ооооочень) плохая практика. Честно - готов сжигать на костре тех, кто это делает (а делают - даже сейчас, причем опытные "погроммисты"). Если в SQL тебе понадобился цикл - ты решаешь задачу бизнес-логики в среде, которая изначально создавалась для операций над множествами. Рекомендация одна: делай это уровнем выше, в коде приложения. Дальше - ваши фантазии и предложения.
Для списка событий требуется сначала показать новые записи. Помощник добавляет ORDER BY created_at DESC, а затем LIMIT. На первый взгляд задача решена. Но если у нескольких событий одна дата, какой из них должен попасть первым?
Это учебный пример на вымышленных записях, подготовленный с помощью ИИ. Он выполнен в отдельной базе SQLite в памяти. Реальные журналы и персональные данные не используются.
db.executemany("INSERT INTO events VALUES (?, ?)", [
(1, "2026-10-01T10:00:00"),
(2, "2026-10-01T10:00:00"),
(3, "2026-10-02T10:00:00"),
])
rows = db.execute(
"SELECT id FROM events ORDER BY created_at DESC, id DESC LIMIT 3"
).fetchall()
print(rows)
Результат:
[(3,), (2,), (1,)]
Мы явно договорились: при одинаковом времени первым идёт больший идентификатор. Уникальный id завершает порядок для этого набора. Это выбранное правило интерфейса, а не утверждение, что больший id всегда означает более позднее реальное событие.
Документация SQLite (https://www.sqlite.org/lang_select.html#orderby) не обещает определённый порядок строк, у которых равны все выражения ORDER BY. Если повторный запуск случайно показывает тот же порядок, это ещё не превращает наблюдение в гарантию.
Отдельная проблема — меняющиеся данные
Второй ключ помогает однозначно упорядочить текущий набор. Он не гарантирует отсутствие пропусков при перелистывании через OFFSET, если между запросами появляются или исчезают записи.
Для такого списка сначала выбирают требуемое поведение: нужен неизменный снимок, живая лента или продолжение после конкретной пары ключей. Это разные задачи. Не стоит обещать «исправленную пагинацию» после одного добавленного id.
В нашем примере все даты записаны в одном формате и предполагают одну временную шкалу. Разные часовые пояса и форматы нельзя незаметно смешивать в строковой сортировке.
Небольшая проверка перед выпуском
Создайте несколько строк с одинаковым основным ключом. Заранее задайте, какая должна идти первой. Проверьте результат целиком и на границе LIMIT. Затем отдельно рассмотрите вставку новой записи между запросами страниц.
Полезный вопрос к предложенному ИИ запросу: «Каким правилом разрешаются равные значения?» Если ответ — «база обычно возвращает так», правило пока не определено.
Задача звучит понятно: показать все заявки, кроме закрытых. Помощник предлагает условие `status != 'closed'`. В тестовой таблице есть открытая заявка, закрытая и одна без известного статуса. Запрос возвращает только открытую. Третья тоже не попала в результат.
Это учебный разбор с помощью ИИ, без данных настоящих клиентов. Пример выполнен в локальной базе SQLite в памяти.
Проверка на трёх строках
import sqlite3
with sqlite3.connect(":memory:") as db:
db.execute("CREATE TABLE tickets(id INTEGER, status TEXT)")
db.executemany("INSERT INTO tickets VALUES (?, ?)",
[(1, "open"), (2, "closed"), (3, None)])
simple = db.execute(
"SELECT id FROM tickets WHERE status != 'closed' ORDER BY id"
).fetchall()
explicit = db.execute(
"SELECT id FROM tickets "
"WHERE status != 'closed' OR status IS NULL ORDER BY id"
).fetchall()
print(simple)
print(explicit)
Результат:
[(1,)]
[(1,), (3,)]
`NULL` обозначает отсутствие значения. Сравнение `NULL != 'closed'` не становится истиной. Поэтому первая выборка не включает третью запись. Для явной проверки отсутствия значения служит `IS NULL`; это описано в документации SQLite (https://www.sqlite.org/lang_expr.html).
Какой запрос правильный
Это зависит от смысла задачи. Если нужны только заявки с известным незакрытым статусом, первый запрос подходит. Если требуется также проверить заявки без статуса, нужно явно включить их либо вывести отдельным списком.
Второй вариант в примере включает неизвестные статусы в результат, но не объявляет их открытыми. Этот смысл нельзя незаметно менять. Например, отчёт «в работе» и очередь «проверить всё, что ещё не подтверждено закрытым» могут требовать разных выборок.
Не стоит заменять все NULL пустой строкой только ради красивой таблицы. После такой замены можно потерять различие между неизвестным значением и реально присланной пустой строкой. Здесь решение о хранении данных важнее краткости запроса.
Что передать ИИ до генерации SQL
Вместе со схемой таблицы полезно дать небольшой набор строк и точный ожидаемый список идентификаторов. Добавить хотя бы три случая: нужный статус, исключаемый статус, отсутствующий статус. Если поле допускает пустую строку или опечатку, для них тоже нужны отдельные ожидания.
Проверку сначала выполняют как SELECT на безопасной копии или синтетических данных. Успешная выборка ещё не является разрешением обновлять или удалять записи в рабочей базе. В показанном примере нет команды изменения настоящих заявок.
В апреле 2023 года мы запустили необычный для нас проект - ремонтный сервис нового формата. Первого клиента нашли только в начале лета, но уже с первого проекта удалось достичь запланированной прибыли. Расскажу, как мы создали современную компанию для поколения "новых денег", которые не готовы к тому, что прораб будет класть половину стоимости ремонта себе в карман, а сроки растягиваются без ограничений и почему это оказалось прибыльным бизнесом.
Как всё начиналось
Конец 2022 года. Я работал менеджером проектов в крупной IT-компании, мой друг Антон - тимлидом в другой известной технологической компании, а Дима занимал позицию backend-разработчика в третьей. У всех стабильные зарплаты, интересные проекты - жизнь шла своим чередом, пока Антон не решил купить квартиру в новостройке.
После долгих поисков он остановился на 85-метровой квартире в ЖК около метро Саларьево - современный комплекс с подземным паркингом и зелёным двором. Как типичный программист, к поиску ремонтников он подошёл педантично: изучил десятки предложений, провёл собеседования с кандидатами. В итоге выбрал бригаду с Авито с "15-летним опытом работы".
Денис (это я:) - один из создателей сервиса
За время ремонта у Антона мы с Димой часто приезжали к нему - помочь, посоветовать, и просто поржать над очередными косяками строителей. У нас обоих за плечами был серьёзный опыт управления командами, внедрения процессов, автоматизации и контроля качества. И знаете что? Нам казалось, что главное в ремонтном бизнесе - это грамотный менеджмент и организация процессов. И на самом деле, все примерно так и есть.
День когда мы решились
Если честно, мысли о собственной ремонтной компании появились у нас задолго до этого случая. В IT-тусовке часто шутят, что в России есть три верных пути: вебкам, айти и стройка. И мы, насмотревшись на хаос в ремонтной сфере, не раз обсуждали возможность открытия своей “фирмы”.
Мы выделили основные проблемы, которые должны были исправить с помощью своего сервиса
Первое - это постоянно растущие сметы и "задранная стоимость" на работы. Ну вы серьезно? Почему для меня ремонт в квартире должен чем-то отличаться от заказа носков на Вайлдберриз? Почему-то там нет такого, что цена носков может вырасти в 2 раза за время доставки. А тут начальная смета в 1 миллион превратилась почти в 1,7! И каждый раз это "ой, тут стены кривые", "ой, а тут придется докупить", "ой, а это мы не учли".
Второе - это бесконечно растущие сроки. Это еще хуже. Как люди с опытом в менеджменте, мы прекрасно знали, что растущие сроки – это всегда раздолбайство управления и ленивые рабочие. Но тут было чуть посложнее, об этом чуть позже. У Антона обещали сделать за 4 месяца, а в итоге растянули на 8.
Третье - хитрые прорабы. Это вообще отдельная история. Когда прораб говорит "давайте я сам закуплю материалы, у меня скидки", знайте - он накинет сверху процентов 30-40. А еще есть "срочные работы", которые почему-то не были учтены в смете. И конечно, вечная классика - экономия на материалах: заказываешь одно, а привозят что-то попроще, но по той же цене.
Целевая аудитория
А параллельно с этим мы определили нашу целевую аудиторию. Чтобы выделиться на конкурентном рынке, мы решили ориентироваться на молодых IT-специалистов и представителей “современных” профессий, живущих в Москве в возрасте 30-40 лет. Тех, кто покупает квартиру в новостройке и привыкших к хорошему сервису. Кто не готов, что его будут водить за нос и разводить на деньги.
Что с ценой?
При этом очень важно было держать цены НИЖЕ, чем у других компаний, иначе на рынке просто не выжить. В премиум сегмент нужен "пропуск" в виде большого количества работ для определенного типа клиентов, поэтому нам было понятно, что "брать" много - пока что, непозволительно. Но мы нашли способ: автоматизация процессов, прямые поставки материалов, четкое планирование работ и никаких скрытых накруток. Но несбыточной мечтой это покажется только обывателю: на самом деле сервис и правда должен быть таким, вообще любой.
История первого заказа летом 2023 года
А теперь самое интересное - наш первый заказ. Это была отдельная эпопея. Начало лета 2023, звонок от потенциального клиента.
Первый клиент оказался прямо "в яблочко" - тоже айтишник (пришедший из первой контекстной рекламы в яндексе запущенной на 20 тыс.), работал в крупной компании, купил двушку в панельке 80-х годов. Причем достаточно убитую - стены местами с дырками, старый паркет, трубы помнящие еще Горбачева... Но нам, если честно, даже повезло что первый объект был не новостройкой. На старом фонде учиться легче - там хотя бы есть на что посмотреть, в отличие от новостроек, где все "сюрпризы" спрятаны в голых стенах.
Дырка в стене была ДО демонтажа. Клиент купил квартиру с "убитым" ремонтом подешевле, в надежде сэкономить
Как мы мастеров искали
Начали с поиска бригады. Вот тут был первый холодный душ - оказалось, что найти классных специалистов без своей наработанной базы очень сложно. Мастера хорошего уровня либо уже при деле, либо просят космос. А те, кто сразу соглашается - ну, вы понимаете. За две недели провели больше 10 собеседований (назовем их так😊). Причем процесс собеседования мы сразу сделали "как в айти" - тестовые задания, проверка портфолио, разбор технологий работы. Бригадиры были в шоке - некоторые прямо уходили с собеседований, когда мы начинали распрашивать про технологии укладки плитки и показывали фотографии косяков с объектов с форумов.
В итоге нашли бригаду - два брата, которые до этого работали в крупной ремонтной компании, но ушли потому что устали от "серых" схем – по отношению К НИМ ЖЕ. В основном - задержки з/п и прорабы.
В том же санузле, но уже после демонтажных и некоторых черновых работ. Братья очень помогли нам с первым ремонтом, кроме этого, они дали нам контакты проверенных рабочих, которые впоследствии делали ремонт вместе с ними
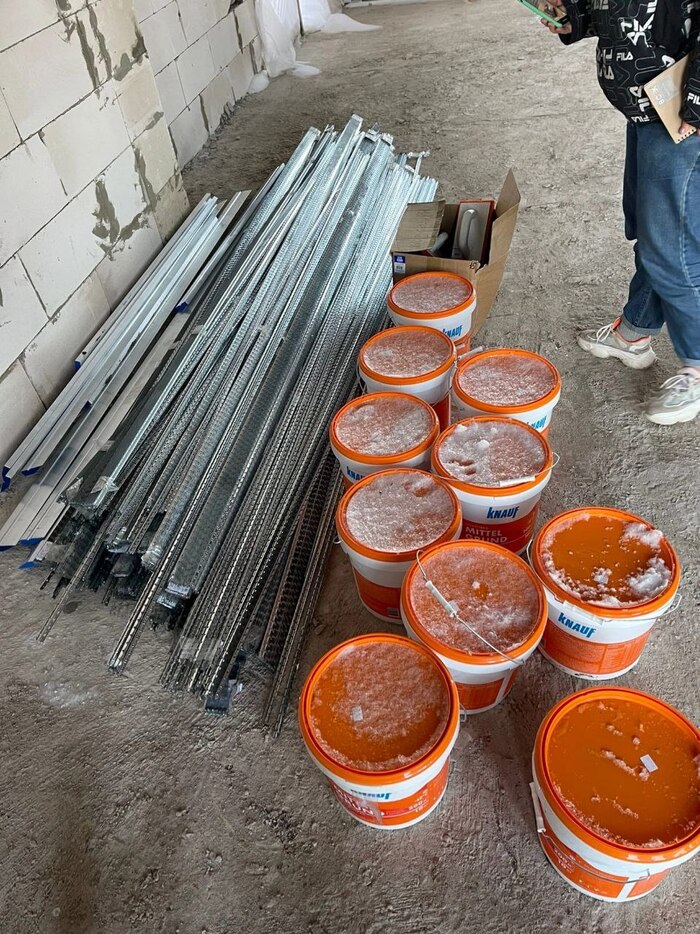
Купили первый комплект инструмента - это отдельная история на 100 тысяч рублей. Ещё сразу купили свою тепловую пушку - это из необычного. Большинство компаний привлекают "потолочников" на субподряд. Мы захотели сразу начать формировать свой инструментарий для будущих сотрудников. Зато потом эта закупка очень помогла - не зависели от того, что принесет с собой бригада. Позже, когда начали расширяться купили свою штукатурную станцию. Это, на удивление, было самой выгодной покупкой.
Первые сложности
Начали ремонт. И тут поехало... Первый сюрприз - когда начали снимать старую штукатурку, оказалось что стены буквально рассыпались. Плюс под старым линолеумом в коридоре нашли деревянный пол с насыпью под ним.
Тут был первый серьезный разговор с заказчиком. Объяснили ситуацию, показали все фотки, рассказали что сколько будет стоит в соответствии с прайс-листом. Тут очень помогло то, что мы сразу взяли за правило - фотографировать вообще все. Каждый этап, каждый слой, каждую трубу.
С материалами тоже было весело. Первый месяц я лично объездил все крупные строительные магазины в радиусе 30 км. Искал поставщиков, договаривался о скидках. Помню, как чуть не купили партию плитки по "супер-выгодной" цене, а потом выяснилось что это условно "второй сорт" - брак, который продают через "серые" схемы.
Cделали систему закупок: (Первый заказ полностью сделан из материалов, купленных в Петровиче и на маркетплейсах). Бригада присылает список - мы проверяем цены у 3-4 поставщиков и заказываем где дешевле.
Мы сразу внедрили систему ежедневных фото-отчетов и еженедельных созвонов. Плюс сделали чат в телеграме, куда скидывали все чеки, все накладные, все фотки. Такая прозрачность очень помогла - клиент видел, что мы не химичим с ценами и не пытаемся на нем нажиться.
В итоге сделали.
Братья советовали нам недостающих специалистов по ходу ремонта и постепенно, укладываясь в срок мы сдавали клиенту новый и новый этап. Честно, это было не так сложно как казалось в начале, но нужно понимать, что на самом деле, проблем по ходу ремонта и мелких трудностей было ОЧЕНЬ много, просто мы как люди привыкшие, понимали что сейчас это и есть наша работа , за которую нам платит клиент - взять на себя все заботы по ремонту. Но серьезных форс-мажоров не возникало, максимум понервничали, когда внесли предоплату потолочникам, которых нашли по объявлению, после чего они явно начали задерживать сроки, но в итоге, все обошлось. Нам и до этого было ясно, что чем быстрее мы соберем свой , хотя бы, небольшой штат, тем лучше и выгоднее. Но для этого надо быть уверенным в постоянном потоке заказов, что мы на тот момент, не могли себе позволить.
Главное - мы поняли как надо и как не надо. Все закупки только через нас. Все договоренности - только в письменном виде.
По деньгам первый проект получился условно в ноль - не считая наших вложений в инструмент и рекламу. Но мы получили бесценный опыт, наработали связи с поставщиками (если это можно назвать так пафосно) и главное - поняли, что наша модель рабочая, хотя на тот момент не были в этом до конца уверены. Наши сомнения развеяло лето 2023 года.
1/5
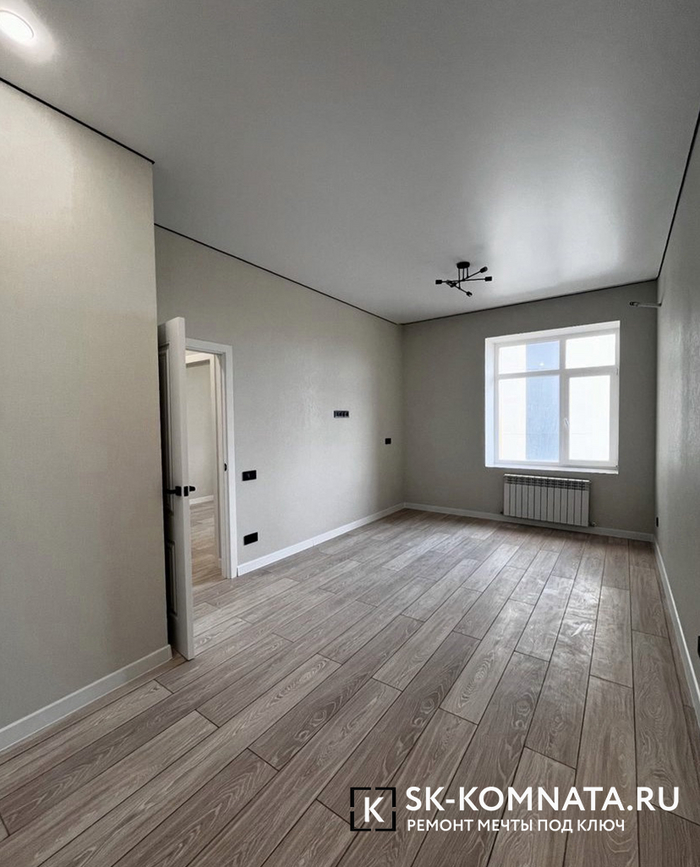
Наша первая работа, которую нам помогли закончить "братья", советуя недостающих мастеров на каждый этап работ. Цена работ для заказчика вышла 750 000 рублей. Летом 2023 года, за аналогичный объём работ авитовские бригады просили до миллиона(!)
Сайт и маркетинг или как мы общаемся с клиентами ещё до первого звонка
Кстати, про сайт. Первую версию мы сделали за пару вечеров на Тильде - максимально простую: фотки, цены, контакты. Знаете что? Он у нас до сих пор такой – но с значительно изменённым UI/UX. Я иногда ловлю себя на мысли - вот мы же, можем сделать что-то крутое, с личным кабинетом, онлайн-сметами... Но потом смотрю вордстат, статистику и думаю - а зачем? Клиенты находят нас, звонят, все работает. Иногда лучшее решение - самое простое.
1/2
На главной странице "в лоб" о том кто мы, наши конкурентные преимущества, специализация и примеры работ
1/2
Сразу "ярко" заявляем о действующих скидках. Кроме этого, простым текстом пытаемся общаться с клиентом и убедить его в нашем сервисе, пока что, не общаясь с ним лично - конверсия в лиды увеличилась значительно, но важно, чтобы все предложения были реальны
А вот ворд стат. За последний месяц нас искали 680 раз не считая статистики переходов по прямой ссылке. Доказательство того, что дорогой сайт не нужен. Наш стоит 6 000 рублей в год, а сделан за 20 часов
Примеры лучших работ как маркетинговый инструмент
1/4
Оставляли подобные фото с примерами работ и вотермаркой в отзывах к жилым комплексам. Отличный маркетинговый инструмент - сразу определяем нужную ЦА и бесплатно заявляем о себе. Точно знаем, что минимум один клиент был из отзывов яндекс - поэтому работает
Как мы масштабировались и разбирались в проблемах ремонта
Теперь про то, как мы начали разбираться в проблемах ремонта и потихоньку расти. Знаете, за этот год мы много думали - почему вообще ремонтные компании задерживают сроки и не могут сделать работу по первоначальной цене? И нашли несколько интересных моментов.
Первое - сроки. Тут даже копать глубоко не пришлось - сам рынок сформирован так, что клиенты просто привыкли к задержкам. "А, ну это ремонт, тут всегда так" - классическая фраза. Благо тут нам помог опыт организации процессов из айти. Четкие спринты, ежедневные отчеты, календарный план. Работает как часы, если не филонить.
Второе - вечно растущая цена. Вот это было сложнее. В новостройках еще можно точно посчитать, а во вторичке... Но благодаря наработкам этот вопрос стал гораздо яснее. При правильно организации процессов, непредвиденные работы лучше оплатить из своих средств, чем терять клиента. Только так и делается сервис.
Третье - больная тема - воровство на материалах. Тут мы конкретно закрутили гайки. Завели строгий учет, до последнего мешка штукатурки. Прорабам сразу сказали - любая жалоба от клиента на нечестность - это конец сотрудничества. Знаете что самое смешное? Когда начали работать честно, оказалось что маржа все равно хорошая. Просто многие привыкли что надо обязательно накручивать еще и еще.
Неприятные особенности прозрачного сервиса
Большинство компаний, которые начинают работать честно, быстро сдуваются. Потому что сам потребитель привык к плохому сервису. Приходишь к клиенту, говоришь "мы все сделаем четко по смете и в срок", а он смотрит с недоверием - "да ладно, так не бывает". Сейчас в 2024-м ситуация получше, но рынок все еще очень консервативный.
Продвижение или как мы брали “Новую Москву”
Наш любимый Прокшино в Новой Москве - в 2024 году, это самый перспективный район в котором покупатели - наши потенциальные клиенты
Расти начали потихоньку. Сначала сделали специальные цены для новой Москвы - там как раз много новостроек, где мы хорошо научились работать. Потом пошли заказы по рекомендациям. Когда я говорю “пошли” заказы нужно понимать, что это 1-3 заказа в месяц стабильно, что на самом деле, тогда казалось не мало. С рекламой экспериментировали забавно - оставляли визитки в подъездах (да, просто старые добрые визитки!), ставили рекламные ящики у офисов продаж в дни выдачи ключей.
Был случай, когда на одном ЖК поставили такую стойку, а через неделю риелтор оттуда сам позвонил и предложил взять себе процент, если клиент пойдет к нам.
Сейчас берем 2-5 заказов в месяц, (летом было 5 в месяц, если разделить). Большинство клиентов приходят по рекомендациям. Штат за год работы постепенно собрали свой. Трудоустроено 14 сотрудников. Если их не хватало (как летом), привлекали мастеров с которым уже работали раньше, по договору ГПХ. Просили всех регистрировать самозанятость или ИП – это было тяжело, но зато честно платим налоги по Доходы – расходы.
Как устроен процесс
Знаете, что самое сложное в ремонтном бизнесе? Нет, не поиск клиентов и не работа с материалами. Самое сложное - это выстроить систему, которая будет удовлетворять запросы клиента и при этом позволит компании зарабатывать. Мы долго думали над этим и придумали несколько интересных решений.
Начнем с оплаты. Если посмотреть на московский рынок, там забавная система - вроде бы без предоплаты, но это только за первый, самый дешевый этап. А потом - бац, и клиент должен внести 50% от всей суммы. И попробуй не внеси - бригада уйдет на другой объект. Мы сделали иначе: разбили весь ремонт на этапы (их получилось 12 для капитального ремонта), и берем предоплату только за текущий этап. То есть клиент всегда понимает, за что именно платит, и может контролировать процесс.
С договорами тоже интересно получилось. Сначала делали один стандартный, а потом поняли - люди разные, запросы разные. Сейчас у нас три варианта: просто на работы (для тех, кто сам хочет закупать материалы), на работы плюс материалы (самый популярный), и полный пакет с дизайн-проектом. Кстати, про дизайн - мы не держим штатных дизайнеров, работаем с фрилансерами. Так получается и дешевле для клиента, и качество выше - каждый дизайнер специализируется на своем стиле.
Первый образец договора, который ставили на сайт
Расчёт стоимости
Расчет стоимости работ - отдельная история. Когда начинали, было очень сложно. На рынке нет четких цен - один мастер берет 3 тысячи за квадрат стяжки, другой - тысячу, третий вообще говорит "ну давайте посмотрим по факту". Сначала работали по среднему прайсу, но часто уходили в минус по отдельным этапам - то бригада дороже встанет, то материала больше уйдет. Сейчас, когда появились постоянные сотрудники, стало проще - мы точно знаем их расценки и можем давать фиксированную цену.
Материалы
Выяснилось, что в крупных магазинах часто дешевле в сравнении с рынками стройматериалов, особенно если ловить акции. Плюс появились маркетплейсы - там вообще красота по ценам. И главное - полная прозрачность, клиент сам видит все позиции. Если находим материал дешевле - возвращаем разницу. Был случай, когда на керамограните сэкономили клиенту почти 30 тысяч - просто потому что, нашли ту же плитку в другом магазине по акции.
Как работаем сейчас
Сейчас берем 2-5 заказов в месяц, зависит от сезона и сложности объектов.
Процесс обкатан до мелочей: сначала выезд на замер, потом предварительная смета. Если клиента все устраивает - детальный расчет и договор. Дальше начинается самое интересное - согласование материалов, закупки, работа.
Особенности продвижения и подводные камни
С продвижением интересно получилось. Сначала, как все, полезли на Авито. И знаете что? Не зашло. Там своя специфическая аудитория и конкретно у нас, с Авито “ не пошло”.
Свежий пример страницы с авито в категории "Ремонт квартир". Как клиенты определяются с подрядчиком среди тысяч однотипных объявлений - хороший маркетинговый вопрос, который мы решаем, после чего полноценно "зайдём" на авито
Пробовали контекстную рекламу яндекс - тоже так себе результат. Клики дорогие, конверсия низкая. Зато отлично зашла таргетированная реклама в Instagram* (*запрещен в РФ) и реклама в районных пабликах ВКонтакте. Особенно в группах новостроек в ТГ - там как раз наша целевая аудитория.
Но главный канал - сарафанное радио. Причем работает оно интересно. Всегда знаешь , от кого пришли заказчики и проще выстраивать коммуникацию. Есть клиент - он доволен, рассказал коллегам - и понеслось. За три месяца получили еще два заказа от сотрудников той же компании. Выходит такой “корпоративный ремонт”)))
Были, конечно, и провалы в продвижении. Пытались работать с риелторами - предлагали им комиссию за клиентов. Не пошло - у них свои схемы, свои бригады. Пробовали давать рекламу в лифтах, входных группах - тоже мимо, ни одного обращения, но тут скорее из-за того что эта реклама буквально на день.
ИТОГ
Сейчас мы существуем уже чуть больше года и в целом смотрим на ремонтный рынок не так, как раньше. За это время мы сделали несколько важных заметок для себя:
Оказывается, большинство проблем в ремонте - это не технические сложности, а банальная организация процессов. Когда все четко спланировано и каждый знает что делать - даже самый сложный ремонт идет как по маслу.
Мы поняли, почему многие компании "химичат" с ценами и сроками - просто потому что не умеют нормально считать и планировать. Когда все процессы выстроены правильно, можно работать честно и все равно оставаться в плюсе.
Самое сложное - это не найти клиентов или научиться делать ремонт. Самое сложное - это переломить привычку рынка работать "по-серому". И заказчики, и исполнители настолько привыкли к непрозрачным схемам, что честный подход вызывает удивление.
Мы до сих пор учимся. Каждый объект - это новый опыт и новые вызовы (особенно по части коммуникаций с клиентами). Но главное - мы видим, что наша модель работает и пока что, нам удается держать ценник немного ниже рыночного, за счёт того что до сих пор не имеем в найме маркетологов, IT, отдела продаж и менеджеров по продажам. Стараемся нанимать именно рабочих, все остальное можно отдать на аутсорс.
Уважаемые пикабушники, были рады составить для вас эту статью! С любовью, СК Комната
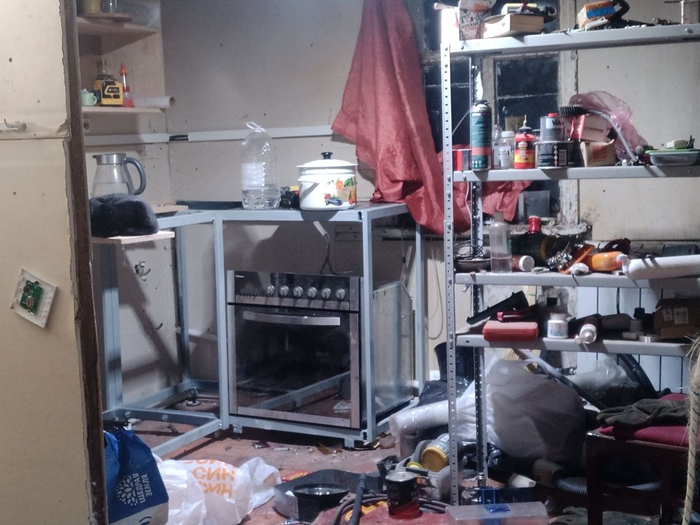
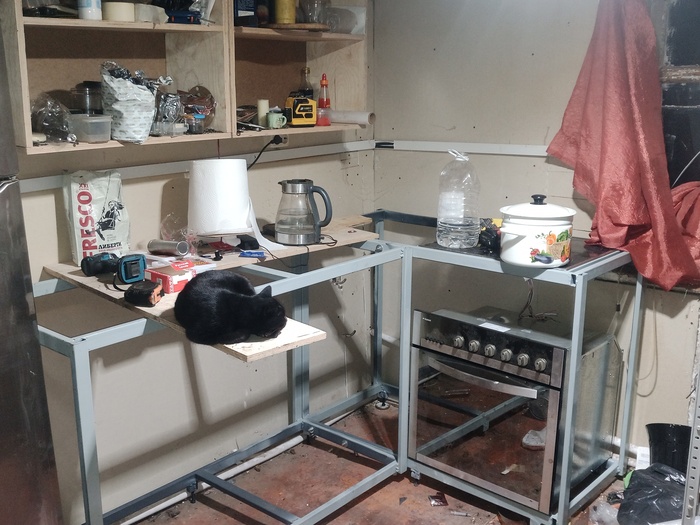
Я доделал каркас кухни. Успел до слякоти все сварить.
Все не могу окончательно вытащить разное небытовое барахло в колидор. Земли 100 литров, краска разная, инструменты - везде.
Из косяков - я просчитался на 15 сантиметров длинны). Не знаю как - тут наверное сыграла роль моя склонность все делать на глазок, а следовательно несколько халатно к измерениям относится. Пришлось вырезать из каркаса кусок. Обратно сваривал новыми электродами - goodel ок-46 gold 2,5. Думал говна какая нибудь, но нет,очень милые оказались электроды. И с отрывом и сплошняком. На 50 амперах работали даже, стабильно.
В общем неделю я между делом варил и резал. Набивал руку.
Обнаружил важный факт. Моя китайская маска тру колор - изза того что не блокирует синий, очень быстро приводит к усталости отчасти напоминающей легкий ожог УФ. Даже решил проверить - взял очки сертифицированые на блокирование все что выше меньше 400нм. Одел под маску. Эффекта ноль. Проблема именно в синем цвете. А точнее в сочетании того что он не заблокирован по умолчанию и неизбежного лага срабатывания светофильтра. На обычной маске с зеленым сфетофильтром без автоматики - такой пидерсии нет.
Итого, вывод - труколор с незаблокированым по умолчанию синим выбросить нахер.
Кошка апасна дрыхнет. Кухня в цвете 671, как буханка.
Из плюсов - ножки с 8 сантиметровым диапазоном регулировки не стали излишеством. Как раз выбрались все изгибы пола в заброшке пока выводил в горизонталь. На очереди выпилить столешницу, заодно напилить материала для книжных полок (есть мысль сделать их них нечто вроде дорожек для кошки, будут вдоль стен вести к ее халабуде в углу под потолком).
В эти выходные я бы уже занимался водой - нужно склеить наконец сетку на трубу и уронить все это в скважину. Но проявилась скотская суть Буханки. Ехал ехал, слышу дзыньк такой характерный. Болт который притягивает кронштейн ГУР к корпусу помпы отстегнулся. Это уже второй раз, и в этот мне не удалось обломок с ходу вывернуть, с одной стороны, а с другой - лопнула бобышка на помпе к которой он притягивался. Не сильно но плоскость потерялась. Ну и по давней традиции - я конечно же заменил почти новую помпу - ну тысяч 30 отъездила, изза этой мелочи. Может потом придумаю как надежно старую восстановить. Просится после извлечения обломка - на рассверливание и внедрение резьбы размером побольше - на 10. Заодно решил затестить шкив помпы, металлический (заместо текстолитового), двухременный, уменьшенного диаметра - вместо 110мм - 88 мм. Собрал все на болт попрочнее. Буду надеятсян а то что оный не лопнет.
Кроме этого форсмажера с буханью, я замещал руководителя отдела. И в этот раз хапнул норм. Во первых - датацентр яндекса приказал долго жить. На нас это не сильно сказалось, были перебои. Но отвалилась часть сервисов нам .net. А я половину и не знаю где они).
Потом на работе бизнес чтото конкретно перекатегоризировал, и система подрядчиков стала херачить сторно по всем документам с 1917 года. Весьма сомнительным кодом с затратами 50 миллиардов(!) чтений на миллион записей. И это на одном потоке брокера).
В общем, довольно напряженные были деньки.
Далее пришла наконец опора оси вал-сектора на ГУР, который я ушатал неподходящей выколоткой. Почти 3 недели лежала в РЦ 5пост. Уже написал им претензию. Но к удивлению - нашли и прислали. Вот тоже надо поставить пока машина на приколе. Далее - у меня установлена кастомная панель проводки за сиденьем водителя, чтобы не кромсать оригинальную проводку - отвод от АКБ. Завтра внедрю туда реле напряжения, которое будет отключать всю эту чещую при остановленном двигателе. Ну и заодно - подогрев батареи поставлю. Две пластины на 12 вольт, со скотчем 3М. Ну и если успею - уже займусь водой, подключу плиту, нажарю скумбрии себе).
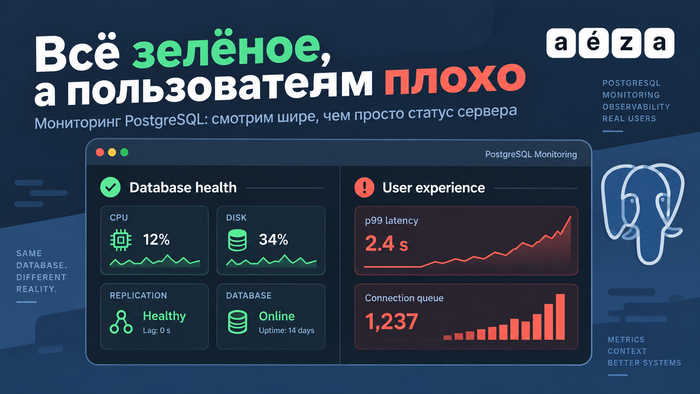
Давайте представим онлайн-кинотеатр в пятницу вечером. Вышла новая серия сериала, который многие ждали полгода, и минут через двадцать в поддержку начинают писать: поиск думает по десять секунд, кнопка «Смотреть» крутит колесо, а у части зрителей новой серии вообще нет в каталоге.
Дежурный открывает Grafana, а там всё зелёное. Процессор базы занят на треть, диск заполнен наполовину, PostgreSQL отвечает на проверки, реплика на месте. Панелей около трёхсот, и ни одна не горит.
Графики при этом не врут. Процессор правда свободен, место правда есть. Только они отвечают на вопрос «жив ли серверр», а человеку с попкорном важно то, сколько он ждёт.
По нашему мнению, у многих команд мониторинг базы собран из того, что легко измерить, и почти не помогает решить, что делать прямо сейчас. Косвенно это подтверждает опрос NeuBird, вендора ИИ-инструментов для дежурных: в феврале 2026 года компания опросила 1039 специалистов по SRE, DevOps и эксплуатации. У 78% хотя бы раз случался инцидент, на который не сработал ни один алерт. А 57% говорят, что по делу меньше 30% их алертов. Опрос вендорский, но картина узнаваемая: уведомлений много, а главное всё равно пропускают.
Что могло сломаться, пока всё зелёное
Для такой истории есть как минимум три сценария, и ни один из них не нагружает процессор.
Первый сценарий связан с очередью блокировок. В 20:55 выкатили миграцию с ALTER TABLE, которая добавляет колонку в таблицу фильмов. Для этого ей нужна самая строгая блокировка таблицы. А по той же таблице в это время идёт аналитический отчёт на двадцать минут. Миграция встаёт ждать отчёт, а все новые запросы к таблице, включая обычные SELECT из поиска, выстраиваются за миграцией. Запросы ничего не считают, они просто ждут, поэтому процессор отдыхает.
Во втором закончились соединения в пуле. Приложение ходит в базу через PgBouncer, а все 50 серверных соединений пула заняли медленные запросы и забытые открытые транзакции. Остальные клиенты стоят в очереди ещё до PostgreSQL, и сама база при этом может быть почти пустой.
В третьем каталог читает с реплики, а реплика отстала. Ошибок нет, просто зритель не находит серию, которая вышла десять минут назад, и жмёт «Обновить» снова и снова, добавляя нагрузку.
Все три проблемы видны в PostgreSQL, если знать, куда смотреть. Спорят о другом: что из этого должно будить дежурного, а что может спокойно лежать на дашборде.
Подход A: будить по состоянию базы
Здесь исходят из того, что база почти всегда предупреждает заранее. Соединения подбираются к лимиту, реплика отстаёт всё сильнее, растёт WAL (журнал, куда PostgreSQL сначала записывает каждое изменение), транзакции висят открытыми. Если поставить пороги на эти показатели, дежурный узнает о проблеме до первой жалобы.
Подводит обычно настройка. Пороги берут из готовых наборов правил и ставят одинаковыми для всех баз: «соединений больше 80%», «реплика отстаёт больше чем на 10 секунд». Для одной базы 80% соединений означают обычный вечер, для другой аварию. Со временем такие алерты начинают пролистывать, а вместе с шумом и настоящую проблему.
На это есть ответ: шум – беда плохих порогов. Порог можно считать от обычного уровня конкретной базы или от скорости роста: «слот держит уже 40 ГБ WAL и прибавляет по 5 ГБ в час». Такой алерт сразу говорит, куда смотреть. Рост p99 сообщает только, что кому-то плохо.
Подход Б: будить по тому, что чувствует пользователь
Здесь всё идёт от книги Google по SRE. Мониторинг там отвечает на два вопроса: что сломалось и почему. «Что» – это симптомы, которые видит пользователь, «почему» – причины внутри системы. Для симптомов предлагают четыре «золотых сигнала»: задержку, трафик, ошибки и насыщение. Если на алерт можно ответить механически, звонить дежурному незачем. Из причин будить стоит только по очень явным и близким, вроде «диск базы закончится через 4 часа».
Для PostgreSQL это значит, что на пейджер, то есть с ночным звонком, идут p99 ключевых операций, доля ошибок и время ожидания соединения. Блокировки, контрольные точки и диск остаются на дашборде, их открывают после того, как сработал симптом.
Минусы у этого подхода тоже есть. Метрики придётся встроить в каждый сервис, и ночью путь от «кому-то плохо» до причины получается длиннее. А главное, некоторые проблемы копятся неделями и никак не задевают пользователя до последнего момента. Когда симптом наконец появляется, база уже отказывается принимать запись.
p95 и p99: почему среднее успокаивает
Допустим, за минуту кнопку «Смотреть» нажали 1000 раз. 980 запросов отработали за 20 мс, а 20 упёрлись в блокировку строки и ждали по 3 секунды. Среднее получается около 80 мс. Вроде бы терпимо, алерт с порогом в 200 мс промолчит. p95, то есть время, в которое укладываются 95% запросов, показывает красивые 20 мс. И только p99 показывает 3 секунды: каждый пятидесятый зритель смотрит на колесо.
Считать процентили стоит по каждой операции отдельно и рядом показывать число запросов. Если поиск и «Смотреть» смешать в одну метрику, быстрый и частый поиск утопит медленную и редкую операцию. А если за час было пять оплат подписки, p99 по ним считать бессмысленно, хватит списка из пяти строк.
И ещё одно. Из стандартной статистики PostgreSQL процентили не достать. pg_stat_statements хранит для каждого запроса число вызовов, среднее, минимальное и максимальное время и разброс, а процентилей там нет. Их считают в приложении, обычно гистограммами в Prometheus, отдельно для ожидания соединения и для выполнения SQL. Так видно, где потерялось время – в очереди к базе или в самой базе.
Блокировки: очередь, которую не видно по процессору
Вернёмся к миграции. Алерт «в базе есть блокировки» тут бесполезен, потому что блокировки есть всегда, на них держится вся конкурентная работа PostgreSQL. Полезен ответ на вопрос, кто ждёт, сколько и из-за кого. Его дают представление pg_stat_activity и функция pg_blocking_pids():
-- кто ждёт блокировку и кто её держит, -- плюс сессии, которые оставили транзакцию открытой SELECT pid, now() - xact_start AS xact_age, now() - state_change AS in_state, state, wait_event_type, pg_blocking_pids(pid) AS blocked_by, left(query, 60) AS query FROM pg_stat_activity WHERE wait_event_type = 'Lock' OR state LIKE 'idle in transaction%' ORDER BY xact_start;
Отдельно присмотритесь к статусу idle in transaction. Запрос закончился, а транзакция открыта, потому что приложение, например, ушло ждать ответа от платёжного сервиса. Такая сессия держит блокировки и мешает очистке старых версий строк. Её можно ограничить через idle_in_transaction_session_timeout, а с версии 17 есть ещё transaction_timeout на всю транзакцию. Его лучше ставить на роль приложения, иначе он оборвёт и долгие отчёты.
Для миграций есть простое лекарство, lock_timeout. Если миграция не получила блокировку за пару секунд, она завершается с ошибкой и освобождает очередь. Повторить попытку придётся самим, PostgreSQL этого не сделает, зато сервис не встанет.
-- перед миграцией: ждать блокировку не дольше 2 секунд SET lock_timeout = '2s'; ALTER TABLE titles ADD COLUMN age_rating text;
Что увидит каждый подход? A сработает на правило «самая старая транзакция старше N минут» и, если повезёт, раньше пользователей. Но ночной отчёт тоже живёт долго, и порог придётся подбирать под каждую базу. B сработает на рост p99 у «Смотреть», а дежурный откроет запрос выше и быстро найдёт виновника. Долгие ожидания блокировок можно писать в лог и сейчас через log_lock_waits, а в PostgreSQL 19 (он пока в бете) его планируют включить по умолчанию и добавить представление pg_stat_lock.
Соединения: база свободна, а очередь стоит
В самой базе обычно смотрят число подключений относительно max_connections. Учтите, что часть мест зарезервирована (superuser_reserved_connections по умолчанию держит 3 слота для суперпользователей). Обычные клиенты упрутся в лимит раньше, чем график покажет 100%.
Если перед базой стоит PgBouncer, главный показатель живёт в нём. В выводе команды SHOW POOLS есть cl_waiting (сколько клиентов отправили запрос и ещё ждут серверное соединение) и maxwait (сколько секунд ждёт самый старый из них). Документация PgBouncer прямо пишет: если maxwait начал расти, пул не успевает обрабатывать запросы.
Подход A поставит здесь алерт на «занято 80% соединений». Подход Б поставит его на время ожидания соединения в приложении или на растущий maxwait. Второй вариант точнее. 80% занятых соединений при пустой очереди означают обычную работу, а секундная очередь бьёт по зрителям, даже если база загружена наполовину.
И не спешите поднимать размер пула или max_connections. Если соединения держат медленные запросы, новые подключения, как правило, только добавят конкуренции за память и диск.
Реплика, WAL и старые транзакции: здесь прав подход A
В pg_stat_replication есть поле replay_lag, задержка применения изменений на реплике. Когда реплика всё догнала и записи нет, оно через какое-то время становится NULL, а у отвалившейся реплики строки в представлении нет вовсе, и алерт на replay_lag промолчит. Если каталог читает с реплики, надёжнее раз в несколько секунд записывать текущее время в служебную строку на основной базе и читать её с реплики (часы серверов должны совпадать). Разница и есть отставание, которое видит зритель.
С WAL всё серьёзнее. Слот репликации запоминает, какой журнал потребитель ещё не забрал, и не даёт его удалить. Если потребителя нет, например реплику выключили или про логического подписчика забыли, слот держит WAL начиная с позиции restart_lsn. Каталог pg_wal растёт, пока не займёт диск, и тогда база остановится. До этого момента пользователь не замечает ничего.
-- запускать на основном сервере: сколько WAL держит каждый слот, -- safe_wal_size: сколько WAL ещё можно записать, пока слот не потеряет -- нужные файлы (заполнен, только если задан max_slot_wal_keep_size) SELECT slot_name, active, wal_status, pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained, safe_wal_size FROM pg_replication_slots;
В PostgreSQL 18 появился idle_replication_slot_timeout. По умолчанию он выключен, а включённый помечает недействительными слоты, которые простаивают дольше заданного времени. Такой слот придётся пересоздавать.
Самое неприятное здесь – переполнение счётчика транзакций (XID wraparound). У PostgreSQL в «окне» около двух миллиардов номеров транзакций, и старые номера нужно периодически «замораживать», этим занимается autovacuum. Если он не успевает, база начинает писать предупреждения, когда до предела остаётся 40 миллионов транзакций. А когда остаётся меньше 3 миллионов, перестаёт выполнять команды, которым нужен новый номер транзакции. Проще говоря, перестаёт принимать запись.
-- возраст самого старого незамороженного XID в каждой базе, -- предел около 2 млрд, принудительную заморозку autovacuum -- по умолчанию запускает после 200 млн (autovacuum_freeze_max_age) SELECT datname, age(datfrozenxid) AS xid_age FROM pg_database ORDER BY xid_age DESC;
Так в феврале 2019 года сломался Mandrill, сервис транзакционных рассылок Mailchimp. На одном из шардов кончились номера транзакций, и сбой длился около 40 часов. Ещё в ноябре 2018-го команда заметила, что счётчик прошёл примерно полпути, и завела в бэклог задачу на дополнительный мониторинг. Первое исключение ночью утонуло среди посторонних ошибок, а алерт на wraparound появился через полчаса после восстановления. Sentry в 2015 году наступил на те же грабли и лежал большую часть рабочего дня в США.
Пока счётчик растёт, p99 идеальный, и подход Б ничего не заметит. Поэтому возраст XID, место под WAL и состояние слотов мы бы держали на пейджере в любом случае. Порог по XID можно ставить с большим запасом, например на миллиард. Примерно на этой отметке Mandrill в ноябре и завёл свою задачу в бэклог. Только задача ждёт своей очереди, а алерт будит.
Диск и контрольные точки: смотреть вместе с задержкой
Во время контрольной точки (checkpoint) база сбрасывает на диск всё, что накопилось в памяти. Из-за неё и из-за диска мы бы ночью никого не будили. С 16-й версии время чтения и записи видно в pg_stat_io, но только при включённом track_io_timing. По умолчанию он выключен, и в колонках времени тогда стоят нули. Ещё в это время попадает чтение из кеша операционной системы, поэтому сам диск проверяют и через iostat или node_exporter.
Если точки из-за заполнения WAL идут чаще раза в 30 секунд, PostgreSQL сам напишет в лог «checkpoints are occurring too frequently» и посоветует увеличить max_wal_size. Разовое сообщение документация просит не считать поводом для тревоги, а частое вместе с ростом p99 на запись стоит разобрать. Только поднимать max_wal_size вслепую не надо: WAL займёт больше места, а восстановление после сбоя может затянуться.
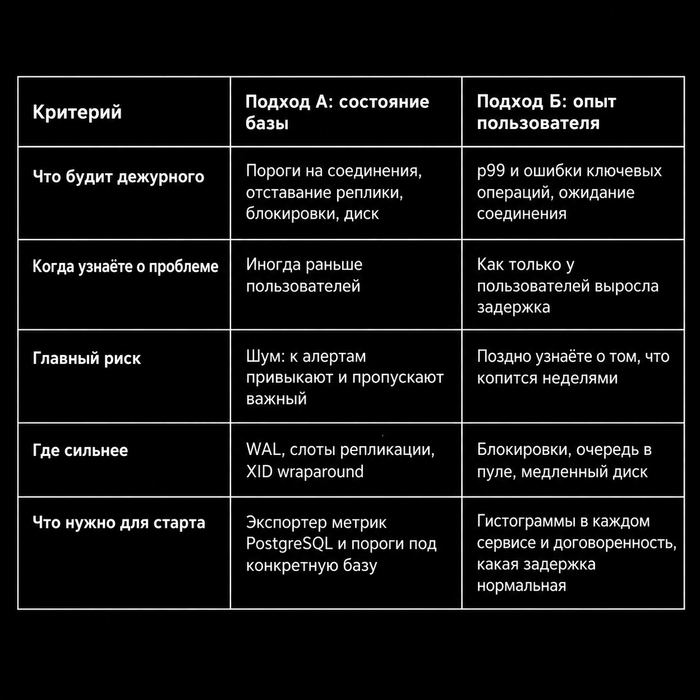
Сравним подходы
Как настроили бы мы
Мы за подход Б на пейджере и за короткий список исключений из подхода A. Дежурного стоит будить, когда пользователям плохо: вырос p99 ключевых операций, выросла доля ошибок, клиенты ждут соединение. И отдельно, когда кончается ресурс, о котором пользователь узнает слишком поздно. Это запас номеров транзакций, место под WAL и состояние слотов, свежесть реплики, если с неё читают. Остальное лежит на дашборде и открывается после первого алерта.
Для каждого алерта мы бы задавали один вопрос. Понятно ли, что делать, если он пришёл в три часа ночи? Если ответ «посмотреть и закрыть», ему место на дашборде.
Хорошее ночное сообщение выглядит примерно так: «„Смотреть“: p99 4,2 с при обычных 300 мс. 37 сессий стоят в очереди к titles за ALTER TABLE (pid 81234), а он ждёт отчёт (pid 80112)». Плохое: «Активных соединений 80%». Первое сразу говорит, кому плохо и куда смотреть. Со вторым дежурный идёт листать те самые триста панелей.
Подход A выигрывает, когда приложение не размечено метриками и разметить его нельзя, скажем, в старом монолите, к коду которого боятся прикасаться. Тогда пороги по базе лучше, чем ничего. Только подбирать их придётся под конкретную базу и её обычную нагрузку, готовые правила из интернета подведут.
А как устроено у вас? Какой алерт PostgreSQL последний раз действительно спас ночь, а какой мигает месяцами, и его давно никто не читает? Если вы уверены, что будить дежурного надо по состоянию базы, расскажите в комментариях, где подход Б вас подвёл.
Получите 15% кешбэка на первое пополнение только в Aéza
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2Ranykm7iYj
Alex Monahan из MotherDuck собрал связку Qwen3.8 27B и DuckDB для работы с данными. Он настроил её на MacBook Air M5 с 32 ГБ памяти и MacBook Pro M1 Pro с 16 ГБ, а затем проверил на более чем 400 задачах DABstep.
В тесте Qwen превзошла GPT-5.6 Luna Max по соотношению точности и стоимости: точность составила 98,6% у 4-битной версии и 96,4% у 3-битной. Самой точной в сравнении оказалась Gemini 3 Flash.
Прогон Qwen обошёлся менее чем в $0,50 за электричество против более $8 у GPT-5.6 Luna Max. Но ответы были медленнее: около 5–6 минут на вопрос против примерно 40 секунд у GPT и 25 секунд у Gemini. Это собственный эксперимент автора; при подготовке контекста он также использовал облачную модель.
Оптимизация запроса, в котором выборка всего из одной таблицы по полю, на котором итак был индекс! Разбираемся почему индекс не работал! Команда EXPLAIN.
Больше полезного про базы данных и SQL найдешь в моём Телеграм канале или на Дзене.
Если вы хоть немного следите за развитием искусственного интеллекта, то наверняка замечали: терминов становится всё больше.
И происходит путаница, подмена понятий. И вообще не понятно "что было первым: курица или яйцо"
В моем канале Аналитика FM выпуски про бизнесовые метрики в разных бизнесах, про особенности SQL запросов и работы аналитика. Канал я веду с нуля подписчиков, рассказываю про аналитику и разбираю различные кейсы на реальных примерах. И серия постов про путь до ai агентов. Подписывайся, если интересно как устроен мир аналитика!
Какие термины этого направления окружают нас: - Машинное обучение - Нейросети - Deep Learning - Generative AI - Foundation Models - LLM - AI-ассистенты - AI-агенты - Multi-Agent Systems - Agentic Systems
Иногда возникает ощущение, что все это - просто разные названия одного и того же. Но это не так.
Проблема в том, что эти термины описывают разные уровни технологий. Одни говорят о том, как система обучается. Другие - о том, какая модель используется. Третьи - о том, какой продукт построен вокруг модели. А четвёртые - уже о том, как система самостоятельно выполняет задачи и взаимодействует с другими системами.
Как вообще дошли до AI-агентов?
Если сильно упростить историю, путь можно представить как движение от:
Научить компьютер находить закономерности
к:
Научить компьютер самостоятельно решать сложные задачи
Сначала компьютеры просто выполняли инструкции, которые заранее написал человек.
Потом появились методы машинного обучения, где система могла находить закономерности в данных.
Затем развивались модели, способные работать с гораздо более сложными типами информации: изображениями, текстом, речью, видео.
С развитием глубоких нейронных сетей появились современные генеративные модели, которые научились не только классифицировать или прогнозировать, но и создавать новый контент.
Дальше появились большие универсальные модели, которые можно использовать как основу для множества разных задач.
И наконец вокруг моделей начали строить полноценные приложения и системы: с памятью, инструментами, базами данных, API и возможностью выполнять действия.
Так постепенно мы пришли к тому, что сегодня называют AI-агентами.
Но модель и агент - это совсем не одно и то же
Представим обычную языковую модель.
Мы пишем:
Проанализируй эти данные и найди закономерности
Модель анализирует то, что ей дали, и возвращает ответ.
Теперь представим другую систему.
Мы говорим:
Каждое утро проверяй продажи. Если найдёшь аномалию - выясни причину и подготовь отчёт
Такая система уже может:
получить данные
обратиться к базе
выполнить запрос
проанализировать результат
понять, что делать дальше
использовать дополнительные инструменты
проверить результат
сформировать отчёт
отправить его человеку
То есть между "моделью, которая отвечает" и "системой, которая выполняет задачу" появляется целый набор дополнительных компонентов.
И именно этот переход сейчас особенно интересен.
Поэтому AI - это не одна технология
Когда мы говорим "искусственный интеллект", мы часто представляем что-то единое. На практике это скорее большая экосистема. Внутри неё находятся:
методы обучения
алгоритмы
модели
нейронные сети
генеративные модели
большие языковые и мультимодальные модели
приложения
ассистенты
инструменты
агенты
системы из нескольких агентов
И всё это может работать вместе.
Например, современный AI-агент может использовать языковую модель, обращаться к базе данных, вызывать API, читать документы, хранить состояние задачи и передавать результат другому агенту.
Поэтому, когда говорят:
Компания внедряет AI
это ещё почти ничего не говорит о том, что именно они внедряют. Это может быть обычная ML-модель для прогнозирования. Может быть генеративная модель. Может быть чат-ассистент. А может быть целая агентная система, которая выполняет бизнес-процесс.
Чем дальше мы двигаемся от модели к агентной системе, тем меньше AI выглядит как отдельный инструмент и тем больше - как участник рабочего процесса.
Модель:
отвечает.
Ассистент:
помогает.
Агент:
действует.
Агентная система:
может организовывать выполнение целого процесса.
Именно поэтому сейчас так много разговоров об AI-агентах.
Но чтобы действительно понимать, что они собой представляют, полезно сначала разобраться, из каких уровней вообще состоит эта технология.
Я как раз решил разобрать этот путь последовательно - от самых фундаментальных понятий до современных агентных систем.
Не одним огромным постом на 20 экранов, а серией коротких разборов, где каждый следующий уровень будет опираться на предыдущий.
📌 От машинного обучения и понятия модели - к нейросетям, генеративному AI, LLM, AI-приложениям, ассистентам, агентам и в итоге к Agentic Systems.
Подписывайся на мой телеграмм канала Аналитика FM! Будем разбираться вместе! Плюс там различные нюансы и особенности работы аналитика.