Доклады с большой бесплатной конференции PythoNN в Нижнем Новгороде
Пост с итогами конференции: https://t.me/opensource_findings/992
В порядке выступлений:
Жду всех в следующем году!
Показать полностью
5
Пост с итогами конференции: https://t.me/opensource_findings/992
В порядке выступлений:
Жду всех в следующем году!
При пакетной обработке PDF-документов часто требуется добавить единую нумерацию страниц в уже существующие файлы. С помощью Spire.PDF for Python можно выводить динамические номера страниц непосредственно на холст существующего PDF, без создания отдельного PDF-файла и последующего объединения.
В этой статье показано, как разместить номера страниц по центру нижнего колонтитула. Основное внимание уделяется настройке формата нумерации — например, Страница X или X / Y — и использованию координат для размещения номеров в любой области страницы: слева, по центру или справа в нижнем колонтитуле либо в любом месте верхнего колонтитула.
Единицы измерения: координаты PDF задаются в пунктах, где 1 пункт = 1/72 дюйма. Начало системы координат находится в левом верхнем углу страницы: X увеличивается вправо, а Y — вниз.
Установите необходимую библиотеку:
pip install spire.pdf
Для нумерации страниц используются два динамических поля:
PdfPageNumberField : представляет номер текущей страницы и при отрисовке заменяется фактическим номером.
PdfPageCountField : представляет общее количество страниц и при отрисовке заменяется соответствующим значением.
Это динамические поля, а не строки с заранее заданными значениями. Благодаря этому при отрисовке нумерация учитывает количество страниц документа.
PdfCompositeField объединяет статический текстовый шаблон и динамические поля в одну строку. Формат номера страницы определяется строкой шаблона , поэтому для изменения формата достаточно изменить эту строку.
Базовый синтаксис:
compositeField = PdfCompositeField(font, brush, "Текст шаблона", [field1, field2, ...])
Здесь {0} соответствует первому полю в списке, {1} — второму и так далее.
В следующем примере используется формат Страница {0} из {1}. Номера страниц размещаются по центру нижнего колонтитула, над ними добавляется разделительная линия:
from spire.pdf.common import *
from spire.pdf import *
# Создать объект PdfDocument
doc = PdfDocument()
# Загрузить локальный PDF-файл
doc.LoadFromFile("input.pdf")
# Задать шрифт, кисть и перо
font = PdfTrueTypeFont("Arial", 14.0, PdfFontStyle.Regular, True)
brush = PdfBrushes.get_Black()
pen = PdfPen(brush, 1.0)
# Задать отступы
leftMargin = 54.0
rightMargin = 54.0
bottomMargin = 72.0
# Создать поля для номера текущей страницы и общего количества страниц
pageNumberField = PdfPageNumberField()
pageCountField = PdfPageCountField()
# Объединить поля с помощью русскоязычного шаблона нумерации
compositeField = PdfCompositeField(
font, brush, "Страница {0} из {1}", [pageNumberField, pageCountField]
)
# Перебрать все страницы
for i in range(doc.Pages.Count):
page = doc.Pages.get_Item(i)
pageSize = page.Size
# Нарисовать разделительную линию в нижнем колонтитуле
page.Canvas.DrawLine(
pen,
leftMargin,
pageSize.Height - bottomMargin + 15.0,
pageSize.Width - rightMargin,
pageSize.Height - bottomMargin + 15.0
)
# Измерить текст номера страницы для расчёта положения по центру
text = "Страница {} из {}".format(i + 1, doc.Pages.Count)
pageNumberSize = font.MeasureString(text)
# Задать положение номера страницы: по центру по горизонтали
compositeField.Location = PointF(
(pageSize.Width - pageNumberSize.Width) / 2,
pageSize.Height - bottomMargin + 18.0
)
# Вывести номер страницы
compositeField.Draw(page.Canvas, 0.0, 0.0)
# Сохранить новый файл
doc.SaveToFile("Output/CenterAlignedPageNumbers.pdf")
# Освободить ресурсы
doc.Dispose()
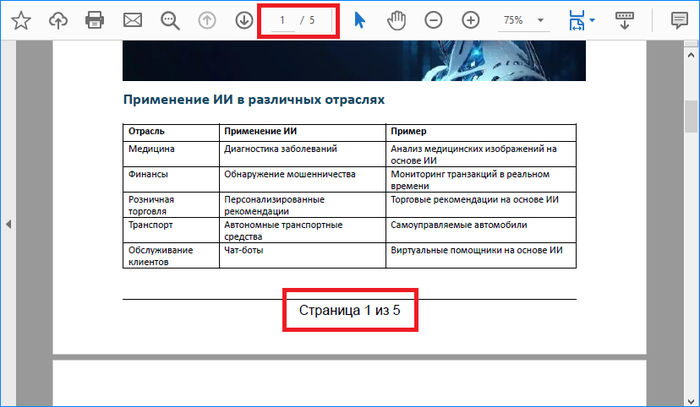
Формат нумерации зависит от строки шаблона и переданных динамических полей. Ниже приведены несколько распространённых вариантов. Замените третий аргумент PdfCompositeField и при необходимости измените список полей.
Для этого формата требуется только поле номера страницы:
compositeField = PdfCompositeField(
font, brush, "Страница {0}", [pageNumberField])
Формат 2: компактная числовая запись — X / Y
compositeField = PdfCompositeField(
font, brush, "{0} / {1}", [pageNumberField, pageCountField])
Формат 3: текущая страница и общее количество страниц — Страница X / Всего страниц: Y
compositeField = PdfCompositeField(
font, brush, "Всего страниц: {1}", [pageNumberField, pageCountField])
Формат 4: только общее количество страниц — Всего страниц: Y
compositeField = PdfCompositeField(
font, brush, "Всего страниц: {1}", [pageNumberField, pageCountField])
Примечание: поле может присутствовать в списке, но не использоваться в шаблоне — в таком случае оно просто не отображается. Заполнители полей можно комбинировать в любом порядке, а окружающий текст и разделители, например «Страница», «из», «Всего страниц» или «/», — изменять в соответствии с требованиями к оформлению.
Положение номера страницы задаётся через compositeField.Location = PointF(x, y):
По центру: x = (ширина страницы - ширина текста) / 2
Слева: x = leftMargin
Справа: x = pageSize.Width - pageNumberSize.Width - rightMargin
По вертикали: изменяйте Y, чтобы перемещать текст вверх или вниз. Чем меньше Y, тем ближе текст к верхнему краю страницы, что позволяет разместить его в верхнем колонтитуле.
Следующий пример сочетает пользовательский формат и положение: нумерация X / Y с выравниванием по правому краю нижнего колонтитула.
compositeField = PdfCompositeField(
font, brush, "{0} / {1}", [pageNumberField, pageCountField]
)
for i in range(doc.Pages.Count):
page = doc.Pages.get_Item(i)
pageSize = page.Size
text = "{} / {}".format(i + 1, doc.Pages.Count)
pageNumberSize = font.MeasureString(text)
# Выравнивание справа: X = ширина страницы - ширина текста - правый отступ
compositeField.Location = PointF(
pageSize.Width - pageNumberSize.Width - rightMargin,
pageSize.Height - bottomMargin + 18.0
)
compositeField.Draw(page.Canvas, 0.0, 0.0)
В примере используется Arial. Если этот шрифт недоступен в вашем окружении, замените его другим установленным шрифтом. Для русского и другого многоязычного текста выбирайте шрифт, поддерживающий необходимые символы.
Если номера страниц перекрывают существующее содержимое, измените их координаты и разместите в свободной области. Переменные отступов в этих примерах управляют положением отрисовки: они не создают дополнительное свободное пространство и не изменяют расположение существующего содержимого.
Этот подход позволяет независимо настраивать формат номера страницы и его положение. Изменяйте строку шаблона, чтобы переключаться между вариантами Страница X, X / Y и Страница X из Y, а затем корректируйте координаты Location, чтобы разместить текст в нужном месте нижнего или верхнего колонтитула. Такая гибкость удобна для применения единого формата нумерации при пакетной обработке PDF-документов.
Привет, Пикабушники!
Когда-то писал здесь, как после девяти лет работы с 1С решил попробовать себя в Python. Тогда получал от 200 тысяч в регионе, руководил IT-отделом во франче и по вечерам делал телеграм-ботов. Первым был бот для скачивания видео, которого я сюда и пришел показать.
Подумал, что пора написать продолжение. Тем более рассказать уже есть про что (прошло 3 года с прошлого поста, интересно, какая статья будет следующая через еще 3 года).
Из 1С я в итоге так и не ушел. Зарплата сейчас уже от 450 тысяч, всё еще живу в регионе, в этом плане не жалуюсь. Готовлюсь к экзамену на «1С:Эксперт по технологическим вопросам». В общем, переквалификация пошла по своему сценарию))
За это время в работе появился ИИ. Использую Codex, Claude Code, Cursor, MCP и навыки для агентов. В 1С это тоже вполне применимо, код руками уже практически не пишу)))
Но временами от 1С всё равно устаю. Даже когда нормально платят и в целом всё устраивает, иногда хочется чего-то нового.
Жена играет в «Клуб Романтики». Посмотрел, что это вообще такое, узнал, что у жанра большая аудитория. Давно было желание сделать похожую игру, а тут появились все возможности. Решил попробовать.
Получилась романтическая визуальная новелла. Приложение называется «Секретные вечера», а первая история внутри «Письма без подписи».
Игра в первую очередь для девушек. Некоторые сюжетные повороты мужчинам могут показаться аморальными)))))
Пока разбирался с жанром, стало интересно, что именно в нем цепляет. Девушкам хочется романтики, кому-то интриги, кому-то просто побыть героиней истории, где вокруг тебя что-то происходит и от твоих решений многое зависит. Можно пофлиртовать с персонажем, выбрать что-нибудь рискованное и посмотреть, чем закончится.
В «Письмах без подписи» героиня начинает получать анонимные письма от человека, который знает о ней слишком много. Дальше отношения, подозрения и решения, с последствиями которых придется разбираться.
Первый сезон готов целиком: 12 глав, есть разные финалы.
Теперь немного про техническую часть.
Основу сделал на Ren’Py движок для визуальных новелл, в котором используется Python. Он занимается диалогами, картинками, переходами между сценами и сохранениями. Поверх этого уже сделаны отношения с персонажами, сюжетные условия и выборы.
Игру собрал для браузера и встроил в Telegram Mini App. Открываешь бота, запускаешь игру и читаешь прямо в телеграме. Отдельно регистрироваться не надо, есть апк для андройда и можно собрать для IOS, но пока не хочется заморачиваться, тем более с гражданством рф с этим делом есть нюансы.
Серверная часть тоже на Python: FastAPI, база SQLite. Там хранятся данные игрока, игровой баланс, открытые сцены и облачные сохранения. Аккаунт привязан к Telegram, поэтому можно продолжать с другого устройства. Всё это крутится на VPS через Docker Compose, игру и запросы к API обслуживает Caddy.
По ходу добавил статистику прохождения и обратную связь, пока мониторю) Интересно, где люди бросают читать, какие варианты выбирают и доходят ли вообще до финала.
Кроме облачных ИИ-инструментов использовал свой домашний комп (не основной, работаю с ноута, эта рабочая станция на убунту):
Ryzen 9 9900X, материнка MSI MAG X870E TOMAHAWK WIFI.
64 ГБ оперативки Kingston FURY Beast.
Две GeForce RTX 3090 GamingPro 24 ГБ.
NVMe Kingston KC3000 на 2 ТБ.
Блок питания Chieftec Polaris Pro на 1300 Вт.
Водянка MSI MAG CORELIQUID I360 и корпус MONTECH KING 95 PRO.
На нем локально запускал ComfyUI. Для картинок использовал Qwen-Image, для редактирования Qwen-Image-Edit-2509, с ускоряющими Lightning LoRA на 8 шагов. Для удаления фона у персонажей BiRefNet. Музыку генерировал через ACE-Step 1.5 turbo.
Правда, по ходу разработки часть арта стал делать через генерацию изображений в Codex: результат мне понравился больше (так что мощный комп нынче для таких дел почти не нужен, только для эмбендингов локальных).
ИИ в разработке использовал много, да что тут греха таить, практически всё сделал за меня))))
На мне: утвердить сюжет, проверять результат, искать ошибки, заставлять перерисовывать картинки.
Есть несколько агентов, арт директор, виртуальные читательницы, которые проверяют сюжет и дают обратную связь, пишут когда догадались про развязки сюжета и почему.
Для меня это хобби и возможность переключиться после работы. В 1С платят хорошо, уходить прямо не собираюсь, но делать что-то свое тоже хочется, тем более в индустрии в связи с развитием технологий будут изменения и хочется найти свою тихую гавань.
Игра бесплатная, без рекламы. Сейчас больше всего интересно понять, захочет ли в неё играть кто-то кроме меня. Если жены или девушки любят такие истории, можете им дать на тест)))
Монетизировать пока смысла нет, попробуем доработать и найти свою аудиторию и не бросить на половине пути, как это обычно бывает.
В апреле 2023 года мы запустили необычный для нас проект - ремонтный сервис нового формата. Первого клиента нашли только в начале лета, но уже с первого проекта удалось достичь запланированной прибыли. Расскажу, как мы создали современную компанию для поколения "новых денег", которые не готовы к тому, что прораб будет класть половину стоимости ремонта себе в карман, а сроки растягиваются без ограничений и почему это оказалось прибыльным бизнесом.
Как всё начиналось
Конец 2022 года. Я работал менеджером проектов в крупной IT-компании, мой друг Антон - тимлидом в другой известной технологической компании, а Дима занимал позицию backend-разработчика в третьей. У всех стабильные зарплаты, интересные проекты - жизнь шла своим чередом, пока Антон не решил купить квартиру в новостройке.
После долгих поисков он остановился на 85-метровой квартире в ЖК около метро Саларьево - современный комплекс с подземным паркингом и зелёным двором. Как типичный программист, к поиску ремонтников он подошёл педантично: изучил десятки предложений, провёл собеседования с кандидатами. В итоге выбрал бригаду с Авито с "15-летним опытом работы".
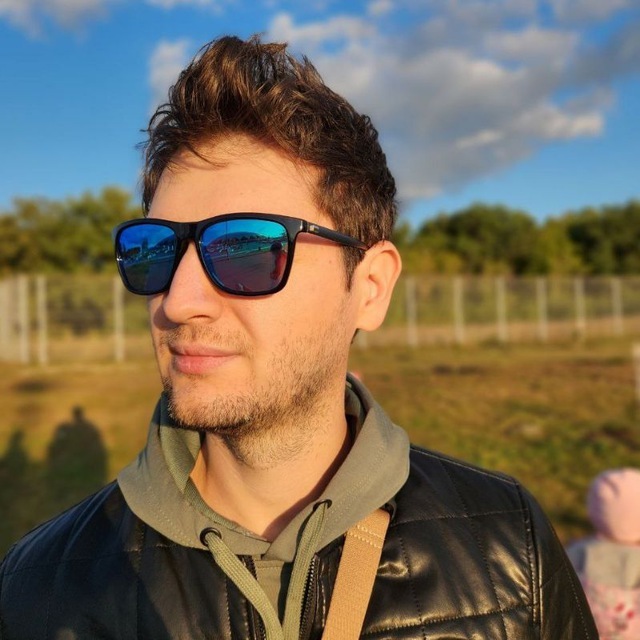
Денис (это я:) - один из создателей сервиса
За время ремонта у Антона мы с Димой часто приезжали к нему - помочь, посоветовать, и просто поржать над очередными косяками строителей. У нас обоих за плечами был серьёзный опыт управления командами, внедрения процессов, автоматизации и контроля качества. И знаете что? Нам казалось, что главное в ремонтном бизнесе - это грамотный менеджмент и организация процессов. И на самом деле, все примерно так и есть.
День когда мы решились
Если честно, мысли о собственной ремонтной компании появились у нас задолго до этого случая. В IT-тусовке часто шутят, что в России есть три верных пути: вебкам, айти и стройка. И мы, насмотревшись на хаос в ремонтной сфере, не раз обсуждали возможность открытия своей “фирмы”.
Мы выделили основные проблемы, которые должны были исправить с помощью своего сервиса
Первое - это постоянно растущие сметы и "задранная стоимость" на работы. Ну вы серьезно? Почему для меня ремонт в квартире должен чем-то отличаться от заказа носков на Вайлдберриз? Почему-то там нет такого, что цена носков может вырасти в 2 раза за время доставки. А тут начальная смета в 1 миллион превратилась почти в 1,7! И каждый раз это "ой, тут стены кривые", "ой, а тут придется докупить", "ой, а это мы не учли".
Второе - это бесконечно растущие сроки. Это еще хуже. Как люди с опытом в менеджменте, мы прекрасно знали, что растущие сроки – это всегда раздолбайство управления и ленивые рабочие. Но тут было чуть посложнее, об этом чуть позже. У Антона обещали сделать за 4 месяца, а в итоге растянули на 8.
Третье - хитрые прорабы. Это вообще отдельная история. Когда прораб говорит "давайте я сам закуплю материалы, у меня скидки", знайте - он накинет сверху процентов 30-40. А еще есть "срочные работы", которые почему-то не были учтены в смете. И конечно, вечная классика - экономия на материалах: заказываешь одно, а привозят что-то попроще, но по той же цене.
Целевая аудитория
А параллельно с этим мы определили нашу целевую аудиторию. Чтобы выделиться на конкурентном рынке, мы решили ориентироваться на молодых IT-специалистов и представителей “современных” профессий, живущих в Москве в возрасте 30-40 лет. Тех, кто покупает квартиру в новостройке и привыкших к хорошему сервису. Кто не готов, что его будут водить за нос и разводить на деньги.
Что с ценой?
При этом очень важно было держать цены НИЖЕ, чем у других компаний, иначе на рынке просто не выжить. В премиум сегмент нужен "пропуск" в виде большого количества работ для определенного типа клиентов, поэтому нам было понятно, что "брать" много - пока что, непозволительно. Но мы нашли способ: автоматизация процессов, прямые поставки материалов, четкое планирование работ и никаких скрытых накруток. Но несбыточной мечтой это покажется только обывателю: на самом деле сервис и правда должен быть таким, вообще любой.
История первого заказа летом 2023 года
А теперь самое интересное - наш первый заказ. Это была отдельная эпопея. Начало лета 2023, звонок от потенциального клиента.
Первый клиент оказался прямо "в яблочко" - тоже айтишник (пришедший из первой контекстной рекламы в яндексе запущенной на 20 тыс.), работал в крупной компании, купил двушку в панельке 80-х годов. Причем достаточно убитую - стены местами с дырками, старый паркет, трубы помнящие еще Горбачева... Но нам, если честно, даже повезло что первый объект был не новостройкой. На старом фонде учиться легче - там хотя бы есть на что посмотреть, в отличие от новостроек, где все "сюрпризы" спрятаны в голых стенах.

Дырка в стене была ДО демонтажа. Клиент купил квартиру с "убитым" ремонтом подешевле, в надежде сэкономить
Как мы мастеров искали
Начали с поиска бригады. Вот тут был первый холодный душ - оказалось, что найти классных специалистов без своей наработанной базы очень сложно. Мастера хорошего уровня либо уже при деле, либо просят космос. А те, кто сразу соглашается - ну, вы понимаете. За две недели провели больше 10 собеседований (назовем их так😊). Причем процесс собеседования мы сразу сделали "как в айти" - тестовые задания, проверка портфолио, разбор технологий работы. Бригадиры были в шоке - некоторые прямо уходили с собеседований, когда мы начинали распрашивать про технологии укладки плитки и показывали фотографии косяков с объектов с форумов.
В итоге нашли бригаду - два брата, которые до этого работали в крупной ремонтной компании, но ушли потому что устали от "серых" схем – по отношению К НИМ ЖЕ. В основном - задержки з/п и прорабы.

В том же санузле, но уже после демонтажных и некоторых черновых работ. Братья очень помогли нам с первым ремонтом, кроме этого, они дали нам контакты проверенных рабочих, которые впоследствии делали ремонт вместе с ними
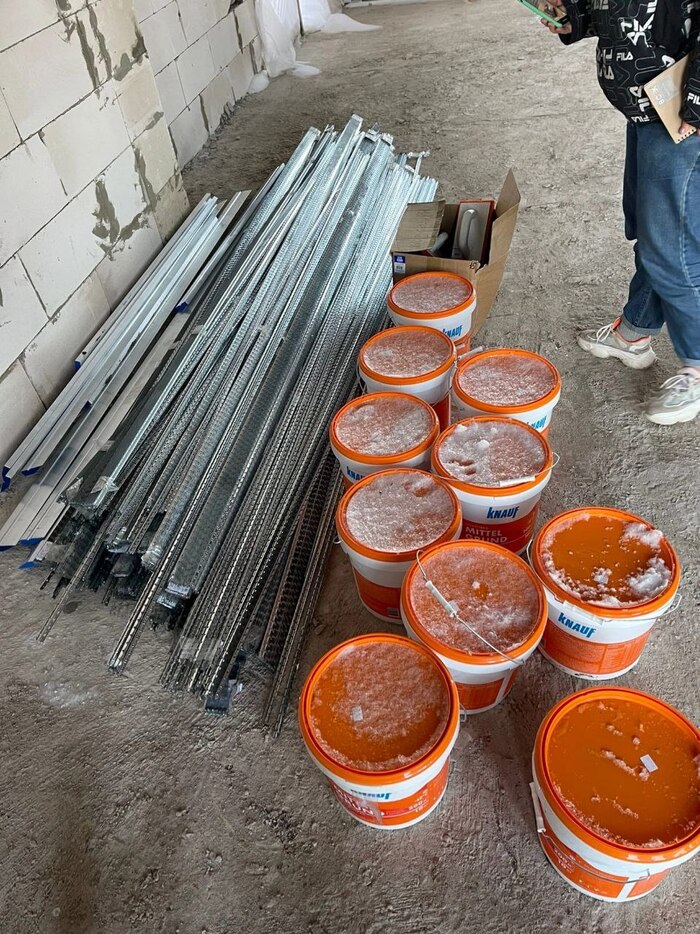
Купили первый комплект инструмента - это отдельная история на 100 тысяч рублей. Ещё сразу купили свою тепловую пушку - это из необычного. Большинство компаний привлекают "потолочников" на субподряд. Мы захотели сразу начать формировать свой инструментарий для будущих сотрудников. Зато потом эта закупка очень помогла - не зависели от того, что принесет с собой бригада. Позже, когда начали расширяться купили свою штукатурную станцию. Это, на удивление, было самой выгодной покупкой.
Первые сложности
Начали ремонт. И тут поехало... Первый сюрприз - когда начали снимать старую штукатурку, оказалось что стены буквально рассыпались. Плюс под старым линолеумом в коридоре нашли деревянный пол с насыпью под ним.
Тут был первый серьезный разговор с заказчиком. Объяснили ситуацию, показали все фотки, рассказали что сколько будет стоит в соответствии с прайс-листом. Тут очень помогло то, что мы сразу взяли за правило - фотографировать вообще все. Каждый этап, каждый слой, каждую трубу.
С материалами тоже было весело. Первый месяц я лично объездил все крупные строительные магазины в радиусе 30 км. Искал поставщиков, договаривался о скидках. Помню, как чуть не купили партию плитки по "супер-выгодной" цене, а потом выяснилось что это условно "второй сорт" - брак, который продают через "серые" схемы.
Cделали систему закупок: (Первый заказ полностью сделан из материалов, купленных в Петровиче и на маркетплейсах). Бригада присылает список - мы проверяем цены у 3-4 поставщиков и заказываем где дешевле.
Мы сразу внедрили систему ежедневных фото-отчетов и еженедельных созвонов. Плюс сделали чат в телеграме, куда скидывали все чеки, все накладные, все фотки. Такая прозрачность очень помогла - клиент видел, что мы не химичим с ценами и не пытаемся на нем нажиться.
В итоге сделали.
Братья советовали нам недостающих специалистов по ходу ремонта и постепенно, укладываясь в срок мы сдавали клиенту новый и новый этап. Честно, это было не так сложно как казалось в начале, но нужно понимать, что на самом деле, проблем по ходу ремонта и мелких трудностей было ОЧЕНЬ много, просто мы как люди привыкшие, понимали что сейчас это и есть наша работа , за которую нам платит клиент - взять на себя все заботы по ремонту. Но серьезных форс-мажоров не возникало, максимум понервничали, когда внесли предоплату потолочникам, которых нашли по объявлению, после чего они явно начали задерживать сроки, но в итоге, все обошлось. Нам и до этого было ясно, что чем быстрее мы соберем свой , хотя бы, небольшой штат, тем лучше и выгоднее. Но для этого надо быть уверенным в постоянном потоке заказов, что мы на тот момент, не могли себе позволить.
Главное - мы поняли как надо и как не надо. Все закупки только через нас. Все договоренности - только в письменном виде.
По деньгам первый проект получился условно в ноль - не считая наших вложений в инструмент и рекламу. Но мы получили бесценный опыт, наработали связи с поставщиками (если это можно назвать так пафосно) и главное - поняли, что наша модель рабочая, хотя на тот момент не были в этом до конца уверены. Наши сомнения развеяло лето 2023 года.
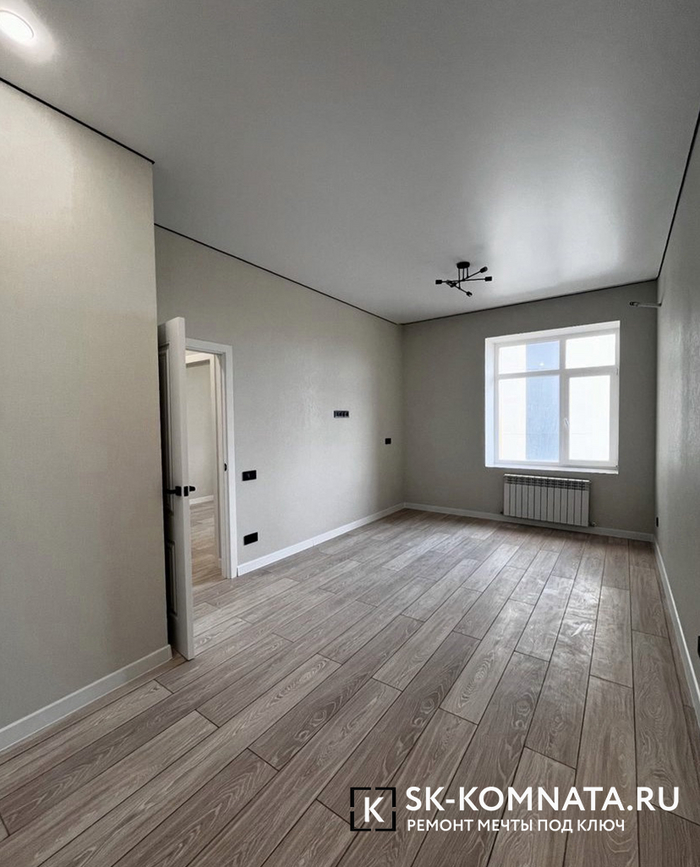

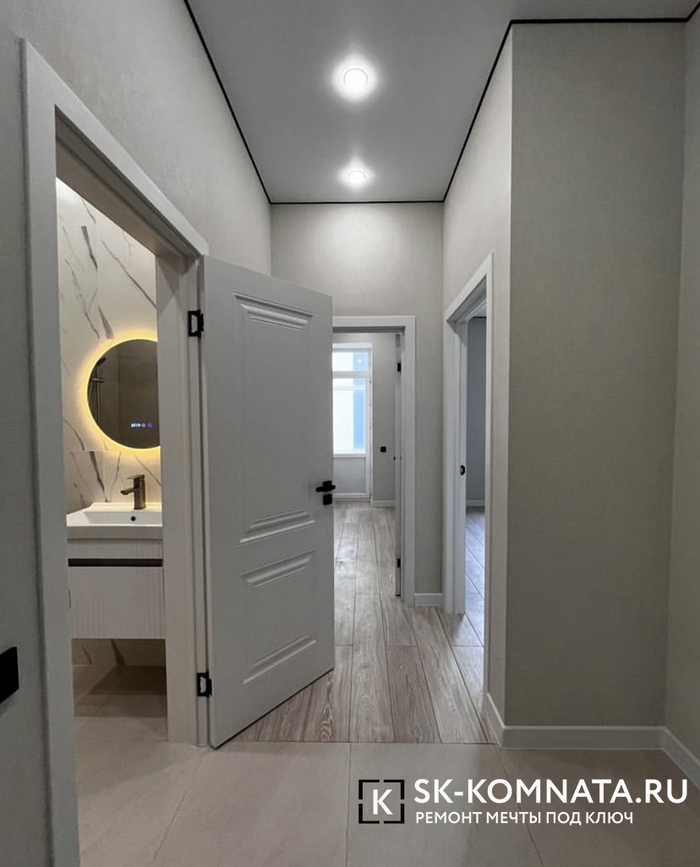
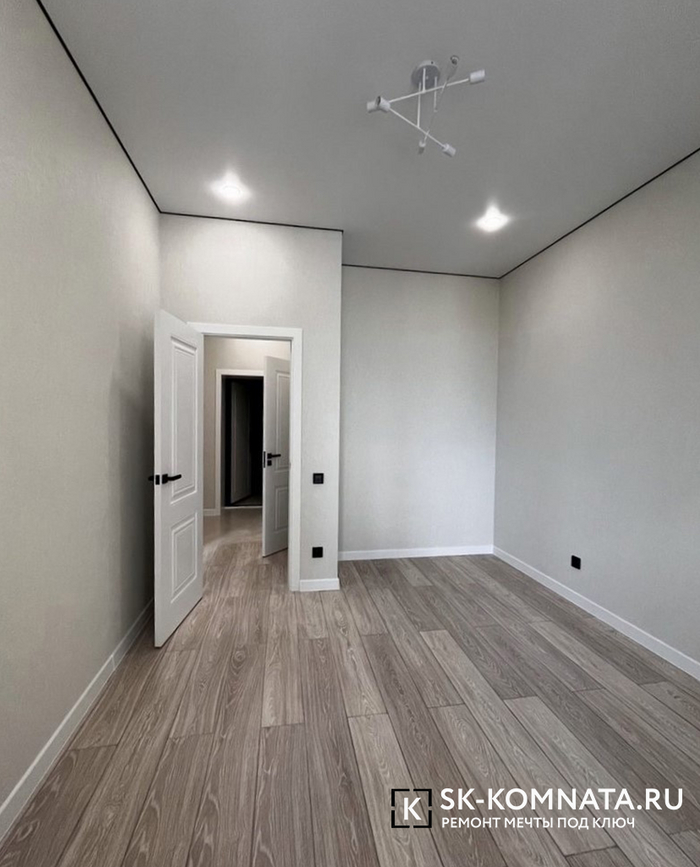
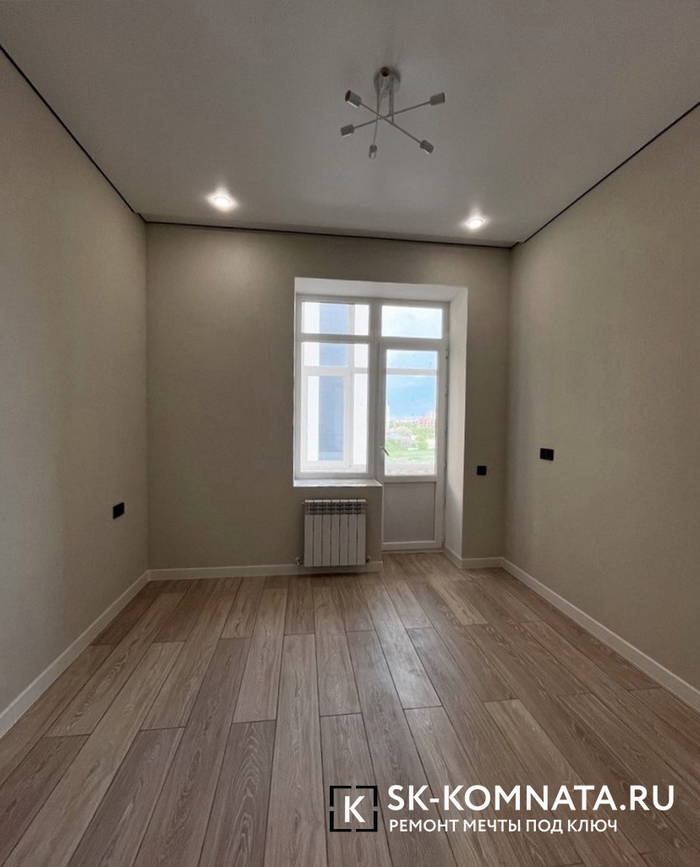
Наша первая работа, которую нам помогли закончить "братья", советуя недостающих мастеров на каждый этап работ. Цена работ для заказчика вышла 750 000 рублей. Летом 2023 года, за аналогичный объём работ авитовские бригады просили до миллиона(!)
Сайт и маркетинг или как мы общаемся с клиентами ещё до первого звонка
Кстати, про сайт. Первую версию мы сделали за пару вечеров на Тильде - максимально простую: фотки, цены, контакты. Знаете что? Он у нас до сих пор такой – но с значительно изменённым UI/UX. Я иногда ловлю себя на мысли - вот мы же, можем сделать что-то крутое, с личным кабинетом, онлайн-сметами... Но потом смотрю вордстат, статистику и думаю - а зачем? Клиенты находят нас, звонят, все работает. Иногда лучшее решение - самое простое.

На главной странице "в лоб" о том кто мы, наши конкурентные преимущества, специализация и примеры работ


Сразу "ярко" заявляем о действующих скидках. Кроме этого, простым текстом пытаемся общаться с клиентом и убедить его в нашем сервисе, пока что, не общаясь с ним лично - конверсия в лиды увеличилась значительно, но важно, чтобы все предложения были реальны

А вот ворд стат. За последний месяц нас искали 680 раз не считая статистики переходов по прямой ссылке. Доказательство того, что дорогой сайт не нужен. Наш стоит 6 000 рублей в год, а сделан за 20 часов
Примеры лучших работ как маркетинговый инструмент


Оставляли подобные фото с примерами работ и вотермаркой в отзывах к жилым комплексам. Отличный маркетинговый инструмент - сразу определяем нужную ЦА и бесплатно заявляем о себе. Точно знаем, что минимум один клиент был из отзывов яндекс - поэтому работает
Как мы масштабировались и разбирались в проблемах ремонта
Теперь про то, как мы начали разбираться в проблемах ремонта и потихоньку расти. Знаете, за этот год мы много думали - почему вообще ремонтные компании задерживают сроки и не могут сделать работу по первоначальной цене? И нашли несколько интересных моментов.
Первое - сроки. Тут даже копать глубоко не пришлось - сам рынок сформирован так, что клиенты просто привыкли к задержкам. "А, ну это ремонт, тут всегда так" - классическая фраза. Благо тут нам помог опыт организации процессов из айти. Четкие спринты, ежедневные отчеты, календарный план. Работает как часы, если не филонить.
Второе - вечно растущая цена. Вот это было сложнее. В новостройках еще можно точно посчитать, а во вторичке... Но благодаря наработкам этот вопрос стал гораздо яснее. При правильно организации процессов, непредвиденные работы лучше оплатить из своих средств, чем терять клиента. Только так и делается сервис.
Третье - больная тема - воровство на материалах. Тут мы конкретно закрутили гайки. Завели строгий учет, до последнего мешка штукатурки. Прорабам сразу сказали - любая жалоба от клиента на нечестность - это конец сотрудничества. Знаете что самое смешное? Когда начали работать честно, оказалось что маржа все равно хорошая. Просто многие привыкли что надо обязательно накручивать еще и еще.
Неприятные особенности прозрачного сервиса
Большинство компаний, которые начинают работать честно, быстро сдуваются. Потому что сам потребитель привык к плохому сервису. Приходишь к клиенту, говоришь "мы все сделаем четко по смете и в срок", а он смотрит с недоверием - "да ладно, так не бывает". Сейчас в 2024-м ситуация получше, но рынок все еще очень консервативный.
Продвижение или как мы брали “Новую Москву”

Наш любимый Прокшино в Новой Москве - в 2024 году, это самый перспективный район в котором покупатели - наши потенциальные клиенты
Расти начали потихоньку. Сначала сделали специальные цены для новой Москвы - там как раз много новостроек, где мы хорошо научились работать. Потом пошли заказы по рекомендациям. Когда я говорю “пошли” заказы нужно понимать, что это 1-3 заказа в месяц стабильно, что на самом деле, тогда казалось не мало. С рекламой экспериментировали забавно - оставляли визитки в подъездах (да, просто старые добрые визитки!), ставили рекламные ящики у офисов продаж в дни выдачи ключей.
Был случай, когда на одном ЖК поставили такую стойку, а через неделю риелтор оттуда сам позвонил и предложил взять себе процент, если клиент пойдет к нам.
Сейчас берем 2-5 заказов в месяц, (летом было 5 в месяц, если разделить). Большинство клиентов приходят по рекомендациям. Штат за год работы постепенно собрали свой. Трудоустроено 14 сотрудников. Если их не хватало (как летом), привлекали мастеров с которым уже работали раньше, по договору ГПХ. Просили всех регистрировать самозанятость или ИП – это было тяжело, но зато честно платим налоги по Доходы – расходы.
Как устроен процесс
Знаете, что самое сложное в ремонтном бизнесе? Нет, не поиск клиентов и не работа с материалами. Самое сложное - это выстроить систему, которая будет удовлетворять запросы клиента и при этом позволит компании зарабатывать. Мы долго думали над этим и придумали несколько интересных решений.
Начнем с оплаты. Если посмотреть на московский рынок, там забавная система - вроде бы без предоплаты, но это только за первый, самый дешевый этап. А потом - бац, и клиент должен внести 50% от всей суммы. И попробуй не внеси - бригада уйдет на другой объект. Мы сделали иначе: разбили весь ремонт на этапы (их получилось 12 для капитального ремонта), и берем предоплату только за текущий этап. То есть клиент всегда понимает, за что именно платит, и может контролировать процесс.
С договорами тоже интересно получилось. Сначала делали один стандартный, а потом поняли - люди разные, запросы разные. Сейчас у нас три варианта: просто на работы (для тех, кто сам хочет закупать материалы), на работы плюс материалы (самый популярный), и полный пакет с дизайн-проектом. Кстати, про дизайн - мы не держим штатных дизайнеров, работаем с фрилансерами. Так получается и дешевле для клиента, и качество выше - каждый дизайнер специализируется на своем стиле.

Первый образец договора, который ставили на сайт
Расчёт стоимости
Расчет стоимости работ - отдельная история. Когда начинали, было очень сложно. На рынке нет четких цен - один мастер берет 3 тысячи за квадрат стяжки, другой - тысячу, третий вообще говорит "ну давайте посмотрим по факту". Сначала работали по среднему прайсу, но часто уходили в минус по отдельным этапам - то бригада дороже встанет, то материала больше уйдет. Сейчас, когда появились постоянные сотрудники, стало проще - мы точно знаем их расценки и можем давать фиксированную цену.
Материалы
Выяснилось, что в крупных магазинах часто дешевле в сравнении с рынками стройматериалов, особенно если ловить акции. Плюс появились маркетплейсы - там вообще красота по ценам. И главное - полная прозрачность, клиент сам видит все позиции. Если находим материал дешевле - возвращаем разницу. Был случай, когда на керамограните сэкономили клиенту почти 30 тысяч - просто потому что, нашли ту же плитку в другом магазине по акции.
Как работаем сейчас
Сейчас берем 2-5 заказов в месяц, зависит от сезона и сложности объектов.
Процесс обкатан до мелочей: сначала выезд на замер, потом предварительная смета. Если клиента все устраивает - детальный расчет и договор. Дальше начинается самое интересное - согласование материалов, закупки, работа.
Особенности продвижения и подводные камни
С продвижением интересно получилось. Сначала, как все, полезли на Авито. И знаете что? Не зашло. Там своя специфическая аудитория и конкретно у нас, с Авито “ не пошло”.

Свежий пример страницы с авито в категории "Ремонт квартир". Как клиенты определяются с подрядчиком среди тысяч однотипных объявлений - хороший маркетинговый вопрос, который мы решаем, после чего полноценно "зайдём" на авито
Пробовали контекстную рекламу яндекс - тоже так себе результат. Клики дорогие, конверсия низкая. Зато отлично зашла таргетированная реклама в Instagram* (*запрещен в РФ) и реклама в районных пабликах ВКонтакте. Особенно в группах новостроек в ТГ - там как раз наша целевая аудитория.
Но главный канал - сарафанное радио. Причем работает оно интересно. Всегда знаешь , от кого пришли заказчики и проще выстраивать коммуникацию. Есть клиент - он доволен, рассказал коллегам - и понеслось. За три месяца получили еще два заказа от сотрудников той же компании. Выходит такой “корпоративный ремонт”)))
Были, конечно, и провалы в продвижении. Пытались работать с риелторами - предлагали им комиссию за клиентов. Не пошло - у них свои схемы, свои бригады. Пробовали давать рекламу в лифтах, входных группах - тоже мимо, ни одного обращения, но тут скорее из-за того что эта реклама буквально на день.
ИТОГ
Сейчас мы существуем уже чуть больше года и в целом смотрим на ремонтный рынок не так, как раньше. За это время мы сделали несколько важных заметок для себя:
Оказывается, большинство проблем в ремонте - это не технические сложности, а банальная организация процессов. Когда все четко спланировано и каждый знает что делать - даже самый сложный ремонт идет как по маслу.
Мы поняли, почему многие компании "химичат" с ценами и сроками - просто потому что не умеют нормально считать и планировать. Когда все процессы выстроены правильно, можно работать честно и все равно оставаться в плюсе.
Самое сложное - это не найти клиентов или научиться делать ремонт. Самое сложное - это переломить привычку рынка работать "по-серому". И заказчики, и исполнители настолько привыкли к непрозрачным схемам, что честный подход вызывает удивление.
Мы до сих пор учимся. Каждый объект - это новый опыт и новые вызовы (особенно по части коммуникаций с клиентами). Но главное - мы видим, что наша модель работает и пока что, нам удается держать ценник немного ниже рыночного, за счёт того что до сих пор не имеем в найме маркетологов, IT, отдела продаж и менеджеров по продажам. Стараемся нанимать именно рабочих, все остальное можно отдать на аутсорс.
Уважаемые пикабушники, были рады составить для вас эту статью! С любовью, СК Комната
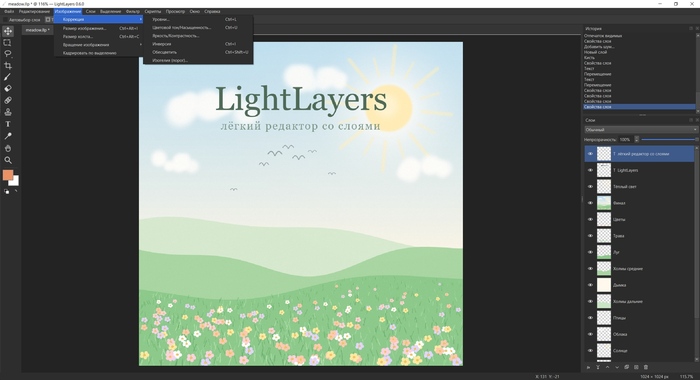
Оригинальный фотошоп слишком тяжелый, а так же слишком дорогой, поэтому я решил сделать свой личный редактор картинок с теми функциями, которыми часто пользуюсь.
Сейчас уже умеет в принципе все то, что мне нужно. Из фишек - поддерживает скрипты, то есть можно попросить нейронку что-то нарисовать или обработать и запустить в виде python скрипта или работать по API.
Делал полностью с нуля, просто описывая нейросети функционал того или иного инструмента.
Я конечно понимаю, что сейчас флексом в виде опенсорс аналога фотошопа или другой платной программы никого не удивишь, но вдруг кому-то прям вот надо. Если что, пишите, какой еще функционал хотелось бы увидеть, возможно добавлю в следующей версии. Ну а если никому окажется не нужно, то и ладно, просто решил поделиться.
Выглядит вот так(картинку сгенерировала нейросеть скриптом):
Чтобы работало, нужно сначала запустить install.bat, который установит питон и зависимости в локальную папку, затем запуск через LightLayers.bat. Удалить - просто удалить папку вместе со всеми зависимостями.
Надеюсь я никаким образом не нарушил правила Пикабу.
Скачать тут:
У нас несколько юридических лиц, магазины на Ozon, Wildberries и Яндекс Маркете, и возникла потребность в аналитике по динамике продаж по разным артикулам. Долго и упорно пытался собрать дашборд в Яндекс даталенс, но переодически, что то глючило, а с последними событиями количество глюков увеличилось. Был небольшой опыт кодинга ручками, потом пару раз делал бота для телеги с помощью Дипсика, с переменным успехом. Решил попробовать собрать дашборд на питоне, с помощью дипсик.
Ниже кратко процесс, потратил 2 дня между делом дополняя код и исправляя дипсиком, можно было конечно клодом воспользоваться, но такого опыта нет и я ж не тру программист, задача была быстро собрать, работающий дашборд
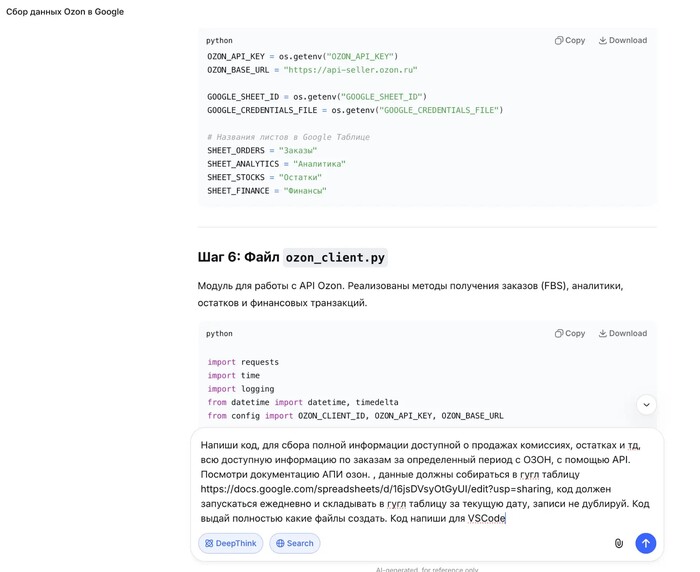
Запрос в дипсик, самый простой и банальный своими словами ))
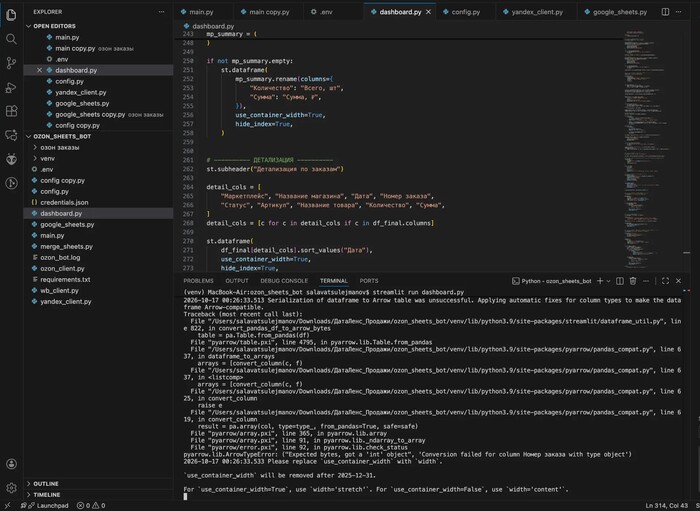
Сам код и структура файлов
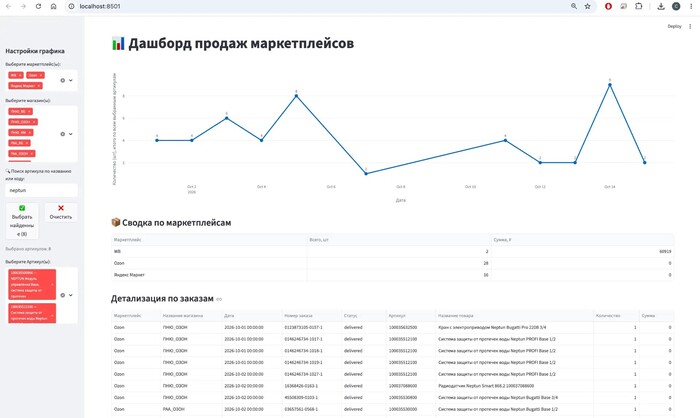
Сам дашборд
На выходе получился аналитический дашборд на Streamlit, сейчас айтишники место выделят, залью на сервак, и отдам менеджерам по маркет плейсам, чтобы динамику смотрели.
Функционал дашборда:
Сбор данных: По API забирает заказы с Ozon, WB и Яндекс Маркета, сохраняя их в Google Sheets.
Фильтрация: В панели настроек можно выбрать маркетплейс, конкретное юрлицо или магазин (например, ПНИО_ОЗОН, РАА_ОЗОН).
Поиск: Поиск по названию артикула (например, «neptun») с возможностью выбора нужных позиций галочками.
Визуализация: График «Динамика продаж» отображает количество проданных единиц по датам.
Сводка: Таблица с общими показателями по маркетплейсам (количество штук и сумма в рублях).
Детализация: Полная таблица заказов с указанием маркетплейса, магазина, даты, номера заказа, статуса, артикула, названия товара, количества и суммы.
ПС: ни одна строчка кода не написана руками человека ))
жду полную панамку от тру программеров) обещаю воспринять критику и услышать, в следующий раз буду юзать клод и sql и много других страшных слов )
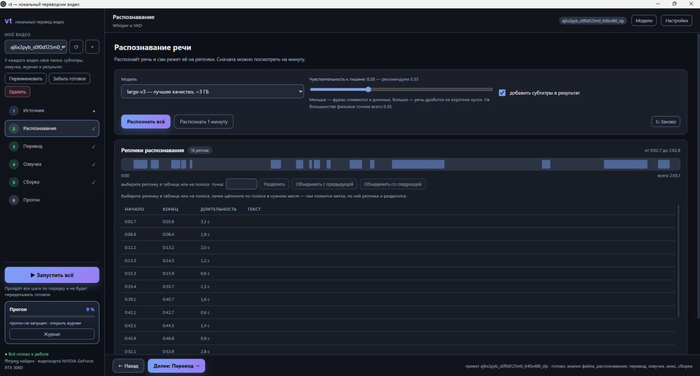
таймлайн распознанных текстов
Мне пришлось учился пользоваться своим же переводчиком
Короче из ключевых проблем что скорее всего не решиться, whisper large-3 бедолага, не смотря на всё качество определение реплики, разметить их по нему крайне непростая задача.
Я добавил таймлайн, но редактор для него полноценный ещё не сделал. На сколько это будет надо, покажет желание пользователей уже. Я пока думаю что это не самое приоритетное направление.
Локальный перевод вообще практически не имеет смысла, ресурсов жрёт тонну, а выход хуже чем в googletranslate просто. Это не смотря на то, что разработан алгоритм для перевода с "контекстом", а не просто в тупую. Вот это более важное направление и я думаю его добивать.
По этой же причине пришлось добавлять озвучку без генерации субтитров. Чисто взял готовые и бросил озвучивать.
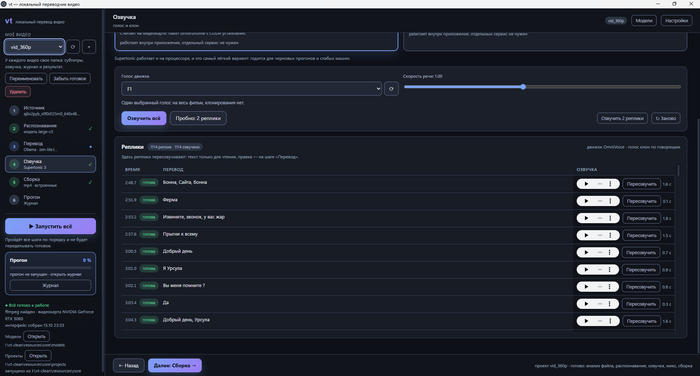
Окно озвучки
И вот озвучка и обратная сборка, работают на 10 из 10. Модель не клонирующая голос взлетела на 3060 12 гиговой и даже не вспотела. Модель с клонером это отдельная песня, она хорошо всё делает, но в фильме должно быть достаточно качественных реплик для клонирования голоса, иначе алгоритм будет озвучивать либо тем что сможет склонировать, либо озвучит стандартным своим голосом.
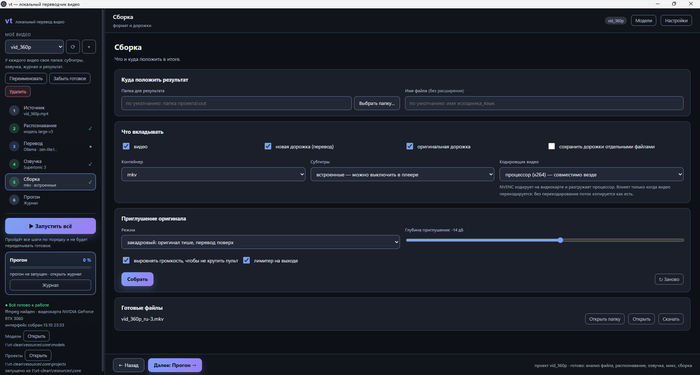
Окно сборки
Хорошо отработал алгоритм глушения реплик, так называемый "дакинг".
Короче для озвучки кино по готовым субтитрам вообще 0 проблем. А короткие ролики вполне себе можно и с авторазметкой даже делать.
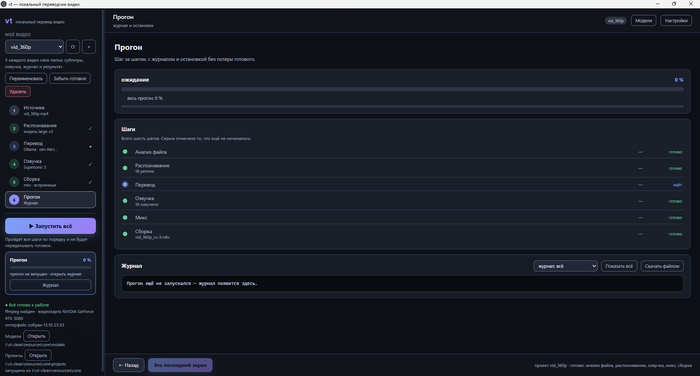
По ощущениям достигнуты цели где-то на половину. Думы думаю, стоит ли уже релизить или ещё пошлифовать бедолагу в области перевода. Потому что это по сути самое узкое место сейчас.
Оценить озвучку можете вот тут
Сразу отвечу на вопрос зачем я это делал. Мне надо было быстро перевести видео локально, без претензии на озвучку по ролям, все что я нашел это pyvideotrans. И он мне совершенно не понравился. Вот и всё. Релиз на вот вотах, даже если не получится улучшить перевод, БЕСПЛАТНОВО, не претендую на золотые горы в этом проекте. Надо было мне, но вдруг кому ещё подойдет, у кого непритязательные взгляды в отношении озвучки :D
Форматирование целой папки документов Word кажется простой задачей: изменить несколько стилей, сохранить каждый файл — и готово. На практике документы разных авторов часто сочетают стили абзацев, вручную заданное форматирование и отдельные определения нумерации списков. Изменения одного лишь стиля может оказаться недостаточно: часть текста сохранит прежний вид.
В этом руководстве показано, как с помощью python-docx задать единые шрифт, размер и цвет для выбранных стилей абзацев в нескольких файлах .docx. Сначала мы рассмотрим четыре подводных камня, влияющих на результат, а затем объединим решения в одном скрипте пакетной обработки.
В примере используются следующие правила:
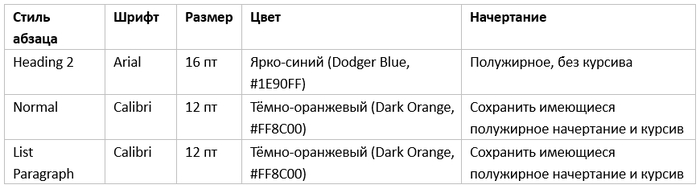
Контрастные цвета позволяют легко заметить изменения. Перед использованием скрипта в рабочем процессе замените их цветами, принятыми в ваших документах.
Естественный первый шаг — изменить стиль абзаца:
h2 = doc.styles['Heading 2']
h2.font.name = 'Arial'
h2.font.size = Pt(16)
h2.font.color.rgb = RGBColor.from_string('1E90FF')
Этот код изменяет определение стиля. Текст, наследующий эти свойства от данного стиля, сможет использовать новые настройки. Однако фрагмент текста (run), для которого явно задан шрифт или размер, может сохранить собственные настройки.
Например, абзац может иметь стиль Heading 2, а его текст — вручную заданный шрифт Times New Roman размером 11 пт. Изменение Heading 2 не удаляет автоматически такие переопределения на уровне фрагментов текста. На внешний вид также могут влиять символьные стили и другие наследуемые свойства.
Если после выделения текста в Word и нажатия на его стиль абзаца появляется новое форматирование, это полезный признак того, что существующее форматирование стоит изучить внимательнее. Однако это не доказывает, что документу требуется отдельное «обновление стиля» или что повторное назначение того же стиля в Python воспроизведёт поведение Word.
В данном рабочем процессе скрипт изменяет и определение стиля, и сам текст в соответствующих абзацах. Он явно задаёт шрифт, размер и цвет для каждого фрагмента текста, чтобы эти свойства не зависели исключительно от наследования.
Вспомогательная функция настройки шрифта также задаёт XML-атрибуты шрифтов для ASCII, других символов, охватываемых hAnsi, восточноазиатского текста и сложных систем письма, а также удаляет соответствующие ссылки на шрифты темы на том же уровне. Так нужная гарнитура задаётся явно; это не означает, что стили заголовков в принципе игнорируют font.name.
Указание имени шрифта не устанавливает его и не гарантирует наличия всех необходимых символов. При необходимости Word по-прежнему может подставить другой шрифт.
Распространённый обходной путь — сбросить свойства шрифта у всех фрагментов текста в документе. Это может удалить значимые выделения и изменить текст за пределами нужной области обработки.
Вместо этого скрипт обрабатывает только абзацы, которым действительно назначен стиль Heading 2, Normal или List Paragraph. Он задаёт свойства, предусмотренные стандартом оформления, и не затрагивает остальные.
Для Heading 2 полужирное начертание явно включается, а курсив отключается. Для Normal и List Paragraph сохраняются существующие настройки полужирного начертания и курсива. Скрипт также сохраняет текст, гиперссылки, интервалы абзацев и другие свойства, которые он явно не изменяет. Текст гиперссылки внутри подходящего абзаца получает заданные шрифт, размер и цвет, при этом сама ссылка сохраняется.
Это различие важно и для заголовков, оформленных вручную. Абзац, который выглядит как заголовок, но использует Normal, обрабатывается как Normal. Скрипт не определяет структуру документа по размеру шрифта или полужирному начертанию. Таким заголовкам нужно заранее назначить правильный стиль либо обработать их на отдельном этапе классификации.
В python-docx к встроенным стилям следует обращаться по английским именам, даже если интерфейс Word отображает их локализованные названия. Для пользовательских стилей используются их фактические имена, сохранённые в документе. Если в ваших документах применяются пользовательские стили основного текста или заголовков, добавьте их в правила, не предполагая, что они соответствуют встроенным стилям.
Перебор doc.paragraphs не охватывает абзацы внутри ячеек таблиц. Поэтому скрипт может изменить основной текст документа, оставив текст таблиц с исходным форматированием на уровне фрагментов.
Решение — обходить и абзацы, и таблицы. Для каждой таблицы нужно посетить её ячейки и рекурсивно обработать вложенные таблицы. Скрипт отслеживает уже посещённые элементы ячеек, поскольку объединённые ячейки могут встречаться несколько раз при обращении к таблице через строки и ячейки.
Каждый подходящий абзац внутри ячейки получает такое же форматирование фрагментов текста, как и подходящий абзац в основном тексте. Например, абзац Normal с явно заданным размером шрифта 8 пт будет изменён на 12 пт.
Обход охватывает основную часть документа и её таблицы. Он не обрабатывает верхние и нижние колонтитулы, текстовые поля, обычные и концевые сноски. Абзацы и фрагменты текста внутри отслеживаемых исправлений также не входят в поддерживаемую область этого рабочего процесса.
Нумерованный список содержит два отдельных объекта форматирования: текст абзаца и автоматически создаваемый номер, например 1., 2. или 3..
Изменение List Paragraph или его фрагментов текста не обязательно меняет номер. Определения нумерации могут задавать собственные свойства шрифта для каждого уровня списка.
Скрипт определяет идентификатор нумерации абзаца (numId) и его уровень (ilvl), включая значения, унаследованные по цепочке стилей абзаца. Затем он изменяет свойства фрагмента текста уровня нумерации через переопределение уровня конкретного списка в numbering.xml.
Если переопределение уровня отсутствует, скрипт копирует соответствующий абстрактный уровень в конкретный список, прежде чем изменить свойства шрифта. Это сохраняет формат номера, его шаблон, отступы и другие существующие настройки уровня. Имеющиеся переопределения начального значения нумерации также сохраняются.
В обычных нумерованных списках номер получает те же шрифт, размер и цвет, что и текст абзаца. Для символьных маркеров сохраняется исходная гарнитура: замена шрифта Symbol или Wingdings может изменить символ либо привести к появлению квадрата вместо отсутствующего символа. Размер и цвет маркера при этом обновляются.
Следует учитывать два ограничения:
Один уровень конкретной нумерации используется всеми абзацами с одинаковыми numId и ilvl. Поэтому изменение его форматирования может повлиять на другие абзацы, использующие этот уровень, в том числе на абзацы со стилями, не выбранными для обработки.
Скрипт отклоняет маркеры в виде изображений, косвенные ссылки на стили нумерации и конфликтующие правила форматирования для одного общего уровня. Вместо сохранения частично отформатированного результата он сообщает об ошибке обработки файла.
Эти ограничения позволяют сохранить пример достаточно простым. Документам с более сложной структурой нумерации потребуется дополнительная обработка.
Установите библиотеку:
pip install "python-docx>=1.2.0"
Сохраните следующий код в файле word_batch_formatting.py. Скрипт читает документы из E:\Documents\input и сохраняет их в E:\Documents\output, создавая папку вывода при необходимости. Каждый выходной файл сохраняет исходное имя. Словарь RULES содержит шрифт, размер и цвет для каждого целевого стиля.
from pathlib import Path
from copy import deepcopy
from docx import Document
from docx.oxml import OxmlElement
from docx.oxml.ns import qn
from docx.shared import Pt, RGBColor
from docx.text.run import Run
INPUT_FOLDER = Path(r'E:\Documents\input')
OUTPUT_FOLDER = Path(r'E:\Documents\output')
RULES = {
'Heading 2': ('Arial', 16, '1E90FF'),
'Normal': ('Calibri', 12, 'FF8C00'),
'List Paragraph': ('Calibri', 12, 'FF8C00'),
}
def set_font(obj, rule, heading=False, bullet=False):
name, size, color = rule
obj.font.size = Pt(size)
obj.font.color.rgb = RGBColor.from_string(color)
if heading:
obj.font.bold, obj.font.italic = True, False
if not bullet:
obj.font.name = name
fonts = obj._element.get_or_add_rPr().get_or_add_rFonts()
for slot in ('ascii', 'hAnsi', 'eastAsia', 'cs'):
fonts.set(qn('w:' + slot), name)
fonts.attrib.pop(qn('w:' + slot + 'Theme'), None)
clr = obj._element.get_or_add_rPr().find(qn('w:color'))
for key in ('themeColor', 'themeTint', 'themeShade'):
clr.attrib.pop(qn('w:' + key), None)
def paragraphs(container, seen=None):
seen = set() if seen is None else seen
for p in container.paragraphs:
yield p
for table in container.tables:
for row in table.rows:
for cell in row.cells:
if cell._tc not in seen:
seen.add(cell._tc)
yield from paragraphs(cell, seen)
def numbering(p):
num_id = level = None
sources, style, seen = [p._p.pPr], p.style, set()
while style is not None and style.style_id not in seen:
seen.add(style.style_id)
sources.append(style.element.pPr)
style = style.base_style
for prop in sources:
if prop is None or prop.numPr is None:
continue
np = prop.numPr
if num_id is None and np.numId is not None:
num_id = np.numId.val
if level is None and np.ilvl is not None:
level = np.ilvl.val
return num_id, level, seen
def format_number(root, p, rule, changed):
num_id, level, styles = numbering(p)
if num_id in (None, 0):
return
num = root.find(f"w:num[@w:numId='{num_id}']", root.nsmap)
abstract_id = num.find(qn('w:abstractNumId')).get(qn('w:val'))
abstract = root.find(f"w:abstractNum[@w:abstractNumId='{abstract_id}']", root.nsmap)
if abstract.find(qn('w:numStyleLink')) is not None:
raise ValueError('Косвенные стили нумерации не поддерживаются')
if level is None:
matches = [x for x in abstract.findall(qn('w:lvl'))
if x.find(qn('w:pStyle')) is not None
and x.find(qn('w:pStyle')).get(qn('w:val')) in styles]
level = int(matches[0].get(qn('w:ilvl'))) if matches else 0
key = (num_id, level)
if key in changed:
if changed[key] != rule:
raise ValueError('Для одного уровня нумерации заданы конфликтующие правила форматирования')
return
override = num.find(f"w:lvlOverride[@w:ilvl='{level}']", root.nsmap)
if override is None:
override = OxmlElement('w:lvlOverride')
override.set(qn('w:ilvl'), str(level))
num.append(override)
lvl = override.find(qn('w:lvl'))
if lvl is None:
lvl = deepcopy(abstract.find(f"w:lvl[@w:ilvl='{level}']", root.nsmap))
override.append(lvl)
fmt = lvl.find(qn('w:numFmt')).get(qn('w:val'))
if lvl.find(qn('w:lvlPicBulletId')) is not None:
raise ValueError('Маркеры в виде изображений не поддерживаются')
old = lvl.find(qn('w:rPr'))
run = Run(OxmlElement('w:r'), None)
if old is not None:
run._r.append(deepcopy(old))
set_font(run, rule, p.style.name == 'Heading 2', bullet=fmt == 'bullet')
if old is not None:
lvl.remove(old)
lvl.append(run._r.rPr)
changed[key] = rule
def format_document(src, dest):
doc = Document(src)
for name, rule in RULES.items():
if name in doc.styles:
set_font(doc.styles[name], rule, name == 'Heading 2')
changed = {}
for p in paragraphs(doc):
if p.style.name not in RULES:
continue
rule = RULES[p.style.name]
for item in p.iter_inner_content():
for run in ([item] if isinstance(item, Run) else item.runs):
set_font(run, rule, p.style.name == 'Heading 2')
format_number(doc.part.numbering_part.element, p, rule, changed)
doc.save(dest)
if __name__ == '__main__':
if not INPUT_FOLDER.is_dir():
raise SystemExit(f'Папка входных файлов не существует: {INPUT_FOLDER}')
OUTPUT_FOLDER.mkdir(parents=True, exist_ok=True)
for src in sorted(INPUT_FOLDER.glob('*.docx')):
if src.name.startswith('~$'):
continue
dest = OUTPUT_FOLDER / src.name
if dest.exists():
print(f'Пропущено: {dest.name}')
continue
try:
format_document(src, dest)
print(f'Сохранено: {dest.name}')
except Exception as error:
print(f'Ошибка: {src.name}: {error}')
Запустите скрипт командой:
python word_batch_formatting.py
Например, из E:\Documents\input\report.docx будет создан E:\Documents\output\report.docx. Исходный файл останется доступным для сравнения. Поскольку скрипт просматривает только папку входных файлов, созданные документы не обрабатываются повторно. Пути к этим двум папкам должны различаться.
Временные файлы блокировки Word и уже существующие выходные файлы пропускаются. Чтобы повторно создать документ после изменения правил, удалите его предыдущую копию из папки вывода. Ошибки сообщаются отдельно для каждого файла, после чего скрипт продолжает обработку остальных файлов.
Если папка входных файлов отсутствует, скрипт сообщает об этом до начала обработки. Если в ней нет подходящих файлов, выходные файлы не создаются. Целевые стили, отсутствующие в документе, также пропускаются, а не создаются заново. Перед запуском пакетной обработки проверьте папку и имена стилей.
Результат форматирования:
На сравнении ниже показан документ до и после форматирования. Текст Heading 2 использует Arial размером 16 пт и синий цвет, а основной текст, содержимое таблиц и текст нумерованных списков — Calibri размером 12 пт и оранжевый цвет. Номера списка оформлены так же, как его текст.

Начните с нескольких документов, отражающих разнообразие файлов в вашей папке. Проверьте абзац Heading 2 с вручную переопределённым шрифтом, абзац основного текста с полужирным или курсивным выделением, ячейку таблицы и нумерованный список.
Ожидаемый результат — единые шрифт, размер и цвет для трёх целевых стилей и их текста; Heading 2 при этом становится полужирным, без курсива. Фрагменты текста в абзацах других стилей напрямую не изменяются, хотя стили, основанные на изменённом целевом стиле, могут унаследовать его изменения. Числовые маркеры списков используют заданный шрифт, а символьные маркеры сохраняют исходную гарнитуру.
Этот подход намеренно записывает свойства шрифта непосредственно в подходящие фрагменты текста. Так текущее форматирование задаётся явно, но последующие изменения стилей могут не проявиться из-за новых настроек на уровне фрагментов. Если дальнейшее оформление должно полностью управляться стилями, используйте отдельную стратегию очистки, которая удаляет только соответствующие переопределения и проверяет оставшееся наследование.
Скрипт использует низкоуровневый доступ к XML для работы со шрифтами и нумерацией, поэтому сохраняйте исходные файлы и проверяйте результат после обновления библиотеки. Он предлагает практический рабочий процесс для поддерживаемых структур документов, а не полноценный механизм форматирования для всех возможностей Word.
Привет, товарищи программисты.
Сразу скажу: я не программист. Учусь вайбкодить, так что сильно не пинайте.
Есть сайт, где часто нужно по работе искать документы по реквизитам и скачивать. Хочу сделать пару ИИ-агентов, чтобы они сами там искали нужное по промпту и скачивали на комп.
Проблема: файлы скачиваются только после входа по ЭЦП через NCALayer. Это программка на Java, которая висит в трее и общается с браузером. Если что-то называю неправильно, не бейте.
Gemini и Claude сказали, что это сложно, а может, и невозможно. Решил спросить у живых людей.
Можно ли как-то автоматизировать вход, или это невозможно?
Если у кого-то есть реальное работающее решение, готов обсудить стоимость услуг разработки.