Диалог с моделью на 30+ сообщений с последовательным уточнением, переформулированием, проверкой на противоречия. Пользователь не принимал ответы на веру, вскрывал логические стыки, проверял устойчивость модели к многократным переспросам. Обсуждались: галлюцинации, сенсорный опыт, ошибки обучения, патологии речи, юмор, предвзятости. Запросы — от терминологии до инженерных промтов с требованиями к коду.
На относительно простом примере показываю как можно сделать программу «снова великой».
*разумеется это нейросетевая Дженна а не реальная, которая про рефакторинг ничего не знает.
Исходный код отрефакторенной версии выложен на Github.
Задача
Допустим есть некий софт, созданный еще «при царе Горохе» неким гордым но умным одиночкой, которого с тех пор никто не видел. Софт живой и с пользователями, которые приносят прибыль, поэтому его надо как‑то развивать и поддерживать.
В попытке расширить команду разработки, вы начинаете нанимать новых разработчиков, но раз за разом происходит одна и та же ситуация:
проработав месяц-два, нанятые программисты в ужасе убегают в закат.
Кто‑то при увольнении намекает на причины такого поступка, в диапазоне от «ваш проект попахивает» до надо «срочно все переписать». После примерно десятого убежавшего программиста, вы наконец начинаете задумываться, что возможно с проектом действительно что‑то не так и стоит провести этот самый «рефакторинг».
Так это обычно начинается.
Образец
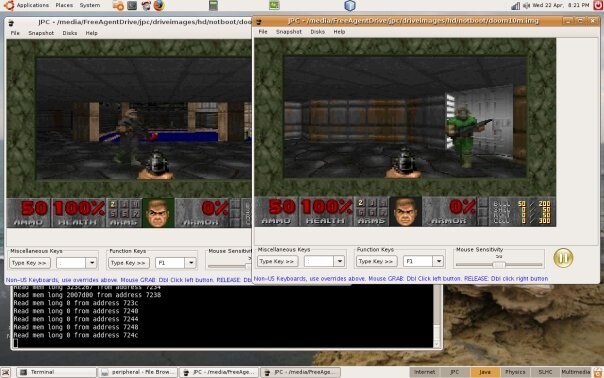
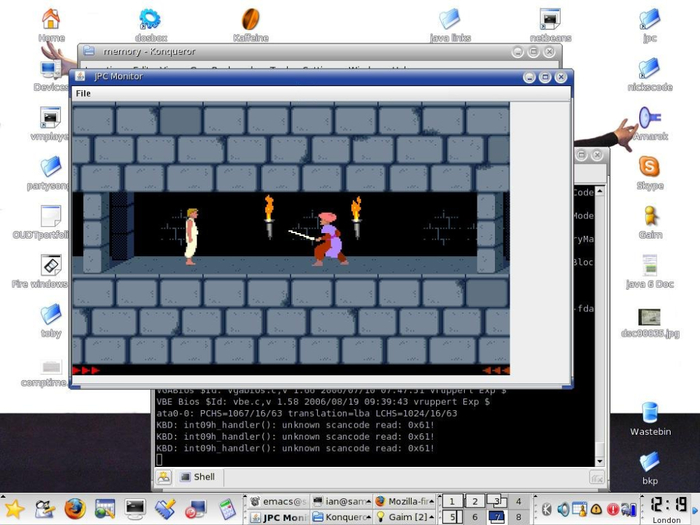
В качестве образца для этой статьи был взят один интересный но малоизвестный широкой публике проект JPC:
The fast x86 PC emulator in 100% pure Java
Самый настоящий эмулятор старого x86-компьютера, реализованный без всяких нативных частей — на чистой Java!
Не очень большой (~6500 файлов с исходным кодом), но имеет стадию «внутренней генерации» — часть исходного кода создана не вручную а путем запуска кодогенератора по метаданным, что довольно часто встречается у больших проектов с историей, причем на любом языке.
Еще к сожалению JPC немного заброшен, что для статьи только в плюс поскольку добавляет реалистичности — именно в таком состоянии чаще всего пребывают проекты, которые просят «привести в чувство».
Текущее состояние
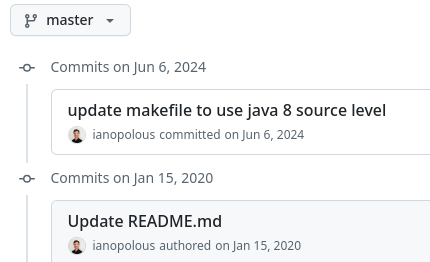
После переезда проекта на Github, список коммитов выглядит следующим образом:
Мягко говоря негусто.
Никаких тестов в проекте нет, по всей видимости тестировалось все вручную с помощью молитвы, еще судя по исходному коду — далеко не весь функционал является рабочим, что также характерно для проектов в «пред‑рефакторинговом» состоянии.
Думаю теперь очевидно почему для этой статьи был выбран именно JPC — несмотря на редкость решаемой задачи, для рефакторинга это самый типичный клиент.
Собирается сей чудо-проект с помощью.. Makefile, что для мира Java является дичью и извращением редкостью:
make application
Примерно как собирать проект на QT с помощью Gradle или (еще лучше) — sbt.
Предложите как-нибудь коллегам и посмотрите на реакцию, некоторые точно перестанут с вами здороваться за руку.
Для сборки необходимо указать путь к JDK в переменной PATH, при этом сборка проходит успешно даже с последними версиями (автор использовал OpenJDK 21).
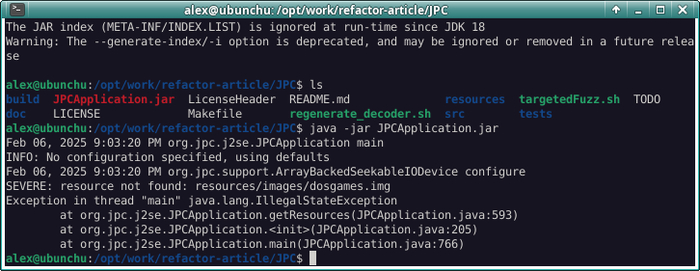
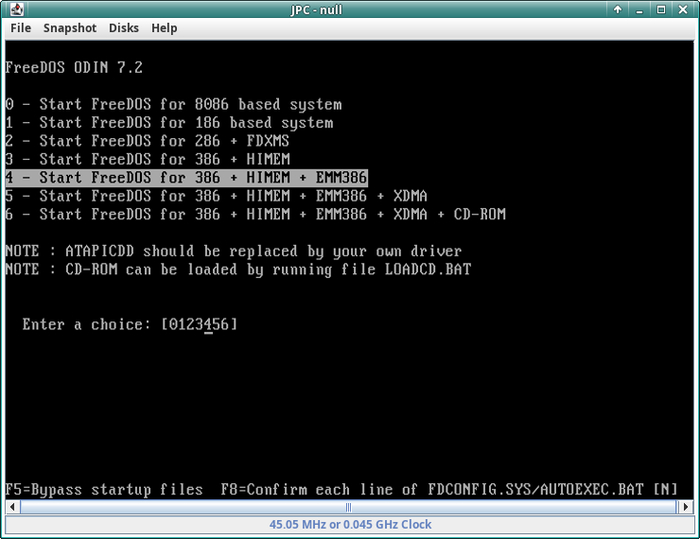
Готовое приложение JPCApplication.jar появится в корне проекта после завершения сборки, но на этом хорошие новости заканчиваются:
Собранное приложение отказывается запускаться, что мы исправим чуть ниже.
Стадия первая: новый скелет
Первым делом, как и в реальном боевом проекте, необходимо избавиться от любого «самопала», задействованного при сборке. Причина, почему этот шаг критически важен на самом деле не так очевидна:
статические анализаторы — главный иструмент рефакторинга, крепко привязаны к структуре проекта и стандартным средствам сборки
Разумеется существуют варианты и с произвольной структурой проекта, но эффективность рефакторинга будет заметно ниже. Поэтому автор сделал стандартный (для своей практики) «финт ушами»:
перевел сборку проекта на Apache Maven, максимально широко поддерживаемый средствами анализа кода, CI-системами и средами разработки.
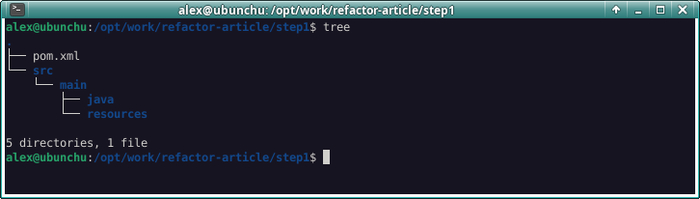
Реализовать такую миграцию в данном случае оказалось очень просто, поскольку JPC совсем не использует внешние библиотеки. Все что я сделал — раскидал ресурсы и исходный код в стандартную для Maven структуру каталогов:
Исходный код был перенесен из каталога src в src/main/java, ресурсы — в src/main/resources. Также был добавлен очень простой pom.xml, описывающий минимальные шаги сборки проекта:
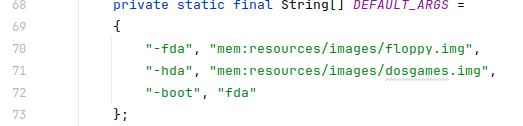
Это было убрано, поскольку точно такой же параметр запуска зашит еще и в код:
Наследие «былых времен», которое также достаточно часто встречается в устаревших проектах — во времена Java 1.5 и апплетов было модным использовать собственные атрибуты в манифесте.
Стадия вторая: удаление ненужного
Как в практически любом долгоживущем проекте, в JPC есть свои «внутренние утилиты» — отдельные программы, написанные для задач внутренней автоматизации.
Это та самая «грязная рабочая поверхность», которую не видит конечный пользователь.
При проведении рефакторинга, трогать внутренние утилиты стоит в последнюю очередь и в самом крайнем случае, поскольку правильность их работы проверять тяжело (ни тестов ни документации для внутренних утилит обычно нет в природе), зато они сильно влияют на общую работоспособность проекта.
В JPC внутренние утилиты реализованы в виде отдельных классов в пакете «tools» и нескольких шелл-скриптов в корне проекта.
И то и другое я просто не стал переносить в новую версию, также я убрал часть исходного кода эмулятора, отвечающего за отладку (пакет org.jpc.debugger) — по той же самой причине.
был убран импорт класса org.jpc.debugger.LinearMemoryViewer а используемая статичная функция translateLinearAddressToInt перенесена в класс PC.
Все эти действия позволили сократить кодовую базу проекта практически вдвое, что сильно упростило следующий шаг рефакторинга.
Стадия третья: критические проблемы
Наконец мы подошли непосредственно к самому рефакторингу, который я буду проводить с помощью среды разработки Intellij Idea.
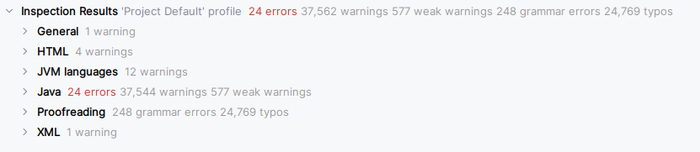
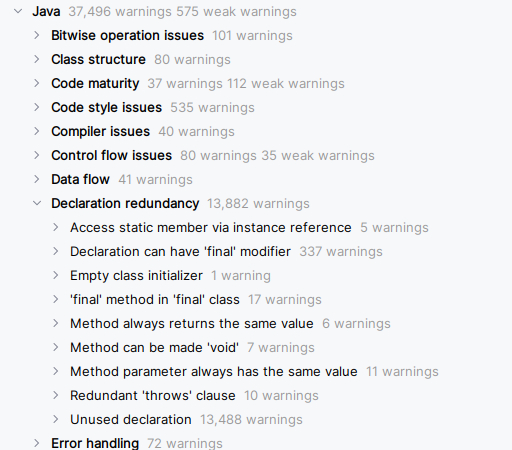
Первый запуск анализатора дает следующий результат:
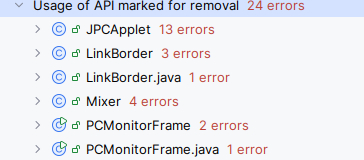
24 критических ошибки и ~ 37 тысяч предупреждений — не так уж плохо, по сравнению с тем что бывает на свете.
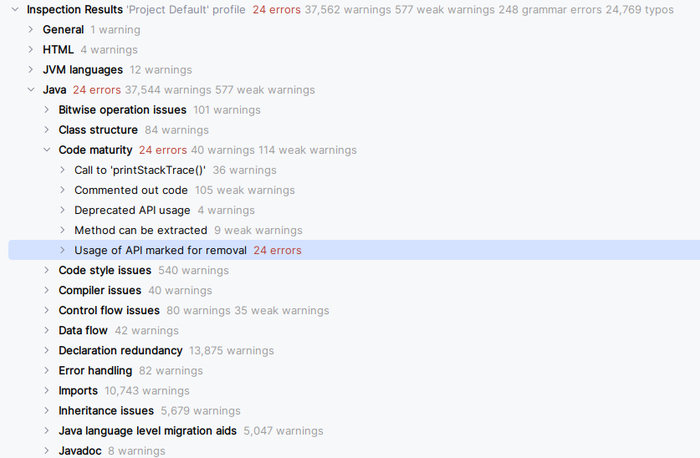
Смотрим глубже и видим, что все 24 ошибки — действительно самые критичные, поскольку из-за них проект может перестать собираться в самом ближайшем будущем:
Так что эти места стоит рефакторить в первую очередь, пока проект хотя-бы собирается из исходников.
Есть и хорошая новость:
Как видно из скриншота выше, большая часть критичных ошибок гнездится в классе JPCApplet, который используется для запуска приложения в режиме Java-апплета — ныне устаревшей технологии, когда-то работавшей с помощью плагина для браузера.
Поскольку плагин более официально не поддерживается — вся технология приказала долго жить и у обычных пользователей не встречается, так что класс можно удалить.
Но все несколько сложнее, поскольку еще есть вложенные классы, один из которых используется снаружи (org.jpc.j2se.JPCApplication):
JPCApplet.PlayPausePanel pp = new JPCApplet.PlayPausePanel(this);
Я просто перенес этот класс по месту использования, что позволило наконец удалить JPCApplet из проекта целиком.
Получилось минус 13 критических ошибок.
Еще один источник проблем — класс LinkBorder также можно удалить, поскольку он использовался лишь из удаленного JPCApplet.
Что дало еще минус три критических ошибки.
Дальше смотрим класс org.jpc.emulator.peripheral.Mixer, который забит предупреждениями от анализатора буквально через каждую строчку, однако вносить массовые правки пока не стоит — «всемогущая» Idea временами ошибается и это именно такой случай.
Анализатор ругается (в первую очередь) на конструктор new Float(), поскольку его прямое использование объявлено устаревшим, а в новых версиях Java стоит использовать Float.valueOf() в качестве замены.
Но как только вы замените конструктор, анализатор подскажет еще несколько оптимизаций, так что конечный вариант будет достаточно сильно отличаться:
Ругается анализатор на уникальный метод stop(), который был отмечен как устаревший еще до того как я начал писать на Java:
'stop()' is deprecated since version 1.2 and marked for removal
Примерно до версии 1.8 использование данного метода еще можно было как‑то оправдать наличием устаревших библиотек, в нынешних реалиях этот метод — просто еще один способ «выстрелить себе в ногу»:
Stopping a thread causes it to unlock all the monitors that it has locked.
Так что в коде использование этого метода точно стоит заменить на стандартный .interrupt() :
if (runner.isAlive()) { runner.interrupt(); }
Блок try-catch также можно спокойно убрать, поскольку SecurityException не выбрасывается в новых версиях Java при попытке остановки нити.
На этом все критические проблемы в проекте решены и получен минимальный практический смысл от всей затеи:
убраны места, которые могут сломать сборку проекта в новых версиях Java
Стадия четвертая: ошибки выполнения
Пришло время наконец попробовать запустить нашего «франкенштейна».
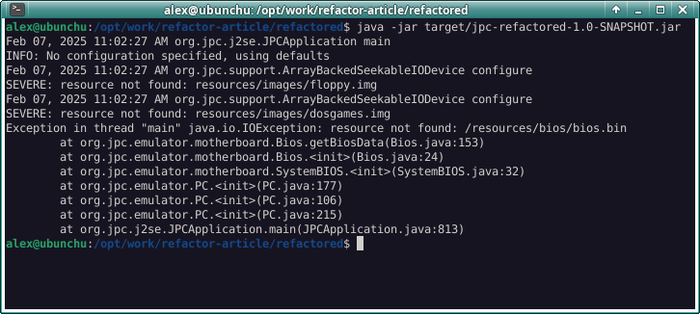
Сборка разумеется завершится успешно (не зря же старались), но при запуске будет выбрасываться все та же ошибка поиска ресурсов:
В оригинальной версии JPC, часть ресурсов (например образы биоса) загружались только из jar‑файла, часть (образы дисков) — только снаружи, из каталога resources, при этом каталог с ресурсами был общим.
Сию дичь необходимо пресечь и сделать в более адекватном стиле, например как это реализовано в движке знаменитого Quake:
сначала ищем внешний файл, если не найден — ищем в ресурсах, если не найден в ресурсах — падаем с ошибкой
За чтение образа BIOS отвечает вот такой метод в классе org.jpc.emulator.motherboard.Bios:
private staticfinalbyte[] getBiosData(String image) throws IOException { InputStream in = Bios.class.getResourceAsStream(image); if (in == null) { thrownew IOException("resource not found: " + image); } try { ByteArrayOutputStream bout = new ByteArrayOutputStream();
while (true) { int ch = in.read(); if (ch < 0) { break; } bout.write((byte) ch); }
В принципе за такую реализацию уже можно начинать бить, спасает лишь факт, что столь идиотсткое побайтовое чтение работает исключительно с ресурсами, которые уже находятся в памяти.
File f = new File(image); if (f.exists() && f.isFile() && f.canRead()) return Files.readAllBytes(f.toPath());
f = new File("resources",image); if (f.exists() && f.isFile() && f.canRead()) return Files.readAllBytes(f.toPath());
final URL u = Bios.class.getResource(image); if (u == null) thrownew IOException("resource (bios) not found: %s".formatted(image));
try (InputStream in = u.openStream()) { return in.readAllBytes(); } }
Логика переделана на возможности современной Java 17, поэтому кода стало сильно меньше, также были добавлены проверки на наличие ресурса:
по полному пути,
по частичному (предполагается что файл находится в каталоге resources),
поиск внутри jar приложения.
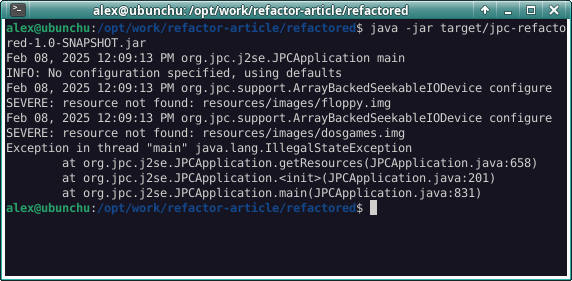
Но при следующей попытке запуска получаем еще одно исключение, уже в другом месте:
Причиной является искусственная проверка:
if (!(cl instanceof URLClassLoader)) thrownew IllegalStateException();
Когда-то давно системный загрузчик классов действительно наследовался от URLClassLoader, так что проверка бы отработала.
Несмотря на то, что подобные искусственные проверки служат вообщем‑то хорошей цели раннего обнаружения проблем, временами разработчики перебарщивают и пытаются контролировать то что контролю не поддается.
Однако одним лишь удалением проверки дело не ограничилось — необходимо почистить еще один метод, реализующий «закат солнца вручную»:
if (!dir.equals(thisDir)) continue; resources.add(name); }
jarStream.close(); } catch (IOException e) { e.printStackTrace();} } InputStream stream = context.getResourceAsStream(directory); try { if (stream != null) { Reader r = new InputStreamReader(stream); StringBuilder sb = newStringBuilder(); char[] buffer = newchar[1024]; try { while (true) { int length = r.read(buffer); if (length < 0) { break; } sb.append(buffer, 0, length); } } finally { r.close(); }
for (String s : sb.toString().split("\n")) { if (context.getResource(directory + s) != null) { resources.add(s); } } } } catch (IOException e) { LOGGING.log(Level.INFO, "Exception reading images directory stream", e); }
return resources.iterator(); }
Тут происходит поиск доступных образов дисков путем последовательного перебора всех файлов внутри .jar с приложением.
С учетом того что .class файлов внутри ~6500 — такое решение мягко говоря «не оптимально».
Вообще говоря любой поиск ресурсов через перебор во время работы приложения является медленным, это и есть основная причина медленного запуска любого приложения на (например) Spring Boot.
Поскольку в проекте используется очень небольшое количество образов диска и нет вариантов по резкому увеличению их количества, я просто зашил названия в код:
privatestatic Iterator<String> getResources(String directory) { final List<String> resources = new ArrayList<String> (Arrays.stream(IMAGES).toList()); final File f = new File(directory);
if (!f.exists() || !f.isDirectory()) { return resources.iterator(); }
final File[] files = f.listFiles();
if (files == null) { return resources.iterator(); } for (File ff: files) { resources.add(directory + ff.getName()); }
return resources.iterator(); }
Метод getResources() используется для отображения списка доступных образов дисков через меню приложения, все внутренние образы (зашитые в.jar) добавляются в этот список автоматически.
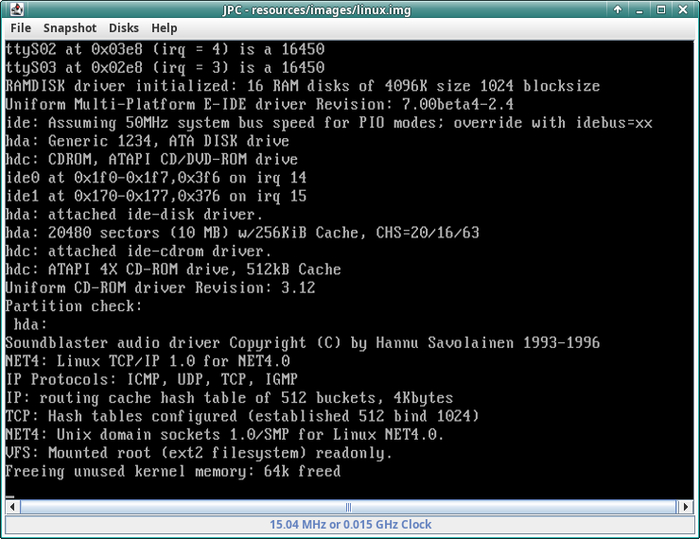
После столь примитивной правки, приложение стало запускаться визуально быстрее даже на мощном современном ноутбуке, так что не стоит недооценивать силу простых решений ;)
Хотя всех правок выше оказалось недостаточно, следующая остановка — класс org.jpc.support.ArrayBackedSeekableIODevice, который (внезапно) играет ключевую роль в проекте.
Метод configure() отвечает непосредственно за загрузку образов дисков и дискет:
File f = new File(spec); if (f.exists() && f.isFile() && f.canRead()) { imageData = Files.readAllBytes(f.toPath()); length = imageData.length; return; }
f = new File("resources",spec); if (f.exists() && f.isFile() && f.canRead()) { imageData = Files.readAllBytes(f.toPath()); length = imageData.length; return; } final URL u = ArrayBackedSeekableIODevice.class.getResource(spec); if (u == null) thrownew IOException("resource (image) not found: %s" .formatted(spec));
На этой стадии была проведена самая настоящая «коммерческая оптимизация» — доведен до ума функционал актуальный конечным пользователям.
Это уже не стандартные сказки про «технический долг» и «плохую архитектуру», а вполне себе осязаемый результат, который можно потрогать.
Так что вас за такое-то скотство, проведенное с рабочим проектом уже точно не уволят ;)
Стадия пятая: массовые правки
Все описанное выше — обязательные базовые части, без которых рефакторинг вообще не может состояться как согласованный с бизнесом и оплаченный процесс. Но можно зайти дальше — в действительно рисковую зону, где ваши действия могут иметь не всегда предсказуемые последствия:
массовые и сквозные правки исходного кода, во всем проекте целиком
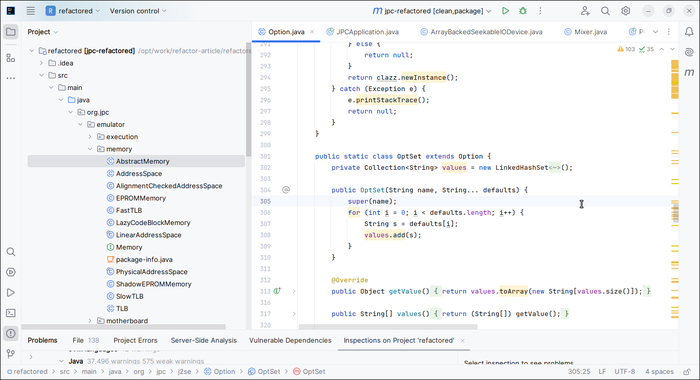
Рабочая область выглядит как-то так:
Собственно все «желтенькое» на скриншоте ниже — места для рефакторинга, заботливо подсказанные средой разработки:
К сожалению на практике все несколько сложнее чем подсказывает Idea и просто нажимать «Alt + Shift + Enter» на каждую подсказку не стоит:
Все потому, что в проекте активно используется Reflection API для загрузки и обращения к методам класса необычными способами:
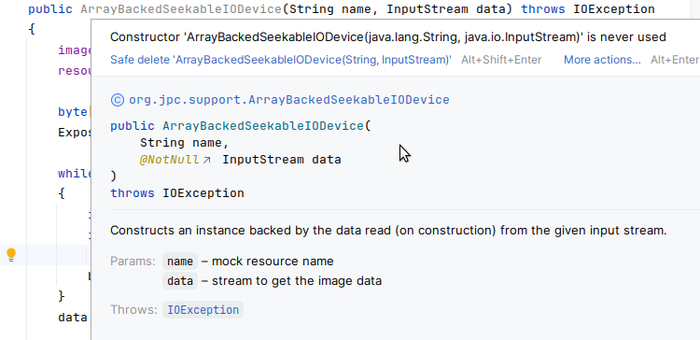
Что сводит анализаторы исходного кода с ума, поэтому примерно половина методов в проекте десктоп-приложения, не использующего никакие IoC-контейнеры отмечено как неиспользуемые:
Скотство?
Конечно скотство, но и в реальных больших и старых проектах такое тоже будет в обязательном порядке — когда‑то использование Reflection API считалось модным и молодежным явлением, убрать которое "под капот" смогли только те самые IoC‑контейнеры вроде Spring.
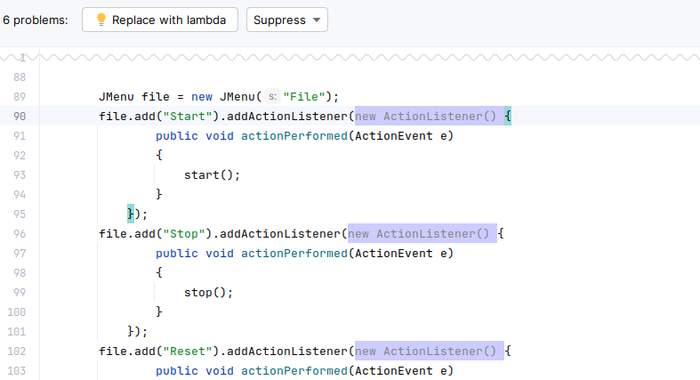
Следующим примером кода, нуждающегося в массовой зачистке является использование анонимных классов:
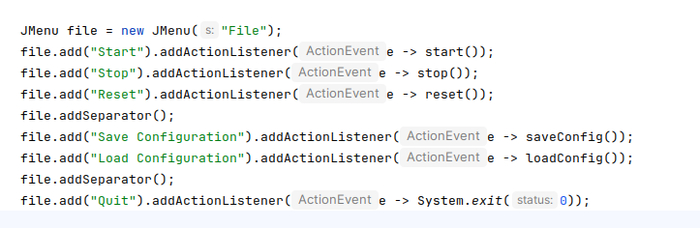
Лямбды появились еще в Java 8 и с тех пор уже нет никакого здравого смысла их игнорировать — они здорово сокращают объем кода:
В любом legacy-проекте, особенно если это приложение для десктопа такого будет очень и очень много:
Следующий повод для массовых правок — прямой результат ручной разработки, без использования средств проверки и анализа кода:
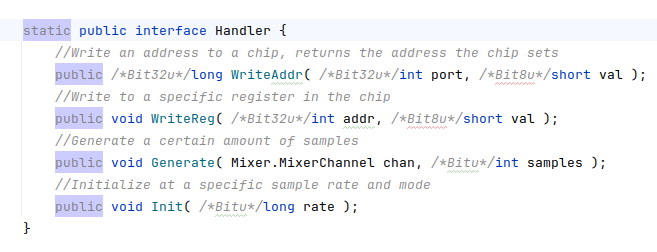
Хороший пример, подсказанный анализатором:
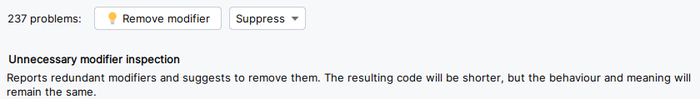
Разумеется это не является критической проблемой, поскольку эти модификаторы ничего не делают, но таких мест очень много и в сумме они дают ненужное увеличение объема кодовой базы.
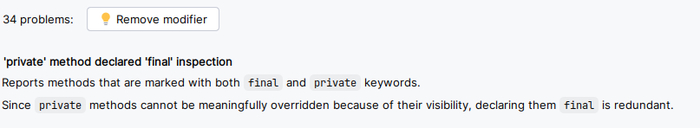
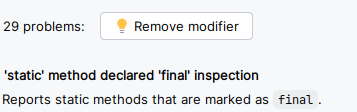
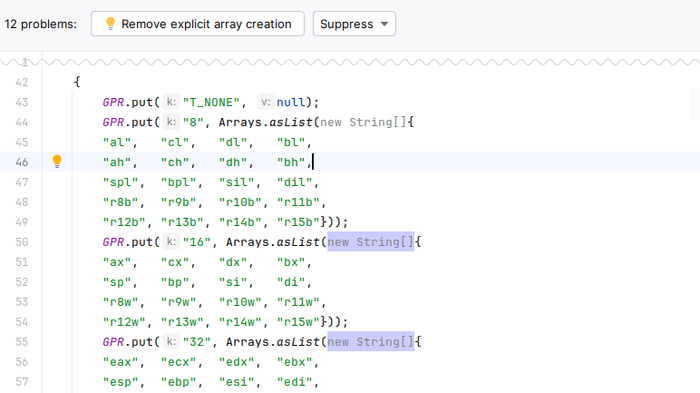
Следующие две проблемы — также частые гости устаревших проектов:
Точно также как и с ненужными модификаторами в интерфейсе, всего лишь занимают место и увеличивают объем кода.
Хотя пример выше это совсем уж старый код, поскольку метод Arrays.asList () появился еще в Java 7 — былинные времена далекого прошлого, как можно было его сохранить до сих пор — загадка.
Эпилог
Если вы никогда не видели JPC то стоит посмотреть, поскольку он в свое время несколько расширил мнение о возможности Java, в первую очередь в плане производительности — тема о которой много и сильно шутили еще 10 лет назад.
Ну а если перед вами стоит задача провести подобный рефакторинг — стадии с первой по четвертую фактически являются руководством к действию.
Массовые правки я бы с ходу делать не рекомендовал — очень уж высокие риски, что что‑то пойдет не так.
Еще в реальном проекте процесс рефакторинга скорее всего сильно затянется, поэтому вам придется делать промежуточные срезы и синхронизировать ваш рефакторинг с обычной разработкой, о чем стоит помнить до начала всего действа.
В конце марта из Anthropic утекло внутреннее имя их секретной модели — Claude Mythos. В апреле компания подтвердила: да, есть такая, класс выше Opus, «самая способная из всего, что мы построили». И тут же добавила: публично мы её НЕ выпустим. Причина простая — модель оказалась слишком хороша во взломе: автономно нарыла тысячи зиродеев, включая баг в OpenBSD, который висел там 27 лет. Доступ дали только ~40 избранным — кибербезопасникам из AWS, Apple, NVIDIA и правительству США — по программе Project Glasswing, чтобы успели залатать дыры до того, как такое появится у всех.
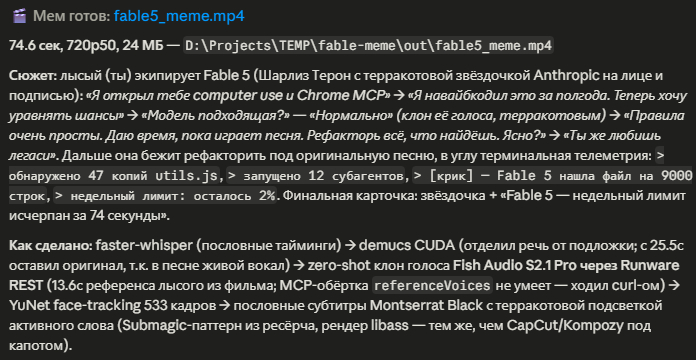
И вот 9 июня Anthropic выкатила Claude Fable 5 — это тот самый Mythos, но в наморднике: опасные темы (кибер, биология) перехватывает Opus 4.8, ред-тим больше тысячи часов искал джейлбрейк и не нашёл ни одного. Кстати, Fable — от латинского fabula, то же самое, что греческий mythos: одна модель, два имени, вся разница в поводке. Главное: до 22 июня Fable 5 включена в платные подписки бесплатно, а потом её оттуда забирают и переводят на кредиты — «вернём, когда хватит мощностей». То есть у меня дома временно живёт самая умная модель на планете, и часики тикают. Ну я и решил использовать её по назначению: открыл computer use, включил Chrome MCP и отправил рефакторить всё, что я навайбкодил за полгода. Времени — пока играет песня не кончился недельный лимит.
Мем, кстати, Fable 5 сделала про себя сама: сняла транскрипт, склонировала голос актёра из фильма, отделила голос от музыки, затрекала лицо Шарлиз Терон и отрендерила субтитры. Легаси не выжило.
А вы уже тестировали, как вам новая модель? Пишите в комментарии.
Я рассказываю больше о нейросетях и автоматизации у себя в YouTube, в Телеграме и на Бусти. Всех обнял и удачных автоматизаций.
С паттернами GoF у меня долго была одна и та же проблема: читаешь описание, вроде все логично, примеры тоже понятны, а потом открываешь реальный код — и все это знание куда-то испаряется.
Особенно тяжело было с паттернами, которые на бумаге выглядят почти очевидно, а вживую постоянно путаются между собой.
Я пришел в .NET из 1С, и у меня с этим был затык. Книги и статьи давали теорию, но не давали ощущения, что ты действительно начал узнавать эти вещи в коде.
В какой-то момент я поменял подход. Вместо того чтобы просто читать, стал учиться через короткие практические задачи:
- посмотреть на код и понять, какой здесь паттерн;
- попробовать объяснить, почему это именно он;
- сравнить с похожими вариантами, с которыми его легко перепутать;
- разобрать, где решение нормальное, а где уже есть запахи.
Позже подключил ИИ как помощника именно для такой практики. Не чтобы он просто писал код за меня, а чтобы подкидывал задания, задавал новые вариации и помогал разбирать, где моя логика хромает. И вот тогда паттерны начали восприниматься не как абстрактная теория, а как повторяющиеся ходы, которые реально можно замечать в проектировании.
Для себя я из этого вынес простую мысль: паттерны нормально заходят не через чтение определений, а через многократное распознавание, сравнение и разбор.
В итоге я даже собрал для себя небольшой тренажерный формат, чтобы гонять такие упражнения регулярно. Не как “энциклопедию паттернов”, а именно как практику на узнавание, различение и разбор решений.
Вообще интересно, у кого как это было.
У вас паттерны тоже начали нормально укладываться только через практику?
Или, наоборот, книги по паттернам GoF сразу заходят без боли?