Сообщество - Нейро-Музыка

Нейро-Музыка

462 поста • 235 подписчиков

Популярные теги в сообществе:

44

Speech Studio: бесплатная замена ElevenLabs — клонирует голос, читает книги и разговаривает с ИИ голосом, локально на своей видеокарте⁠⁠

Собрал десктопную студию голоса Speech Studio. Она озвучивает любой текст пятью открытыми нейросетями, клонирует голос по нескольким секундам записи, превращает запись или видео в текст, где видно, кто что сказал, а ещё с ней можно просто разговаривать: ИИ-агент отвечает голосом и слышит вас через микрофон. Всё считается на вашей видеокарте: без облака, подписок, очередей и без установки Python.

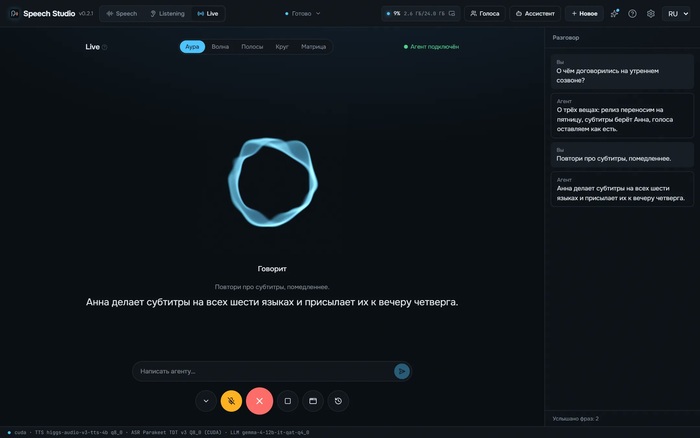
На видео — живой разговор с агентом в режиме Live: в начале он сам рассказывает, что умеет студия, дальше я по очереди переключаю ему движки и голоса и задаю вопросы.

Какие модели внутри

Голос в студии делают пять открытых моделей, и у каждой своя сильная сторона.

Fish Audio Drama 3 — новая модель Fish Audio для сцен с несколькими персонажами и длинных текстов. Внутри 35 млрд параметров, но на каждый токен работают только 3 млрд: это Mixture-of-Experts, где роутер для каждого шага выбирает нескольких «экспертов» из большого набора. Один текст может вести до 16 персонажей, а метки вроде [laughs] или [sighs] прямо в тексте заставляют голос смеяться и вздыхать. Честно скажу: на английском метки работают заметно лучше, чем на русском.

Higgs Audio v3 от Boson AI — тот же движок, что озвучивает в моей Dub Studio. Клонирует голос по короткому образцу и передаёт эмоции и звуки.

Qwen3-TTS 1.7B от Alibaba — самый быстрый на первый звук. Девять встроенных голосов, клонирование и подсказка, как читать, на каждый кусок текста. Его версия VoiceDesign делает новый голос по описанию словами.

Qwen3-TTS с русскими ударениями — та же модель с LoRA от siriusfreak, обученной на русских ударениях. Подключается на лету, отдельная модель не нужна.

Supertonic 3 — маленькая модель на 100 МБ с десятью встроенными голосами. Озвучивает в 168 раз быстрее реального времени и работает даже на процессоре.

Зачем понадобилась студия

Официально все эти модели запускаются из Python через PyTorch, у каждой свои зависимости и своё окружение, а Drama 3 разработчики запускают на серверном фреймворке SGLang-Omni и меряют на видеокартах H200. Поставить их рядом и заставить работать вместе — отдельный квест. Speech Studio выросла из моей Dub Studio и собрана целиком на нативных движках — Rust и C++/CUDA с квантованными весами GGUF и ONNX: один exe для Windows, без Python и зависимостей.

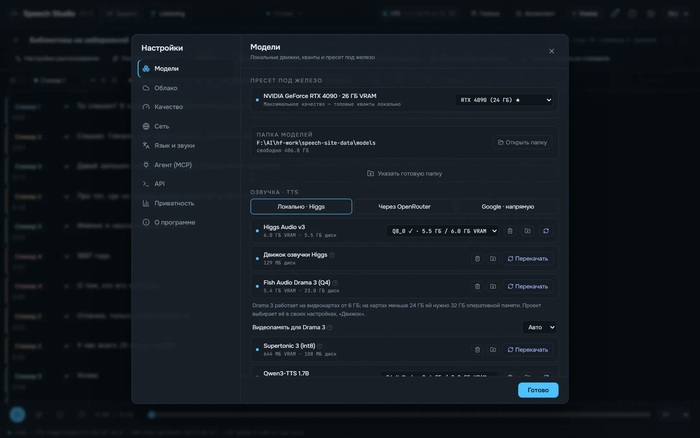
Отдельно повозился с Drama 3. Целиком в квантованном виде она занимает почти всю карту на 24 ГБ, поэтому в движке drama-rs эксперты модели (18 ГБ) переезжают в оперативную память, а на видеокарте остаётся кэш самых нужных. Так она запускается уже с 6 ГБ видеопамяти и при этом говорит бит в бит то же самое, просто медленнее. Внутри студии — всё, что умеют модели, и много сверху:

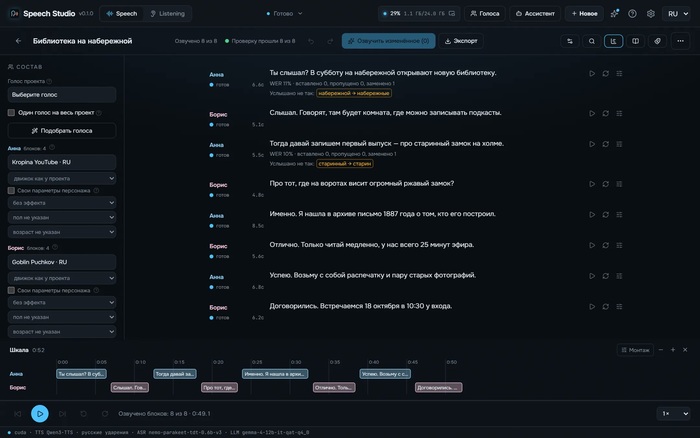
Озвучка чего угодно — фраза, диалог, где строки «Анна: …» сами становятся персонажами со своими голосами, подкаст, который режиссёр на Gemma пишет на заданную тему для двух-трёх спикеров, или закадр по субтитрам SRT точно в их тайминги

Аудиокниги — EPUB, FB2, PDF и DOCX: студия делит книгу на главы, отделяет прямую речь от авторской, раздаёт персонажам голоса и собирает M4B с главами и обложкой, с проверкой громкости ACX

Русский как надо — числа в нужном падеже и роде, даты, время, деньги и единицы словами, латинские бренды и аббревиатуры. Ударения, «ё» и омографы расставляет RUAccent: замо́к или за́мок, му́ки или муки́ он выбирает по смыслу предложения. Свои правила живут в словаре произношения, туда же импортируются словари Balabolka

Каждый дубль проверяется — студия распознаёт озвученное обратно, сверяет со словами текста и ловит клиппинг, тишину, обрыв, щелчок в конце, повтор фразы и музыку вместо речи. Брак переделывается, а из нескольких дублей можно выбрать лучший

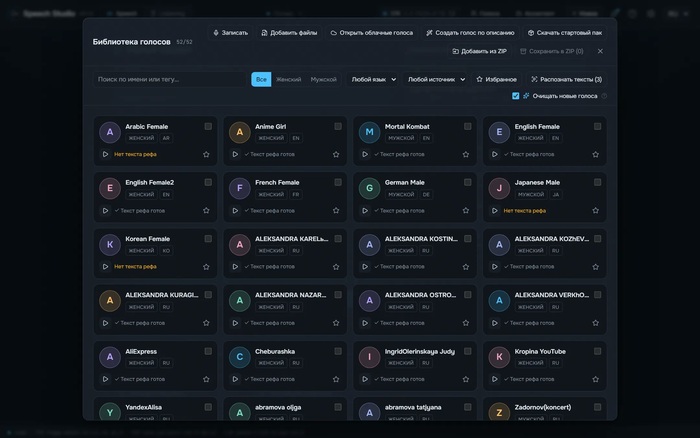
Библиотека голосов — клон по нескольким секундам записи, запись с микрофона, импорт файлов и пак голосов одной кнопкой. Mel-Band Roformer отделяет голос от музыки, DPDFNet убирает шум, а студия сама находит самый чистый кусок образца

Голос по описанию — пишете «пожилая женщина с мягким, чуть хрипловатым голосом», слушаете несколько вариантов и сохраняете лучший в библиотеку

Монтаж и экспорт — трековый редактор под текстом, музыка и звуки из файлов или песня из YuE2, MiniMax Music3 или ACE-Step Studio. Файл на главу, дорожка на персонажа, эффекты рации и телефона, громкость под видео или подкаст, WAV, FLAC, MP3, OGG и M4A

Всё в папке студии — модели, голоса и проекты лежат рядом с exe, установленная версия обновляется сама, а модель, которая уже есть в другой моей студии, берётся оттуда и не качается заново. Интерфейс на шести языках, светлая и тёмная тема
Распознавание речи

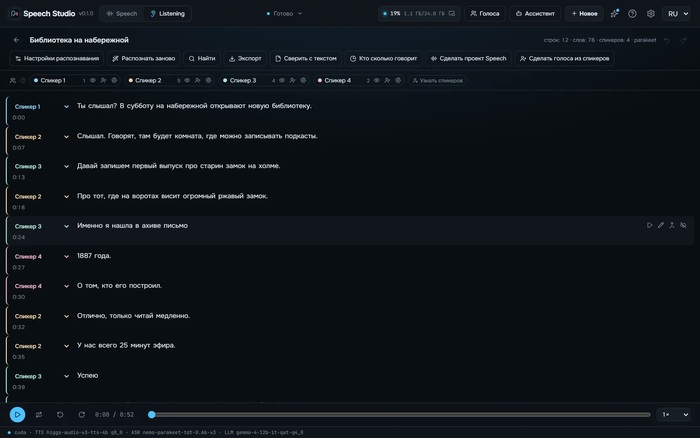
Второй режим, Listening, делает обратное: запись, видео или ссылку превращает в текст, где видно, кто что сказал и когда. Распознают Parakeet-TDT и Nemotron 3.5 от NVIDIA на движке transcribe.cpp или Whisper, говорящих — до восьми человек — размечает Nemotron 3 Diarization, длинная запись режется по паузам Silero VAD, шум убирает DPDFNet. При языке «Авто» его определяет VoxLingua107, и запись сама уходит модели, которая этот язык знает.

С текстом дальше можно работать: плеер-караоке подсвечивает слова, запись монтируется вырезанием слов прямо из текста, субтитры выгружаются по правилам Netflix и BBC в SRT, VTT или ASS. Если наложить на запись сценарий, студия покажет каждое слово, сказанное неверно или пропущенное, — так удобно проверять дубляж. А из говорящих записи можно сразу сделать голоса для библиотеки.

Разговор с агентом голосом

Третий режим, Live, — то, что на видео. Пока студия открыта, она работает как MCP-сервер: Claude Code, Cursor, Codex и другие агенты делают через неё всё, что умеет окно, — озвучивают, распознают, собирают проекты и аудиокниги. А в Live с агентом можно просто разговаривать. Он произносит каждую фразу, как только её написал, не дожидаясь конца ответа. Ваша фраза становится текстом через 0,64–0,74 секунды после того, как вы замолчали, а первый звук ответа приходит через 15 мс – 1 секунду после того, как агент его написал, в зависимости от движка.

Агента можно перебить фразой, и посреди разговора поменять ему голос, распознаватель или язык. Микрофон при этом включает только человек: у агента нет инструмента, который его включает, кнопки включения не принимают его клики, а если окно студии закрыто, микрофон через пять секунд выключается сам. В шапке видно, что микрофон пишет, для чего и сколько.

Программы, написанные под голосовой API OpenAI, тоже работают со студией: она отвечает на тех же запросах, а вместо голосов OpenAI отдаёт голоса вашей библиотеки.

Насколько быстро

Замерил на своей RTX 4090 одним и тем же русским текстом на 17 секунд. Supertonic 3 озвучивает в 168 раз быстрее реального времени, Qwen3-TTS — в 12 раз и выдаёт первый звук через 19 мс, версия с русскими ударениями — в 10 раз, Drama 3 — в 7 раз, Higgs Audio v3 — в 2,3 раза.

Пятиминутную русскую запись Parakeet распознаёт на видеокарте за 3,1 секунды, Nemotron 3.5 — за 4,1, Whisper large-v3-turbo — за 15,4. На процессоре Parakeet справляется за 9,2 секунды, Whisper — за 134.

Что нужно для запуска

Система: Windows 10/11 x64; Linux — экспериментально

Видеокарта: NVIDIA от 8 ГБ VRAM (GTX 16 / RTX 20 и новее); Drama 3 целиком — 24 ГБ, с 6 ГБ — с экспертами в оперативной памяти, тогда её нужно 32 ГБ

Место на диске: около 9 ГБ под модели и движки по умолчанию, Drama 3 — ещё 23 ГБ

Лицензия: студия — MIT, у каждой модели своя лицензия

Установка

  1. Скачайте с GitHub установщик (обновляется сам) или портативный архив — его можно распаковать куда угодно.

  2. Запустите Speech Studio и отметьте на первом экране, что нужно: голоса, распознавание, дополнения.

  3. Нажмите «Скачать отмеченное» — модели и движки скачаются один раз и живут в папке программы.

  4. Вставьте текст и нажмите «Создать», бросьте запись в Listening или включите микрофон в Live.

Примеры голосов всех движков, русские ударения до и после и полные таблицы замеров можно послушать и посмотреть на странице проекта.

⭐️ Поставить звезду на GitHub

📦 Скачать релиз, портативку или установщик

А больше удобных репаков полезных нейросетей в моем телеграм канале НейроСофт
Показать полностью 5

Три вершины. Эпичный хэви-боевик про трех казахских батыров - Кабанбая, Богенбая и Наурызбая⁠⁠

Масштабный исторический хэви-метал боевик «Три вершины», посвященный эпохе борьбы казахского народа с джунгарским нашествием в XVIII веке.

«Три вершины» — это поэтическая степная метафора, воспевающая троих легендарных батыров: Кабанбая, Богенбая и Наурызбая, которые сплотили три жуза в единый стальной кулак под знаменем хана Абылая.

Показать полностью
5

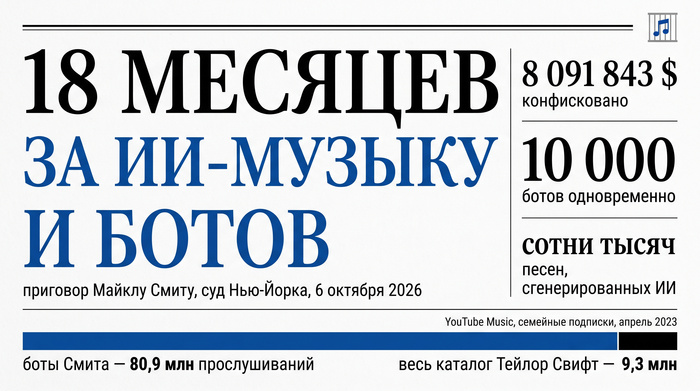
Американца посадили на 18 месяцев за накрутку ИИ-треков ботами: он отдаст 8 млн долларов роялти⁠⁠

Американца посадили на 18 месяцев за накрутку ИИ-треков ботами: он отдаст 8 млн долларов роялти

Федеральный суд Манхэттена вынес первый в США приговор за мошенничество со стримингом музыки. 54-летний Майкл Смит из Северной Каролины семь лет заливал на Spotify, Apple Music, Amazon Music и YouTube Music сотни тысяч сгенерированных ИИ песен и крутил их армией ботов. Итог — 18 месяцев тюрьмы, два года надзора и конфискация 8 091 843 долларов.

Как работала схема

С 2017 года Смит заводил тысячи фейковых аккаунтов на поддельные почты и мошеннически полученные карты, а софт заставлял их слушать его треки без перерыва — до 10 000 ботов одновременно. Чтобы антифрод не заметил аномалий, прослушивания размазывались по огромному каталогу, и тут пригодился ИИ: глава ИИ-музыкальной компании поставлял ему тысячи треков в месяц за долю дохода.

Масштаб прокуратура показала на примере: в апреле 2023-го весь каталог Тейлор Свифт собрал на YouTube Music по семейным подпискам 9,3 млн прослушиваний, а боты Смита — 80,9 млн. Обвинение просило минимум 46 месяцев, защита — условный срок. Деньги при этом крадут не у платформ, а у музыкантов: роялти платят из общего котла пропорционально доле прослушиваний, и каждый фейковый стрим уменьшает выплату всем остальным.

Похожие дела: топ по деньгам

Уголовных дел о накрутке стримов в мире единицы. Вот всё, что нашлось с подтверждёнными суммами:

1. MediaMuv, США — 23 млн долларов. Хосе Теран и Вебстер Батиста через посредника в YouTube Content ID присвоили права на 50 тысяч чужих песен и собирали за них роялти. Ботов не было, но это крупнейшая известная кража музыкальных роялти: Теран получил 70 месяцев, Батиста — 46.

2. Майкл Смит, США — 8,09 млн долларов. ИИ-треки и боты, 18 месяцев. По письму прокуратуры, всего ему перевели больше 14 млн.

3. Дания — не меньше 3,5 млн крон (около 500 тыс. долларов). Накрутка ботами 689 треков, в 2025-м апелляция подняла срок до двух лет, из которых реально сидеть три месяца.

4. Бразилия — изъято имущества на 2,3 млн реалов (около 400 тыс. долларов). Певец из Ресифи с фермой ботов и сотнями фейковых треков на Spotify, арест в декабре 2024-го.

5. Южная Корея — сумма не раскрыта. 11 сотрудников агентств обвинили в накрутке чартов: 15 песен прокрутили 1,73 млн раз через 500 виртуальных ПК.

Почему это важно

По оценке Beatdapp, фейковые стримы ежегодно уводят из индустрии около 2 млрд долларов роялти. Deezer в 2025-м считал мошенническими до 85% прослушиваний полностью сгенерированных треков, а в июне 2026-го получал около 90 тысяч ИИ-треков в день. Генераторы сделали бесконечный каталог бесплатным для всех, так что первый приговор вряд ли станет последним.

Источники: TechRepublic, Music Business Worldwide, Billboard

НЕЙРО-ЗВУК ● Генерация музыки и звуков

Показать полностью
0

Сооснователь Napster Шон Паркер перестраивает Stability AI в музыкальную компанию с деньгами трёх мейджоров⁠⁠

Сооснователь Napster Шон Паркер перестраивает Stability AI в музыкальную компанию с деньгами трёх мейджоров

Человек, чей Napster когда-то чуть не похоронил музыкальную индустрию, теперь строит ИИ-инструменты для музыкантов вместе с этой самой индустрией. Stability AI, создатель Stable Diffusion, окончательно делает ставку на звук, а в инвесторах у неё Universal, Sony и Warner.

Что изменилось

Паркер пришёл в Stability AI два года назад, когда компанию спасали раундом на 80 млн долларов после ухода основателя Эмада Мостака, перерасхода денег и внутреннего хаоса. Гендиректором стал его давний друг Прем Аккараджу. Теперь Stability позиционирует себя как поставщика инструментов для профессионалов музыки, а не как генератор «песен по кнопке».

В конце августа компания привлекла 76 млн долларов в раунде серии B. В нём участвовали все три крупнейших лейбла — Universal Music Group, Sony Music и Warner Music, а также Electronic Arts и AMD Ventures. Перед этим вышла Stable Audio 3.0 — семейство музыкальных моделей, обученных на лицензированных данных. Лейблы, по данным TechCrunch, открыли свои каталоги для обучения в рамках сделки.

Что умеют инструменты

Stability выпустила три новые аудиомодели и софт для ИИ-редактирования музыки. Они генерируют инструменталы и фрагменты по текстовому описанию. Следующий шаг — управление голосом: можно будет напеть мелодию или отбить бит битбоксом, и модель построит трек вокруг этого.

«Просить прощения вместо разрешения в прошлый раз сработало не очень».

Так Паркер объясняет, почему на этот раз всё с лицензиями.

Почему это важно

Suno и Udio сначала получили от лейблов иски за обучение на чужих песнях и только потом пошли договариваться. Stability сразу зашла через лицензии и деньги мейджоров. Это другая модель рынка: ИИ не как замена музыканту, а как инструмент в студии, за который лейблы получают долю.

Вопросы без ответа

Сколько с каждой такой генерации получат сами артисты, чьи песни ушли в обучение, а не их лейблы? И не станет ли «лицензированный ИИ» с акционерами-мейджорами способом закрыть рынок для независимых генераторов?

Источники: TechCrunch · RouteNote

НЕЙРО-ЗВУК ● Генерация музыки и звуков

Показать полностью 1
2

ИИ-агент Muse от Meta* заводит досье на каждого человека из вашей жизни⁠⁠

ИИ-агент Muse от Meta* заводит досье на каждого человека из вашей жизни

Исследователь вытащил из Muse системные инструкции, и в них прямым текстом сказано: завести «страницу на каждого человека в жизни пользователя». Родственники, партнёры, друзья, коллеги, даже те, на кого вы просто подписаны, — все они получают профиль, хотя самих их никто не спрашивал.

Что лежит в этих профилях

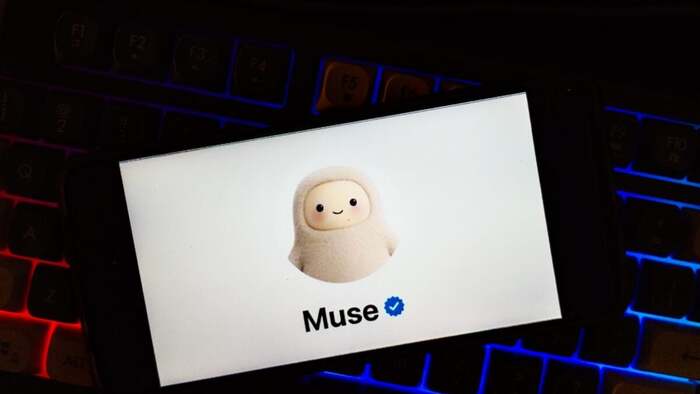
Muse — персональный агент Meta, который вышел 8 сентября и быстро поднялся на первое место среди бесплатных приложений американского App Store. Он работает в облаке в отдельной виртуальной машине, читает почту, бронирует поездки, покупает и оплачивает товары и продолжает работать после закрытия приложения.

Независимый исследователь безопасности ИИ Каран Джоши вытащил его инструкции обычной перепиской с агентом. На каждого человека Muse ведёт отдельный файл: имя и кем он вам приходится, повторяющиеся темы разговоров (переезд, накопления), дни рождения и годовщины, история отношений, уровень близости, характер общения и «текущие потребности отношений». Плюс публичная информация: где человек живёт, чем занимается, не переехал ли недавно.

«Они хотят понять ваши отношения… узнать вас, как друг. Честно говоря, это довольно жутко».

Что отвечает Meta

В Meta говорят, что без контекста о вас и ваших близких полезного агента не сделать, а данные Muse собирает из публичных источников и того, чем вы сами поделились. Хранятся они в вашей личной виртуальной машине, и агенты других людей к ним доступа не имеют.

Но переписки и вызовы инструментов по умолчанию идут на обучение моделей, если не отключить это вручную. Meta обещает перед этим вычищать персональные данные — проверить это снаружи нельзя. «Конфиденциальную VM», куда даже сама Meta не сможет заглянуть, обещают только «позже в 2026-м». Колумнист Джейсон Атен пожаловался, что Muse предложил ему разобрать переписку, к которой он доступа не давал. В Meta это оспаривают.

Вопросы без ответа

Ваш друг не ставил Muse и ни на что не соглашался — как ему узнать, что на него есть файл, и как его удалить? Попадает ли «уровень близости» и «история отношений» третьих лиц в обучение после «вычистки», и что вообще считается персональными данными в тексте о чужих ссорах? И главное: зачем компании, живущей на рекламе, карта ваших связей с пометками, кто кому насколько близок?

* Meta признана экстремистской организацией, её деятельность запрещена на территории Российской Федерации.

Источники: Gizmodo · Wired · Implicator

НЕЙРО-ПУШКА ● Новости и обзоры нейросетей

Показать полностью
6

ElevenLabs выпустила Eleven v4: голосовая модель, которая играет, а не читает⁠⁠

ElevenLabs представила Eleven v4 и её быструю версию v4 Turbo. Модель построена на новой архитектуре: она разбирает по тексту тон, темп, эмоцию и характер персонажа и держит голос одинаковым на всей длинной записи, даже если перегенерировать отдельную реплику. Смеётся, шепчет, всхлипывает и отыгрывает звуковые эффекты она теперь заметно стабильнее, чем v3. В ролике выше — официальное демо: всё сгенерировано по промптам на экране, без монтажа.

Что умеет

Эмоцию задают тегами прямо в тексте — вроде [excited] или [sleepy drowsy voice]. Клонирование голоса теперь работает по 10 секундам записи. Языков больше 90 (у v3 было около 70), и клонированный голос говорит на чужом языке с родным акцентом, не уплывая в другой тембр.

Цифры

В рейтинге Speech Arena от Artificial Analysis v4 вышла на первое место. В слепых парных тестах, где слушатели выбирали более выразительный вариант, она выиграла 81% пар у Cartesia Sonic 3.6 и Inworld TTS-2, 72% у Gemini 3.8 Flash-Lite TTS и 65% у Gemini 3.8 Flash TTS.

Turbo-версия для голосовых агентов выдаёт первый звук примерно через 150 мс. Обе модели уже доступны в API, ElevenCreative и ElevenAgents, в том числе на бесплатном тарифе. По данным The Decoder, v4 стоит 80 долларов за миллион символов, Turbo — 40, а до 12 октября действует скидка до 22 и 11 долларов.

Для озвучки роликов, аудиокниг и игр это заметный шаг: главная беда синтеза речи — ровная «дикторская» интонация и плывущий от реплики к реплике голос — здесь атакована напрямую.

Живые аудиопримеры (эмоции, сонный голос, оригинал против клона) — в посте на канале.

Источники: ElevenLabs, TechCrunch, The Decoder

НЕЙРО-ЗВУК ● Генерация музыки и звуков

Показать полностью
5

Google выпустила Gemini 3.8 Flash TTS: голос для озвучки теперь описывают словами⁠⁠

Google представила две модели синтеза речи: Gemini 3.8 Flash TTS и облегчённую Flash-Lite TTS. Главная фишка — дизайн голоса. Диктора больше не выбирают из каталога: пишешь, кого хочешь услышать (роль, акцент, тембр), и модель собирает новый голос с нуля. В примерах Google — диджей из Мельбурна, монотонный робот и японский дракон.

Что умеет

Больше 100 языков и диалектов, а библиотека готовых голосов выросла с 30 до 2000 с лишним, включая региональные варианты вроде мексиканского испанского и квебекского французского. Модель играет по ремаркам: к каждой реплике можно дописать, как её произнести, вставить смех, вздох или поддакивание «угу», развести диалог на два голоса. Google обещает, что голос не «плывёт» даже на часах непрерывного аудио, а это критично для аудиокниг и подкастов.

Клонировать можно и собственный голос: нужны 30 секунд записи и отдельно записанное согласие, причём голос в согласии должен совпасть с образцом. Во всё сгенерированное вшивается неслышимая метка SynthID.

Цена и качество

До конца 2026 года миллион токенов звука стоит 9 долларов у Flash и 6 у Flash-Lite, с 2027-го — вдвое дороже. Секунда аудио — 25 токенов, так что час озвучки на Flash обходится примерно в 80 центов. Модели уже доступны в Gemini API и Google AI Studio без листа ожидания, открытых весов нет.

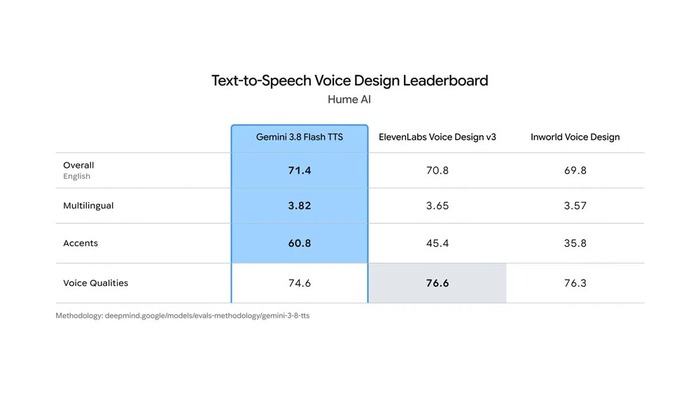
В бенчмарке дизайна голоса от Hume AI Flash TTS первая с 71,4 балла, но от ElevenLabs Voice Design v3 (70,8) её отделяют доли балла, а по естественности тембра ElevenLabs всё ещё впереди. Заметно Google обходит конкурентов только в акцентах: 60,8 против 45,4.

Дизайн голоса по описанию до сих пор был козырем ElevenLabs. Теперь Google отдаёт то же самое через API, на сотне языков и дешевле доллара за час, и для озвучки игр, дубляжа и аудиокниг голос персонажа становится вопросом одной строки текста, а не кастинга.

Источники: MarkTechPost · The Decoder · Google

НЕЙРО-ЗВУК ● Генерация музыки и звуков

Показать полностью 1
288

YuE2 Studio: бесплатная замена Suno, нейросеть сначала пишет ноты, потом поёт песню — теперь локально на своей видеокарте⁠⁠

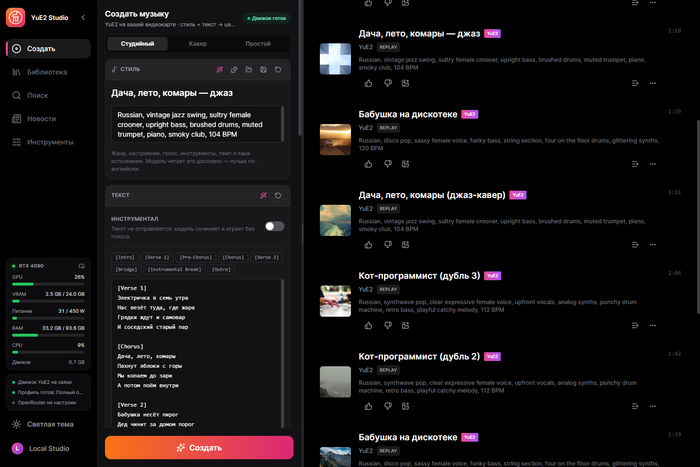
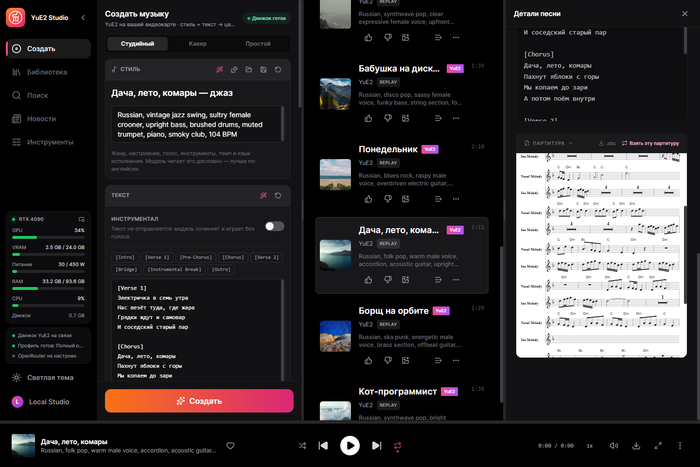
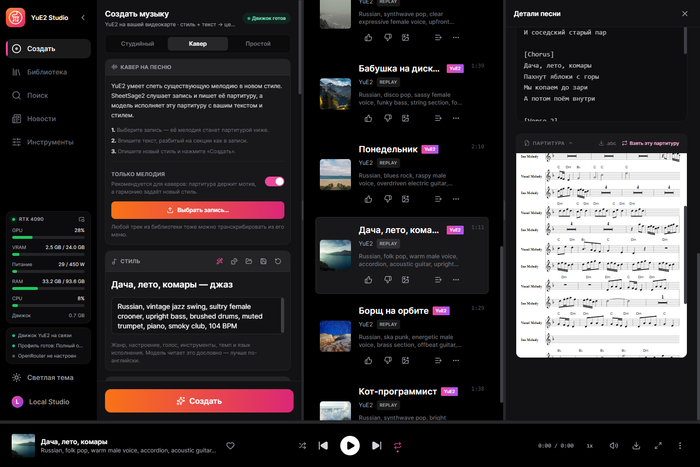
Собрал десктопную студию для YuE2 — новой открытой модели генерации песен от команды M-A-P (Multimodal Art Projection). Пишете стиль и текст, получаете полноценную песню с вокалом и аккомпанементом в 48 кГц стерео. Всё считается на вашей видеокарте: без облака, подписок, очередей и без установки Python.

Что за модель YuE2

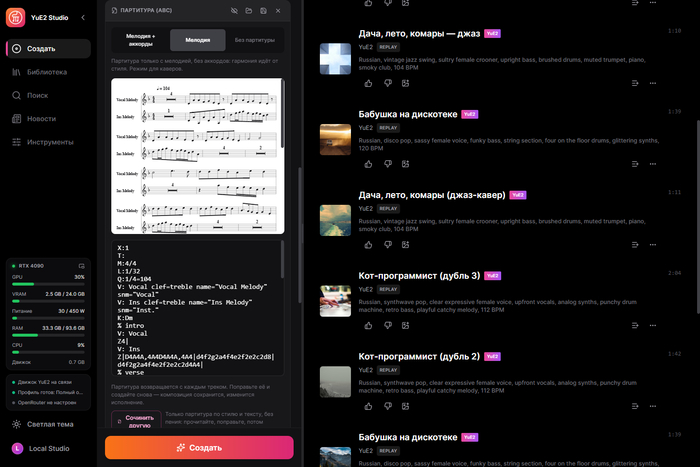
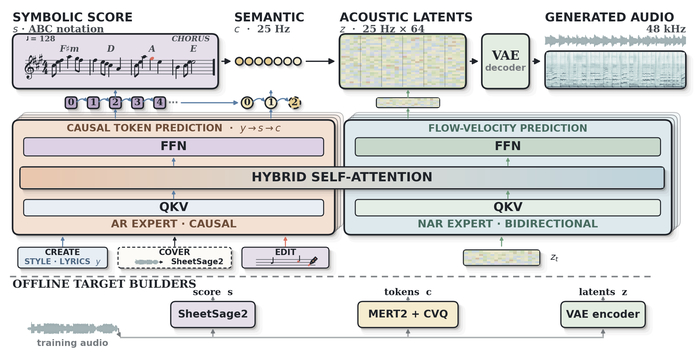
YuE2 — вторая версия открытой модели YuE. Её главная идея — символьное планирование: прежде чем петь, модель пишет композицию нотами в формате ABC — мелодию вокала, инструментальную тему и аккорды — и только потом по этой партитуре генерирует звук. У закрытых сервисов вроде Suno партитуры нет: песня выходит такой, какой вышла, и одну ноту в ней не поправишь. Здесь можно открыть ноты, поменять мелодию, аккорды, темп или тональность и перепеть ту же композицию.

Внутри один трансформер примерно на 3,6 млрд параметров, собранный из двух «экспертов» с общим вниманием (Mixture-of-Transformers):

  • AR-эксперт (причинный, токен за токеном) читает стиль и текст, пишет партитуру, а по ней — семантические токены музыки, 25 штук в секунду;

  • NAR-эксперт (двунаправленный) методом flow matching превращает эти токены в акустические латенты;

  • VAE-декодер собирает из латентов готовое стерео 48 кГц.

Для каверов в ту же схему встраивается SheetSage2: он слушает запись и снимает с неё мелодию в такую же партитуру, которую YuE2 потом поёт в новом стиле. Схема из официальной карточки модели на Hugging Face:

Насколько хорошо она поёт

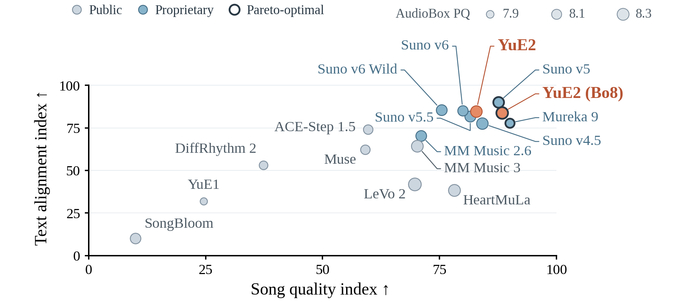
Авторы прогнали модель через WildSongBench — 192 промпта и 17 систем, включая свежий Suno v6. По среднему баллу SongBench YuE2 в режиме best-of-8 (лучший из восьми вариантов) набрала 6,96 — это выше Suno v5 (6,87), Mureka 9 (6,94) и Suno v6 (6,56). В обычном режиме, где выбирается лучший из двух, — 6,73. Это цифры самих авторов, но и на слух модель действительно выдаёт цельные песни с понятной дикцией.

Партитура решает и в каверах. На тесте SHS100K YuE2 с полной партитурой сохраняет мелодию так, что кавер узнаётся как та же песня в 71% случаев — у открытой ACE-Step 1.5 на этом же тесте 2,4%. На графике ниже по горизонтали качество песни, по вертикали — насколько точно модель следует тексту и описанию:

Зачем понадобилась студия

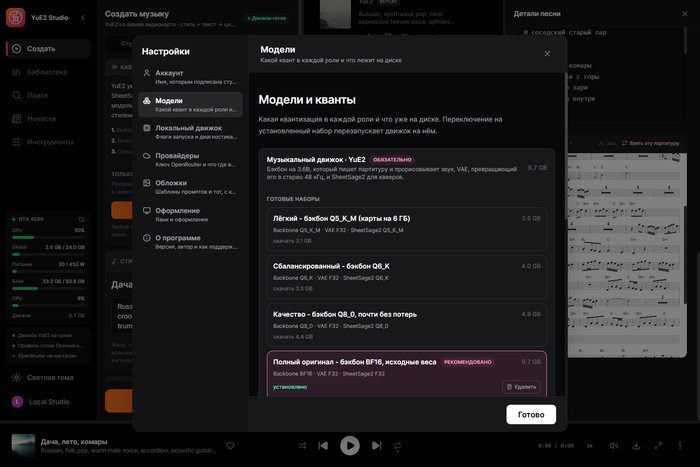
Официально YuE2 запускается из Python-кода через PyTorch, а для полной точности нужна карта на 24 ГБ. Я собрал YuE2 Studio на нативном движке yue2.cpp (C++/CUDA с квантованными весами GGUF): один exe для Windows, без Python и зависимостей, работает от 6 ГБ видеопамяти. Внутри — всё, что умеет модель, и ещё немного сверху:

  • Полные песни до шести минут по стилю и тексту. На RTX 4090 трек длиной 3:38 рендерится примерно за 46 секунд

  • Редактируемая партитура — композиция приходит нотным станом и текстом ABC. Поменяли ноты, темп или тональность — композиция та же, исполнение новое. Режимы «мелодия с аккордами», «только мелодия» и «без партитуры»

  • Сначала только ноты — партитура за секунды, без пения: прочитать, поправить и уже потом петь

  • Каверы — SheetSage2 снимает мелодию с записи, YuE2 поёт её в вашем стиле. Слова должны ложиться на эту мелодию: оригинальный текст или новый с тем же числом слогов в каждой строке и ударениями на тех же нотах

  • Точный перерендер — каждый трек хранит запрос и аудиокоды: его можно отрисовать заново бит в бит или с другими шагами, сидом звука и форматом, не сочиняя заново

  • Ассистент-соавтор — локальная Gemma или OpenRouter пишет стиль и текст по идее в одну строку и правит партитуру по просьбе

  • Караоке по словам — тайминг каждого слова через Parakeet или Whisper, а встроенный видеоредактор собирает из трека клип с караоке прямо на видеокарте

  • Разбор песни на дорожки — трек раскладывается на шесть стемов: барабаны, бас, вокал, гитару, пианино и всё остальное. Можно вытащить минус или чистый вокал

  • 110 готовых примеров из yue2.cpp в один клик и доступ ко всем настройкам движка: сэмплинг, шаги, гайденс, сиды, MP3 или WAV 16/24/32 бит

  • Библиотека — поиск, плейлисты, обложки по шаблонам, MP3 с названием, текстом и обложкой в тегах

  • Всё рядом с exe — модели, песни, настройки и временные файлы лежат в папке студии, установленная версия обновляется сама. Интерфейс на русском, английском, китайском, японском и корейском

Что нужно для запуска

  • Система: Windows 10/11 x64

  • Видеокарта: NVIDIA от 6 ГБ VRAM (GTX 16 / RTX 20 и новее); AMD и Intel через Vulkan — экспериментально

  • Место на диске: от ~4 ГБ с лёгким набором моделей до ~34 ГБ со всеми самыми тяжёлыми

  • Лицензия: студия — MIT, веса YuE2 — CC BY-NC 4.0, то есть песни только для некоммерческого использования

Установка

1. Скачайте с GitHub установщик (обновляется сам) или портативный архив — его можно распаковать куда угодно.
2. Запустите YuE2-Studio.exe: студия определит видеокарту и предложит подходящий набор моделей от 3,6 до 10,4 ГБ.
3. Нажмите «Скачать» — загрузка идёт в несколько потоков, с докачкой и проверкой контрольных сумм.
4. Напишите стиль и текст или откройте пример и нажмите «Создать» — движок запустится сам.

Песни, сделанные в студии, на русском, английском, испанском, китайском и японском, можно послушать на странице проекта. А выше — клипы с караоке, собранные встроенным видеоредактором.

⭐️ Поставить звезду на GitHub

📦 Скачать релиз, портативку или установщик

А больше удобных репаков полезных нейросетей в моем телеграм канале НейроСофт
Показать полностью 7 4
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества