
Как вариант5
Показать полностью
1
Дело было на последнем курсе универа. До защиты диплома оставался буквально месяц. Напряжение в воздухе стояло такое, что можно было заряжать телефоны. Я, как и половина потока, находился в состоянии перманентного недосыпа, стресса и легкого слабоумия от бесконечного переписывания третьей главы. И вот, вызывают меня и ещё пару человек в деканат. Заходим. За столом сидит хмурая методистка, перед ней стопка каких-то бумаг.— Так, парни, — говорит она замотанным голосом, — подписываем вот здесь, что вы уведомлены об отчислении, забираем обходные листы и не задерживаем очередь.В моей уставшей голове в этот момент что-то коротнуло. Слово «отчисление» сработало как триггер. Мне показалось, что всё кончено. Вспомнились все мои косяки с преддипломной практикой, недопонимания с научруком и три пропущенных семинара. Я на полном серьезе подумал: «Ну всё, приплыли. Меня отчисляют за шаг до финиша. Комиссия, видимо, посмотрела мой черновик и решила даже не позориться на защите».В состоянии полнейшего тильта, не приходя в сознание и даже не вчитываясь в текст, я размашисто ставлю свою подпись в ведомости, забираю какую-то бумажку (как мне тогда показалось — «расписку об отчислении») и на ватных ногах выхожу в коридор.Вместо того чтобы пойти к декану, начать качать права или хотя бы спросить у одногруппников «Ребята, а за что?!», я включил режим гордого и обиженного фаталиста. Пришел в общагу, собрал вещи, швырнул флешку с дипломом в угол и уехал домой в родной город. Думаю: «Раз отчислили — значит, судьба такая. Всё равно скоро повестка придёт».Повестка, к слову, пришла очень быстро. Военкомат у нас работает четче, чем швейцарские часы. Раз отсрочки больше нет — добро пожаловать в ряды ВС РФ. Год в армии пролетел в тумане, берцах и нарядах. Самая жесть случилась уже после дембеля. Я вернулся домой, возмужал, решил, что надо как-то устраиваться в этой жизни и забрать хотя бы школьный аттестат из универа, чтобы поступить хоть куда-нибудь заново.Приезжаю в родную альма-матер, прихожу в тот самый деканат. Нахожу ту самую методистку.— Здравствуйте, — говорю, — я такой-то, меня год назад отчислили перед защитой. Пришел забрать свои школьные документы.Методистка удивленно смотрит на меня, открывает базу данных, потом лезет в архив. Достает мою папку, долго листает и начинает откровенно ржать.— Милый мой, — сквозь смех говорит она, — да кто ж тебя отчислял? Ты в списках на защиту шел под третьим номером!— Как не отчисляли? — бледнею я. — Вы же сами мне тогда дали расписку об отчислении подписать!И тут она достает ту самую бумагу с моей подписью. Оказывается... Это была стандартная расписка-заявление о «предстоящем отчислении в связи с успешным окончанием учебного заведения»! Такие бумаги у нас собирали заранее, чтобы сразу после защиты диплома студентов официально отчислили выпускниками и выдали корочки на руки, без бюрократических проволочек.То есть меня никто не выгонял. Меня ждали на защите. А я просто подписал бумагу, которую подписывали абсолютно все, сам себя накрутил, молча собрал вещи и добровольно ушел в армию, сорвав себе выпускной. Диплом мой, естественно, аннулировали, так как на саму защиту я просто не явился без уважительной причины.Итог: прошел преддипломную практику, написал работу, подписал «бумагу об отчислении», оттоптал год в сапогах. На руках — чистый школьный аттестат и звание «Главный лох курса».Читайте, пацаны, что подписываете. Даже если очень хочется спать.
Я и мои коллеги занимаемся в том числе SEO-продвижением. И в последнее время от заказчиков все чаще появляется требование, что текст должен показывать низкий процент сгенерированности в определенном AI-детекторе.
Логика понятна. Заказчик не хочет платить за материал, который за минуту сделали в нейросети. Поэтому автору предлагают прогнать текст через сервис и приложить скриншот: вот, например, 95% вероятности, что текст написал человек.
Проблема начинается, когда самостоятельно написанный материал такой результат не получает.
Я решил провести простой эксперимент и достал свою выпускную квалификационную работу. Ее я писал полностью самостоятельно, с нуля: собирал источники, формулировал мысли, переписывал абзацы и приводил все к требованиям научрука. То есть происхождение текста мне известно абсолютно точно.
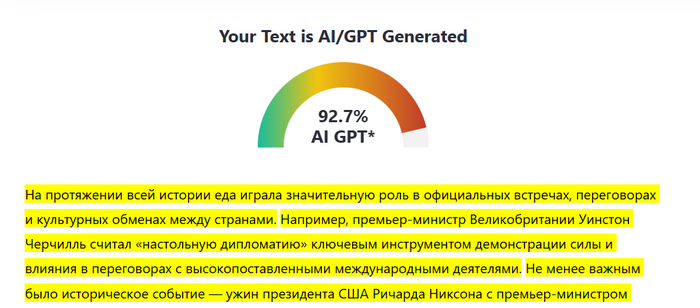
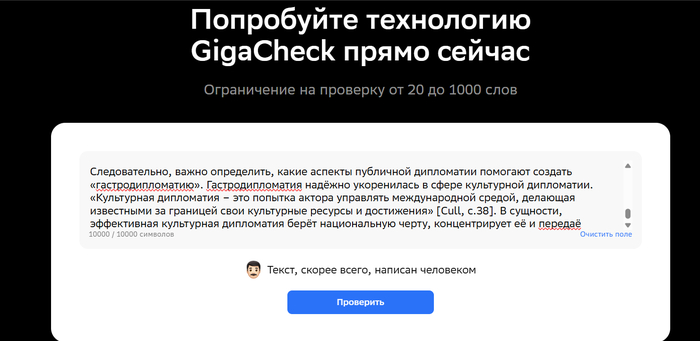
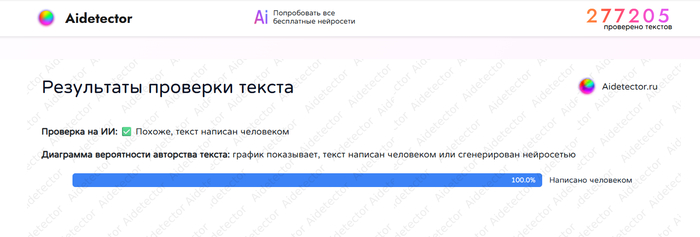
Я взял один и тот же фрагмент ВКР и проверил его в двух детекторах.
Первый сообщил, что текст с вероятностью 92% сгенерирован искусственным интеллектом.
Второй на том же самом фрагменте показал 99% вероятности, что текст написан человеком.
Получается любопытная ситуация.
Текст один. Автор один. История его создания не менялась. Но в зависимости от выбранного сервиса заказчик может либо спокойно принять работу, либо обвинить автора в использовании нейросети.
И это, на мой взгляд, главная проблема требований вроде «не более 10% ИИ».
Сам процент ничего не доказывает. Он не показывает историю создания документа, не знает, кто набирал текст, и не видит, сколько времени автор потратил на поиск источников и редактуру.
Тем более нельзя напрямую сравнивать результаты разных сервисов. Число 92% в одном детекторе и 100% в другом — не измерения по единой шкале. Каждый инструмент оценивает текст по собственным правилам, поэтому на выходе можно получить противоположные выводы.
Это не означает, что AI-детекторы вообще бесполезны. Их можно использовать как дополнительный сигнал: например, обратить внимание на слишком шаблонные формулировки, повторы или однообразную структуру.
Но делать процент сгенерированности главным критерием приемки текста — сомнительная практика.
Гораздо полезнее оценивать:
— соответствует ли материал задаче и поисковому запросу
— подтверждены ли факты и указаны ли источники
— есть ли в тексте конкретика и авторская экспертиза
— нет ли плагиата
— можно ли посмотреть историю версий документа
— способен ли автор объяснить и доработать написанное
После этого эксперимента требование приложить скриншот из детектора стало выглядеть для меня примерно как проверка температуры двумя градусниками: один показывает жар, другой — что все в порядке, хотя измеряют они одного и того же человека.
Поэтому результат AI-детектора я бы воспринимал не как доказательство, а только как повод внимательнее посмотреть на текст.
Вообще, нейросети и связанные с ними сервисы мы стараемся проверять именно так — не по обещаниям на главной странице, а на реальных задачах. Подобные эксперименты, разборы инструментов и сервисы, которые действительно могут пригодиться в работе, собираем в нашем Telegram-канале.
А у вас возникали ли проблемы в работе из-за ИИ-детекторов?
Плохая оценка неприятна, но в ней есть одна странная милость: это уже конец. Получил, расстроился, пошел дальше. А правки работают иначе. Они не закрывают историю, а снова открывают дверь в текст, из которого человек уже мысленно вышел.
До замечаний почти у всех одно и то же чувство: ну все, осталось немного. Файл собран, главы на месте, литература вроде есть, оформление почти дожато. В голове уже начинается финал. А потом приходит список комментариев, и внезапно выясняется, что "почти готово" означает переписать введение, уточнить цель, заменить источники, пересобрать выводы и объяснить таблицы, которые вчера казались вполне нормальными.
Поэтому правки бьют не только по времени. Они бьют по надежде. Оценка говорит: получилось так себе. Правки говорят: ты еще вообще не выбрался. Это особенно тяжело после длинной усталости, когда сил хватает только на мечту дотянуть до сдачи, а не на новый круг разбора.
Хуже всего работают мутные замечания вроде "усилить аналитику" или "слабая логика". Когда тебе указывают конкретный источник, это хотя бы задача. А когда перед глазами туман, человек видит не список действий, а бездонную яму, в которую сейчас снова придется лезть. Отсюда и вечное откладывание. Не потому что лень, а потому что страшно снова сделать работу незавершенной.
Наверное, поэтому правок боятся сильнее плохой оценки. Они возвращают автора туда, где снова надо думать, а не просто дотерпеть. И единственное, что тут хоть немного спасает, это разбирать их не как красную лавину, а как набор задач разной тяжести. Иначе замечания кажутся монстром. Хотя на деле это просто болезненное напоминание: файл готов не тогда, когда дописан, а когда ты еще можешь объяснить, зачем там все устроено именно так.
На защите одна из самых неловких сцен выглядит так: студент правда писал работу сам, сидел ночами, сводил данные, правил главы, вставлял таблицы. Формально все честно. А потом комиссия задает простой вопрос: что показывает вот эта таблица? И человек зависает.
Обычно проблема даже не в том, что таблица чужая. Просто она давно стала декоративной. В студенческих работах есть опасная вера: если в тексте появились цифры, сравнение и подпись, значит, доказательство уже состоялось. Хотя таблица сама по себе ничего не доказывает. Она только хранит материал.
Смысл начинается там, где автор может по-человечески объяснить, зачем таблица стоит именно здесь, что в ней важно и какой вывод из нее вообще следует. Если этого нет, она превращается в мебель. Стоит посреди главы, занимает место, но не участвует в мысли.
Вот почему на защите так больно бьют простые вопросы. Не про космическую методологию, а про третий столбец, логику сравнения или связь таблицы с выводом. И тут внезапно выясняется, что студент может пересказать абзацы вокруг, но не может объяснить объект, который сам же принес как опору.
Это и есть неприятный вывод: сам написал еще не значит понял. Можно честно собрать текст и все равно не собрать доказательство. Особенно если таблицы добавляли в самом конце, когда мысль уже была написана, а подкрепление искали задним числом. Тогда у файла есть таблица, а у таблицы нет хозяина. И на защите такая мелочь вдруг становится не мелочью, а очень честной проверкой всей работы на обитаемость.
Многие ловятся на одной и той же мысли: если нашел готовую работу на похожую тему, значит половина пути уже пройдена. Есть структура, главы, выводы, список литературы. Кажется, осталось чуть подправить под себя и спокойно ехать дальше.
Проблема в том, что готовая работа помогает только в одном режиме: когда вы смотрите на нее как на маршрут, а не как на каркас для маскировки. Это и есть то самое одно решение, от которого все зависит.
Ловушка начинается в момент, когда человек пытается сохранить чужую форму. Меняет компанию, цифры, даты, пару формулировок, а потом обнаруживает, что его тема держится на других данных и другой логике. Вместо нормальной переработки начинается подгонка. Чужой расчет натягивают на свой объект, чужой вывод переписывают под свои слова, а текст держится на честном слове и нервной надежде, что пронесет.
Навигатор работает иначе. Вы смотрите не на чужие абзацы, а на порядок шагов: как автор поставил проблему, где ввел данные, как перешел к анализу, из чего вывел итог. После этого пример надо закрыть и писать уже свою работу, даже если она сначала получается кривее и суше.
Очень простой тест: если после чтения примера вы можете своими словами объяснить, почему глава устроена именно так, значит он вам помогает. Если же вы третий час переделываете "ООО Ромашка" в "ИП Василек" и пытаетесь спасти красивые чужие куски, вы уже не экономите время, а медленно строите себе проблему на защиту.
Поэтому готовая работа опасна не сама по себе. Опасна попытка проскочить на чужой форме без своей логики. Как маршрут пример полезен. Как костыль для быстрой сборки он почти всегда оборачивается ловушкой, и выясняется это обычно в тот момент, когда надо объяснить не текст, а причину, почему там вообще все устроено именно так.
История начинается вроде бы разумно. Человек не ищет кнопку "сдать без усилий", а берет пример, чтобы понять структуру, уровень и логику нормальной работы. Звучит честно. А потом открывает файл и понимает: в этом примере тоже надо разбираться почти с нуля.
Обычно покупают не просто текст, а надежду быстро снять неопределенность. Как должна выглядеть глава, где граница между слабо и нормально, насколько глубоко копать. То есть человеку нужен не файл сам по себе, а чужая точка опоры.
Но чужая опора без расшифровки почти бесполезна. Хороший пример не обязан быть понятным с первого чтения. В нем есть своя логика, переходы, допущения, контекст темы. Чтобы он начал работать, его нужно разобрать. И вот тут появляется раздражение: я же уже заплатил, почему снова надо думать?
Потому что пример может показать маршрут, но не может пройти его вместо вас. Когда его используют как карту, он полезен: видно, как автор связал главу с выводом, где усилил аргумент, как оформил спорный участок. Когда его используют как костыль, начинается каша. Чужая цель не совпадает с вашей, данные другие, масштаб другой, а красивый кусок в новой теме начинает звучать пусто.
Отсюда и неприятный вывод. Идея "купил пример, чтобы разобраться" сама по себе нормальная. Ненормальным становится ожидание, что вместе с файлом придет готовое понимание. Полезный образец может сэкономить часы блуждания, но ясность все равно собирается вручную. И если этого не сделать, человек злится не на плохой материал, а на то, что купить удалось только форму, а не смысл.
Времена, когда дипломная работа казалась бесконечным испытанием, постепенно уходят в прошлое. Хотите узнать, как упростить создание ВКР и вместо долгих месяцев мучений уложиться в несколько дней? Мы в редакции ggsel.net расскажем, как современные нейросети могут стать вашими верными помощниками в написании работы — буквально превратят рутину в продуктивный процесс.
Технологии меняют подход к учебе: от простого копирования к сотрудничеству с искусственным интеллектом
К 2026 году вузы все активнее внедряют передовые технологии — и это заметно меняет студенческую жизнь. Раньше многие искали, где раздобыть готовую работу, а теперь ИИ выступает в роли надежного ассистента, который всегда под рукой и готов помочь в любое время. Современные модели не ограничиваются простым созданием текста: они умеют выстраивать логичную структуру исследования, анализировать большие объемы данных и даже формулировать рабочие гипотезы.
Но давайте будем честны: написание ВКР — это по-прежнему непростой, многослойный процесс. Не стоит ждать, что нейросеть выдаст безупречный диплом, пока вы расслабляетесь с чашкой кофе. Ее роль — облегчить 80% трудоемких задач: помочь собрать список литературы, упорядочить мысли, набросать черновики разделов и оформить работу по всем правилам. Вам же останется самое важное: проверить все на достоверность, связать разрозненные части в единый связный текст и внести финальные правки.
При этом стоит учитывать: базовые версии популярных нейросетей (вроде ChatGPT) порой «теряют нить» при работе с объемными текстами. Для серьезных академических задач лучше использовать прокачанные, платные варианты нейронок.
Как написать дипломную работу с помощью нейросети: простая инструкция в 5 шагов
Хотите написать диплом с помощью нейросети, но боитесь, что получится «сухая» или несвязная работа? Секрет прост: не пытайтесь сгенерировать весь текст разом! Вместо этого разбейте задачу на маленькие кусочки — так вы получите качественный диплом, который пройдет проверку на уникальность и соответствие стандартам. На каждый раздел открывайте новый чат — так ИИ будет проще ориентироваться.
Думайте о нейросети как о мощном «конструкторе»: вы собираете работу по частям, тщательно прорабатывая каждый элемент. Разберем, как это сделать.
Первым делом разделите будущий диплом на 5–6 логически связанных разделов. Вместо того чтобы создавать один гигантский проект, лучше оформить отдельные «модули» для каждой части — так нейросеть лучше справится с деталями, а вам будет проще контролировать результат.
Вот примерный план:
Введение (отдельный блок).
Глава 1: Теоретические основы (при сложной теме разделите на 2 части).
Глава 2: Анализ и методология (здесь раскрывается основная исследовательская часть).
Глава 3: Рекомендации и предложения (практическая, проектная часть).
Заключение (итоговое подведение итогов).
Такой подход поможет избежать «воды» и сделает работу структурированной.
Начнем с «фундамента» — теоретической части. Вот что нужно сделать:
Откройте в нейросети новый чат и укажите тему первой главы.
Укажите ИИ, что вы пишите первую главу дипломной работы.
Попросите нейросеть сгенерировать черновой план.
Внимательно отредактируйте предложенные пункты: уберите лишнее, добавьте разделы, которые требуют методичка вашего вуза или научный руководитель.
Задайте объем текста (например, 20–25 страниц). Это «подскажет» нейросети, что нужно раскрыть тему подробно, с терминами и деталями, а не поверхностно.
Запустите генерацию — нейросеть выдаст структурированный текст, строго следуя вашему плану.
Это самая «живая» часть диплома — здесь нейросеть должна показать максимум конкретики.
Для Главы 2 (анализ):
Вручную пропишите в плане названия методов анализа, объекты исследования или компании, о которых нужно написать.
Убедитесь, что в плане есть разделы: текущее состояние проблемы, динамика показателей, выявление недостатков или противоречий.
Задайте объем — нейросеть сгенерирует детализированный анализ.
Для Главы 3 (рекомендации):
В плане укажите пункты, связанные с разработкой конкретных мероприятий или решений.
Обозначьте объем текста — нейросеть подробно опишет предложенные меры и объяснит, почему они эффективны.
Чем четче сформулированы задачи, тем конкретнее и полезнее будет результат.
Эти части требуют особого внимания — их лучше создавать, когда основная часть диплома уже готова.
Введение:
Создайте отдельный блок.
Убедитесь, что в плане есть обязательные элементы: актуальность темы, цель, задачи, объект и предмет исследования.
Используйте возможности нейросети, чтобы получить «академический» стиль, характерный для вводных разделов.
Заключение:
Задайте небольшой объем (3–5 страниц).
Нейросеть сформирует итоговые выводы, опираясь на тему работы.
Результат будет звучать логично и весомо — идеально для завершения исследования.
На этом этапе у вас уже есть 5 готовых, отредактированных разделов. Осталось:
Объединить их в один документ (например, в Word).
Проверить сквозную нумерацию.
Оформить титульный лист по требованиям вашего вуза.
Благодаря тому, что вы заранее продумали структуру и объем каждой части, итоговая работа будет сбалансированной, без повторов, логически связной и соответствующей требованиям нормоконтроля.
Какие нейросети помогут в написании дипломной работы: обзор актуальных моделей 2026 года
Грамотно формулировать запросы, а потом тщательно проверять факты нужно со всеми нейросетями. Но у каждой есть свои сильные и слабые стороны. Одни модели классно генерируют текст, который сложно отличить от человеческого, другие — отлично справляются с анализом литературы.
Разберем самые актуальные версии нейросетей на 2026 год и подскажем, какая из них подойдет именно вам для решения конкретных задач в дипломе.
ChatGPT 5.5 (OpenAI)
Это, пожалуй, самая популярная нейросеть на рынке. В версии 5.5 модель заметно подтянула навыки логического анализа — теперь она отлично справляется с задачами, где нужно выстроить аргументированные рассуждения.
Если вам нужно разработать теоретическое обоснование для диплома, построить сложные гипотезы или скомпилировать информацию из нескольких источников (просто загрузите в модель учебники, и она соберет все в связное целое), то ChatGPT 5.5 станет надежным помощником.
Понимает контекст. Может изучить методички и постараться (хотя и не всегда идеально) придерживаться заданной структуры.
Аргументирует и выстраивает логику. Особенно пригодится для раздела «Постановка проблемы» — нейросеть поможет четко сформулировать противоречия и обосновать актуальность темы.
Быстро генерирует большие объемы текста. Отлично подойдет для написания теоретических глав.
Создает черновики для защитной речи. Получится база, которую останется лишь доработать.
Иногда «выдумывает» факты. Если не указать четкие источники, модель может сгенерировать «ложную» информацию или сослаться на несуществующие книги.
Стиль текста выдает машинное происхождение. Текст получается слишком «гладким», перегруженным вводными конструкциями — придется серьезно править.
Не всегда соблюдает ГОСТы в оформлении ссылок. После генерации придется вручную корректировать форматирование.
Может «упираться» и требовать постоянных уточнений. Порой отказывается писать большие фрагменты за один заход.
Коротко: ChatGPT 5.5 — мощный инструмент, но требует тщательной доработки. Используйте его, чтобы сгенерировать костяк глав, идеи и аргументы, но будьте готовы потратить время на редактирование и проверку фактов.
Gemini 3.5 (Google)
Google серьезно прокачал Gemini 3.5 — теперь это мультимодальная нейросеть с тесной интеграцией в экосистему Google. Ее фишка — умение работать с разными форматами данных и прямой доступ к научной базе через Google Scholar. Это особенно удобно, если вам нужно собрать актуальные данные для введения или проанализировать свежие диаграммы.
Находит свежие материалы. Легко подтягивает статьи, отчеты и статистику за 2024–2026 годы — идеально, чтобы показать актуальность темы.
Анализирует изображения. Загрузите скриншот графика — нейросеть опишет его и поможет оформить в раздел работы.
Умеет обрабатывать много информации. Можно загрузить десяток PDF-файлов с источниками, и модель проанализирует их, выделив ключевые моменты.
Хорошо «схватывает» междисциплинарные запросы. Например, если ваша тема на стыке экономики и IT, Gemini справится лучше многих аналогов.
Строгие этические фильтры. Может отказаться генерировать текст на острые социальные или политические темы.
Иногда теряет нить в длинных диалогах. При написании объемных разделов возможны «провалы» в логике.
Сгенерированный код требует доработки. Если пишете технический диплом, готовьтесь проверять и править код.
Интерфейс может быть перегружен. Из-за интеграции с поиском Google иногда сложно отделить полезную информацию от лишнего.
Коротко: Gemini 3.5 — отличный выбор, если ваша работа требует свежих данных, анализа графиков или междисциплинарного подхода. Но для написания длинного связного текста (например, основной части диплома) она может оказаться менее стабильной, чем другие решения.
Claude Opus (Anthropic)
Эта модель умеет создавать грамотные, литературные тексты, четко следуя вашим инструкциям, без лишних отступлений. Она пишет лаконично, избегает «воды» и умеет имитировать научный стиль без излишнего официоза. Сгенерируйте текст, неотличимый от человеческого.
Генерирует текст, который почти не требует стилистической правки — он выглядит очень «человечным».
Обрабатывает огромные объемы информации: загрузите всю собранную литературу, и модель напишет главу, строго опираясь на эти источники.
Эффективно повышает уникальность текста — незаменимо, если нужно перефразировать материал.
Адаптируется под заданный стиль: попросите написать как профессор или аспирант — модель подстроится под нужный тон.
Генерирует текст медленнее, чем конкуренты.
Подписка дорогая, а в бесплатной версии жесткие лимиты.
Иногда «уходит в осторожность»: избегает конкретных выводов, чтобы не ошибиться.
Не так сильна в математических расчетах, как GPT.
Коротко: идеален для студентов гуманитарных направлений. Поможет оформить литературный обзор или заключение — текст получится уникальным и грамотно написанным.
Perplexity
Гибрид поисковика и нейросети. Его главная фишка — работа с источниками: в отличие от других моделей, он ищет реальные статьи и добавляет к ним корректные ссылки. Это настоящая находка, когда нужно собрать библиографический список или проверить достоверность фактов.
Автоматически подбирает проверенные источники и оформляет ссылки — никаких выдуманных авторов!
Создает текст, опираясь только на достоверные данные, минимизируя «ошибки воображения».
Помогает быстро разобраться в новой теме — экономит время на погружение.
Имеет специальный режим Academic для удобного поиска научных публикаций.
Пишет короткими фрагментами — создать полноценную главу целиком не получится.
Результат часто напоминает реферат или подборку фактов, а не глубокий авторский анализ.
Слабо ищет русскоязычные узкоспециализированные источники (сильнее ориентирован на английский язык).
Коротко: используйте Perplexity на этапе сбора материала и проверки фактов. С его помощью легко собрать базу для диплома, но написать работу целиком скорее всего не выйдет.
YandexGPT 5.1 Pro
Российская нейросеть, которая отлично «знает» отечественные реалии. Если ваша тема связана с российским законодательством, историей, филологией или экономикой, зарубежные модели могут «спотыкаться» на местных законах или культурных нюансах. А вот YandexGPT уверенно ориентируется в российских реалиях — от Пушкина до 44-ФЗ.
Глубоко разбирается в российском культурном и правовом контексте.
Пишет на русском языке естественно, без явных заимствований из английского.
Легко доступна: не требует смены IP-адреса или сложных способов оплаты.
Хорошо резюмирует информацию — пригодится для написания заключения.
Сложнее справляется с задачами, требующими сложных логических цепочек, чем GPT-5 или Claude.
Ограничено «поле зрения»: в длинных диалогах может «забывать» предыдущие сообщения.
Порой выбирает слишком осторожные формулировки, что снижает яркость текста.
Коротко: отличный выбор для тем, связанных с Россией. Особенно пригодится в юриспруденции, госуправлении и других областях, где важно разбираться в местных реалиях.
Grok 4 (xAI)
Разработка от команды Илона Маска. Ее особенность — доступ к данным соцсети X (Twitter) в реальном времени и отсутствие жесткой цензуры. Если пишете про современные медиа, интернет-социологию или политические тренды, Grok может подкинуть свежие идеи и актуальные факты.
Быстро подтягивает самую свежую информацию и тренды из соцсетей.
Стиль ответов менее формальный, без излишней «политкорректности».
Не боится касаться спорных тем, которые другие нейросети обходят стороной.
Предлагает оригинальные аналитические мысли о социальных явлениях.
Иногда пишет слишком разговорно или саркастично — для академического текста придется серьезно редактировать.
Качество ответов на сложные научные темы нестабильно.
С трудом справляется с академическим русским языком, особенно в сложных темах.
Коротко: специфический инструмент, который подойдет для креативных работ по социологии или медиа. Но для классических технических или гуманитарных дипломов лучше выбрать другую модель.
Разбиваем ВКР на блоки: что генерировать в каждом разделе
Это фундамент работы — именно его первым делом изучает ваш научный руководитель. Здесь вы закладываете основу всего исследования: объясняете, зачем работа нужна, что будете изучать и как.
Актуальность.
Пример запроса: «Объясни, почему тема „Экологичные материалы в строительстве“ актуальна для России в 2026 году — учитывай текущие государственные программы и рыночные тренды».
Задача: показать, что тема не просто «интересная», а востребована сегодня.
Цель и задачи.
Пример запроса: «Сформулируй одну четкую цель для работы по теме „Развитие онлайн-образования в регионах“. Затем придумай 5–6 конкретных задач, которые помогут достичь этой цели».
Задача: выстроить логическую цепочку: от глобальной цели к конкретным шагам.
Объект и предмет исследования.
Пример запроса: «Определи объект и предмет исследования для темы „Влияние социальных сетей на покупательское поведение молодежи“».
Задача: четко разграничить, что изучаете (объект) и какие аспекты этого объекта анализируете (предмет).
Методы исследования.
Пример запроса: «Перечисли, какие методы научного анализа (например, сравнительный анализ, статистическая обработка) были использованы в работе по теме „Эффективность маркетинговых кампаний“».
Задача: продемонстрировать, как вы добывали и обрабатывали информацию.
Обычно состоит из 2–3 глав: теоретической, аналитической и практической (или проектной). Разберем каждую.
Задача: доказать, что вы изучили работы ведущих экспертов в теме. Не просто скопируйте чужие идеи — покажите, что умеете их сравнивать, систематизировать и делать выводы.
Совет по работе с ИИ: задавайте запросы, которые требуют анализа, а не простого пересказа.
Пример: «Сравни, как [Автор 1], [Автор 2] и [Автор 3] трактуют понятие „цифровая трансформация бизнеса“. Выдели ключевые различия в их подходах и сформулируй собственное определение, опираясь на их работы».
Задача: описать текущее состояние объекта исследования. Например, проанализировать финансовые показатели компании, изучить рынок или выявить проблемы в отрасли.
Совет по работе с ИИ: нейросети (например, Gemini 3 или Perplexity) умеют находить свежие данные, но вам нужно грамотно их структурировать.
Пример: «На основе данных за 2023–2026 годы проведи SWOT-анализ компании X. Сформируй 5 ключевых выводов и предложи, как их можно визуализировать (например, в виде диаграммы)».
Задача: предложить конкретное решение — разработать модель, алгоритм, программу или дать рекомендации.
Совет по работе с ИИ: выбирайте модели, подходящие для ваших задач (например, Claude Sonnet для кода, ChatGPT — для структурированных советов).
Пример: «Составь раздел „Экономическое обоснование внедрения CRM-системы“ для компании с годовым оборотом 500 млн рублей. Рассчитай срок окупаемости и оформи результаты в виде таблицы».
Это не просто сводка выводов — самостоятельный раздел, где вы демонстрируете, что достигли поставленной цели.
Задача: последовательно ответить на каждую задачу, сформулированную во Введении. Начните с подтверждения (или опровержения) основной цели, затем разберите задачи по порядку.
Пример запроса: «Напиши заключение для ВКР. Сначала сформулируй, достигнута ли цель работы. Затем перечисли выводы по каждой из 5 задач, сформулированных во Введении. В конце сделай общий вывод о результатах исследования».
Как проверить работу нейросети и повысить уникальность
Даже самые продвинутые модели иногда ошибаются — ваша задача убедиться, что ВКР пройдет проверку на плагиат и достоверность. Разберем, как это сделать.
Нейросети порой выдают ложные данные, особенно универсальные модели. Вот что делать:
Проверяйте источники. Если ИИ указал книгу 2024 года, но не привел точные данные (автор, издательство, страницы) — найдите ее самостоятельно. Если такой книги не существует, уберите этот фрагмент.
Следите за терминологией. В узкоспециализированных темах (например, финансовый менеджмент или вычислительная техника) нейросеть может заменять профессиональные термины общеупотребительными. Замените их на корректные, принятые в вашей области.
Чтобы получить текст с высокой оригинальностью, формулируйте запросы так, чтобы ИИ анализировал, а не просто компилировал информацию.
Плохо (низкая уникальность): «Расскажи о развитии интернета».
Почему: общий запрос, ИИ выдаст стандартный текст, который, скорее всего, уже где-то опубликован.
Хорошо (высокая уникальность): «Проанализируй, как технологии Web 3.0 повлияют на рынок образовательных платформ в 2025–2026 годах. Сопоставь прогнозы с текущими трендами в сфере онлайн-обучения».
Почему: фокус на свежих данных и специфическом контексте повышает оригинальность.
Многие модели пишут в разговорном стиле, а для ВКР нужен строгий академический язык. Даже если вы укажите стиль письма заранее, нейросеть может от него отойти.
Убираем: «Я считаю», «На мой взгляд», «Безусловно», «Легко заметить».
Добавляем: «Можно сделать вывод, что…», «Анализ показывает…», «Исходя из полученных данных…».
Пример промта:
«Перепиши этот абзац в строгом научном стиле, избегая личных местоимений: [вставить текст]».
Итог
Используя нейросеть как помощника — а не замену собственному анализу — вы создадите качественную ВКР, которая пройдет и нормоконтроль, и проверку на уникальность. Главное — грамотно формулировать запросы, тщательно проверять факты и адаптировать текст под требования вашего вуза. Удачи с дипломом!
Переходите на ggsel.net — торговую площадку, где вы найдете игры для ПК и консолей, DLC, сможете пополнить баланс популярных игровых и неигровых сервисов, купить и продать игровой аккаунт. И все это — по низким ценам!