Всем привет, это я, VALHAISTO GAMES! Я знаю что здесь меня абсолютно никто не знает, наверное даже не слышали. Хотел бы рассказать про свой GameDev как инди-разработчик. Студией свою команду сложно назвать, потому что я всего лишь один создаю игры и приложения (если что инди-разработчик это и есть 1 человек или максимум две энтузиаста). Игры и приложения я не прям успеваю делать, да и обновления выкачивать тоже, но сейчас на сегодняшнее время проекты у меня такие:
Из игр: MiSide: Universe, MiSide: Erased, MiSide: Error, MewSim: First Love
Из приложений: MiFab – MiSide 3D Models Hub, BLINDER – 3D Models App
Современный Frontend давно перестал быть слоем поверх API. В реальном продукте он решает те же вопросы, что и любая распределённая система: где живут данные, когда они считаются свежими, как пережить задержку сети, что показать при частичном отказе, где провести границу между сервером и клиентом, как не превратить локальное состояние в теневую базу данных.
Проблема в том, что мы всё ещё говорим о Frontend языком интерфейса, хотя строим уже не интерфейс. Мы строим систему доставки смысла пользователю.
Классическая схема была понятной. Сервер собирает страницу, браузер показывает HTML, пользователь кликает ссылку, сервер отдаёт новую страницу. Почти вся сложность жила на сервере: маршруты, права, данные, шаблоны, ошибки.
Потом интерфейсы стали богаче, и мы перенесли часть логики в браузер. Страница перестала быть документом и стала приложением. Браузер начал хранить состояние, валидировать формы, строить маршруты, кэшировать данные, оптимистично обновлять UI. Это дало скорость и интерактивность - и заодно растащило Frontend по нескольким слоям.
Часть живёт на сервере: рендеринг, подготовка данных, проверка прав. Часть - в браузере: интерактивность, ввод, мгновенная обратная связь. Часть - в кэше: CDN, query cache, prefetch, service worker. А часть вообще не выглядит как Frontend: она в контракте API, в схеме данных, в дизайн-системе, в правилах релиза.
Когда всё работает, пользователь видит простую вещь: страница открылась, кнопка нажалась, действие сохранилось. Когда ломается, выясняется, что «кнопка» была последним звеном в длинной цепочке решений.
Кнопка не просто вызывает onClick. Она может запускать optimistic update, инвалидировать кэш, отправлять событие аналитики, менять URL, зависеть от прав пользователя, показывать pending-состояние, откатывать UI после ошибки или повторять запрос.
Это уже не «покрасить кнопку». Это проектирование поведения системы в условиях неопределённости.
Ernest Peixotto (American, 1869–1940)
Компоненты не спасают архитектуру
Когда Frontend стал сложнее, мы нашли удобный ответ - компонентную модель. Разбей интерфейс на части, переиспользуй их, собери экран из маленьких элементов. Сильная идея, но без неё современные интерфейсы было бы трудно поддерживать.
Но компонентная модель хорошо описывает форму интерфейса и плохо описывает поведение продукта. Компонент может быть маленьким, типизированным и красивым, а архитектура всё равно слабой, потому что настоящая сложность живёт между компонентами.
Самая частая ошибка - смешать UI-состояние, серверные данные, процесс сохранения, ошибки и производные значения в одном месте. Тогда форма знает про API, кнопка - про бизнес-правила, таблица - про инвалидирование кэша, а страница хранит копию данных из query cache «на всякий случай». Дальше начинаются исключения, быстрые фиксы, дублирование, страх менять экран и фраза «проще переписать».
Redux, Zustand, React Query, SWR, Signals, Context - ни один инструмент не решит за команду главный вопрос: где источник правды.
Если правда на сервере, Frontend должен уважать сервер и не показывать пользователю фантомное состояние. Если правда в пользовательском вводе, нельзя терять его после refetch. Если правда в URL, состояние должно переживать перезагрузку и передаваться ссылкой. Плохая архитектура начинается там, где источник не выбран: сервер говорит одно, кэш помнит другое, форма хранит третье, URL показывает четвёртое, а компонент делает пятое, потому что «так быстрее».
Near Richmond, Yorkshire (1877)
Где должна жить логика
Главный вопрос: кто за что отвечает, и что произойдёт, когда что-то пойдёт не так.
Возьмём простой сценарий - пользователь переименовывает проект.
Слабая версия: Пользователь жмёт «Сохранить». Форма отправляет PATCH, показывает спиннер. Через 800 мс ответ приходит, спиннер исчезает, имя в форме обновляется. Хорошо. Но в сайдбаре имя меняется ещё через секунду, потому что список проектов перезапрашивается отдельно. А в соседней вкладке, открытой час назад, имя вообще старое. Пользователь видит три разных состояния одной сущности и не понимает, какому верить.
Сильная версия: То же действие. Имя в инпуте меняется мгновенно - здесь источник правды сам пользователь. После сабмита UI сразу показывает новое имя во всех местах: в сайдбаре, в заголовке, в хлебных крошках, но визуально помечает его как ещё не сохранённое (например, приглушённым цветом). Если сервер подтвердил, тогда пометка исчезает. Если вернул ошибку - UI откатывается к старому имени и показывает причину человеческим языком: «нет прав» или «имя уже занято». Список проектов в кэше обновляется по одному правилу, а не по совпадению.
Из этого вытекает несколько практических правил.
Источник правды - один на каждое значение. Если правда на сервере, Frontend читает её оттуда и не хранит копий «на всякий случай». Если правда в URL - фильтры, поиск, выбранная вкладка, она переживает перезагрузку и передаётся ссылкой. Если правда во вводе пользователя, её нельзя потерять при refetch. Дублирование источников - это не ускорение, это будущий баг.
Frontend не решает то, за что не отвечает. Он может скрыть кнопку под роль пользователя, но не должен сам определять, разрешено ли действие. Это решает сервер. Frontend может показать бизнес-правило и объяснить его, но само правило живёт в домене, а не в компоненте. Если правило про деньги, права или статусы случайно осело в JSX, его рано или поздно нарушат.
Кэш это договор, а не оптимизация. Когда мы держим данные в query cache, мы говорим пользователю: «верь этому, пока я не скажу обратное». У договора должны быть условия: сколько данным можно верить, кто их обновляет, когда инвалидировать, что показывать, если они устарели. Быстрый интерфейс не должен быстро врать.
Производительность и ошибки
Производительность часто сводят к Lighthouse, Core Web Vitals и размеру бандла. Метрики полезны, но не объясняют главного.
Пользователь не обязан ждать. Медленный Frontend почти всегда - сумма решений: слишком много клиентского кода, тяжёлая дизайн-система, водопад запросов, дорогой рендер, небрежная гидратация. Это нельзя починить в конце. Это проектируется в начале: что отдать с сервера, что загрузить заранее, что отложить, какой экран остаётся полезным при частичном отказе.
С ошибками то же самое. В продакшене сеть медленная, API отвечает не сразу, сессия истекает, пользователь кликает быстро, данные меняются в другой вкладке. Ошибка валидации должна жить рядом с формой. Ошибка прав - приходить от сервера. Ошибка сети - объяснять, можно ли повторить действие. Ошибка бизнес-правила должно быть написана по-человечески: не «400 Bad Request», а «Нельзя удалить проект, пока в нём есть активные задачи».
Надёжность Frontend - это не отсутствие ошибок в консоли. Это способность интерфейса вести себя предсказуемо, когда мир вокруг неидеален.
A Winter Scene (mid 1640s)
Что отличает сильного Frontend-инженера
Не количество выученных хуков и не скорость написания компонентов. Он понимает границы: где заканчивается серверное состояние и начинается клиентское, где данные можно кэшировать, где нужна мгновенная реакция, а где честный loading, где типы помогают, а где нужна runtime-проверка, где абстракция снижает стоимость изменений, а где делает код мутным.
Он проектирует не только компоненты, но и договоры: между клиентом и сервером, между страницей и компонентом, между системой и пользователем.
Плохая архитектура почти всегда выглядит нормально в первый месяц. Потом она начинает требовать всё больше энергии за всё меньший результат. Переписывать приходится не потому, что React плохой или Vue плохой. Чаще всего в начале никто не ответил на скучные вопросы: что является источником правды, какие данные могут устареть, что пользователь увидит при медленной сети, что произойдёт, если запрос выполнится дважды, какая логика принадлежит домену, а какая - интерфейсу.
Заключение
Frontend больше не тонкая оболочка вокруг API. Он стал местом, где техническая архитектура встречается с человеческим ожиданием. Пользователь не видит server components, query cache, hydration и source of truth. Он видит другое: страница открылась или нет, действие сохранилось или потерялось, ошибка объяснена или спрятана, интерфейс помогает или заставляет сомневаться.
Frontend - это слой доверия. Он отвечает за договор между человеком и системой: нажал - увидел реакцию, сохранил - понял результат, ошибся - понял, как исправить, вернулся - попал туда, где ожидал быть. Хорошая архитектура не убирает сложность. Она кладёт её туда, где её можно понять.
Этой вводной статьёй я хотел поделиться мыслями и начать этот блог. Всем спокойных релизов и поменьше багов в продакшене ❤
Привет, Пикабу! Сегодня хочу поделиться своим опытом в разработке кастомных игр для Dota 2. Если вы когда-нибудь пробовали писать свои режимы, то знаете, что стандартный путь — это Lua и VScripts. Но что, если я скажу, что можно использовать всю мощь C#, сохраняя при этом совместимость с движком игры?
Да, это про «костыли», но очень изящные. Мы будем использовать проект CSharp.lua, который превращает ваш C# код в читаемый Lua, работающий внутри «песочницы» Доты.
Зачем это нужно?
Lua — это круто для быстрых набросков, но когда проект разрастается, начинаются проблемы:
Отсутствие строгой типизации (ошибки в именах переменных вылетают только в рантайме).
Скудный инструментарий для работы с коллекциями.
Никакого LINQ, нормальных интерфейсов и современных фишек языка.
C# дает нам Roslyn, типизацию и возможность писать чистый, поддерживаемый код.
1. Как это работает?
Магия строится на двух столпах:
CSharp.lua — компилятор, который не просто переводит синтаксис, но и тянет за собой CoreSystem.lua (эмуляция .NET типов: List, Dictionary, Delegates и т.д.).
VScript API — родной API Доты, к которому мы будем обращаться через extern методы.
Важный нюанс: Дота использует обрезанный Lua 5.1. У нас нет доступа к файловой системе (io), библиотеке debug и многим функциям os. Поэтому придется немного «подшаманить».
2. Готовим окружение
Нам понадобятся:
.NET SDK 7.0+.
Сам компилятор CSharp.lua.
Dota 2 Workshop Tools.
Структура проекта обычно выглядит так: в папке src пишем на C#, а в output получаем готовый out.lua, который закидываем в папку аддона.
3. Патчим CoreSystem (Борьба с песочницей)
Так как Valve ограничили os.time и os.clock, стандартный DateTime в C# может «уронить» ваш аддон. Нужно залезть в файлы библиотеки CoreSystem.lua и обернуть вызовы в проверки.
И самое важное: в Core.lua нужно закомментировать assert, который запрещает переопределение классов. В Доте это нужно для работы script_reload (горячая перезагрузка кода без перезапуска игры).
4. Пишем код: Точка входа
Чтобы Дота поняла, что наш код существует, создаем EntryPoint.cs. Здесь мы связываем методы C# с глобальными функциями Lua.
5. Как работать с API Доты?
Чтобы не писать обертки на каждый чих, используем шаблоны. Это позволяет вызывать любые методы VScript API напрямую.
-p: Отключает debug.setmetatable (в Доте он запрещен).
-include: Собирает всё в один файл out.lua.
В самой игре в консоли пишем script_reload — и вуаля, ваша логика на C# работает!
Итог
Да, порог входа чуть выше, чем у обычного Lua-скриптинга. Но для сложных проектов с кучей кастомных механик, способностей и систем — это спасение. Вы получаете автодополнение, поиск ссылок, рефакторинг и нормальную структуру кода.
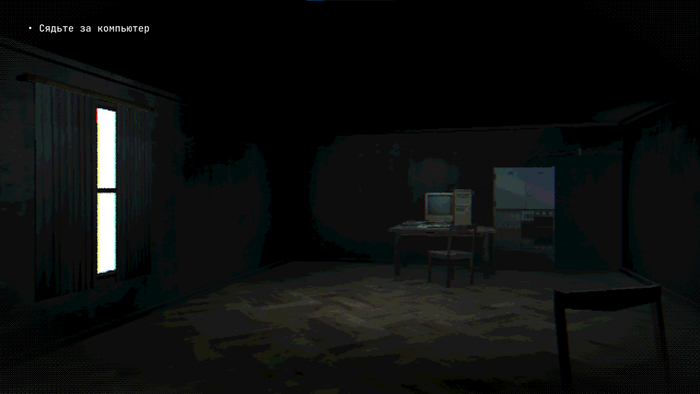
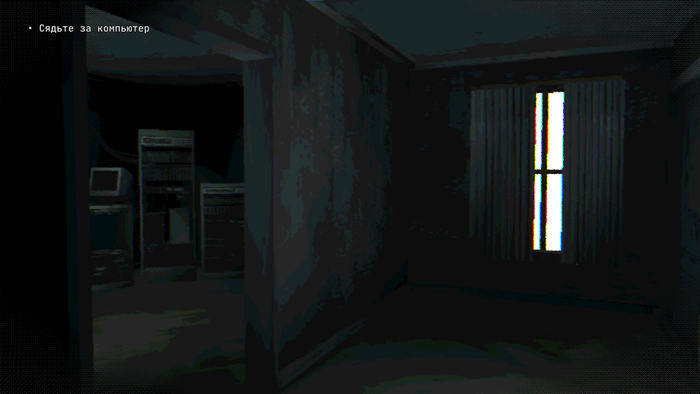
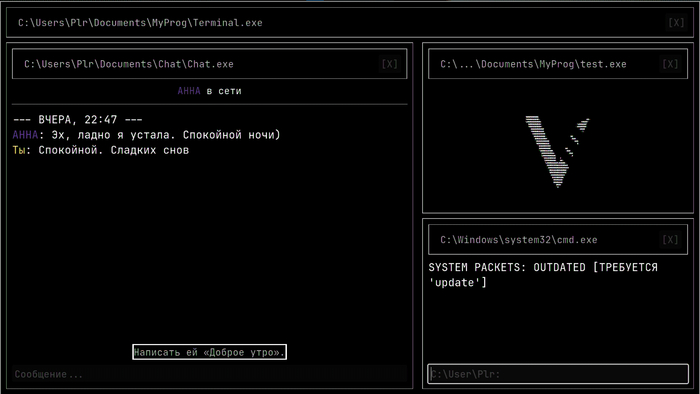
Всегда хотел сделать игру и вот решился. Игра простенькая. Визуальная новелла с двумя концовками. Она рассказывает о эмоциональной зависимости. В ней вам придётся чинить сервер и поддерживать диалог с АННОЙ Вот так выглядит игра:
1/3
Ребят, у меня пока 0 опыта. Мне очень важно ваше мнение. Пожалуйста, поиграйте 5 минут и скажите честно: что плохо? Где баги? Я хочу учиться и делать лучше, поэтому любая критика для меня на вес золота. Заранее спасибо :3
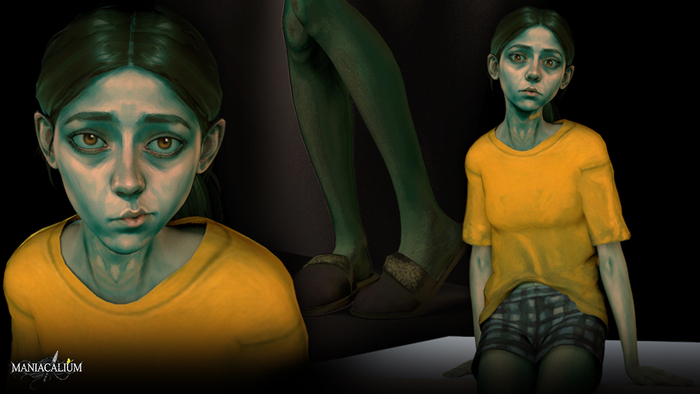
Закончил работу над главной героиней своей игры. В кратце хочу пояснить о чем будет история.
Мы оказываемся в роли девочки подростка в пост советском сеттинге. Главную героиню преследуют проблемы в семье, в школе, и в принципе, её жизнь сплошная неудача. На фоне всего этого девочка закрывается в себе и в один момент её психика даёт сбой.
Кому интересен проект, можете перейти в мой тг канал по игре:
Всем привет! Меня зовут Паша и возможно вы уже пользуетесь моим расширением Ave blacklist для блокировки продавцов спамеров на авито. Но сегодня не об этом.
Больше года назад Кабинет министров не поддержал законопроект с ценой за килограмм или литр, новость была на Пикабу в том числе
Что ж, Кабинет министров не поддержал, а я поддерживаю двумя руками!
И написал расширение для браузеров для расчета цена за единицу измерения на сайтах доставок еды - заКило (chrome, firefox)
Мог бы научить и в офлайн магазинах цену за единицу измерения считать, но кто бы меня спрашивал :D
Маркетинговые фишки для запутывания потребителей
Для чего нужно смотреть цену именно за единицу измерения? Сейчас я расскажу пару маркетинговых трюков, которые манипулируют человеком, заставляя делать неверные выводы. А я за осознанный и рациональный выбор.
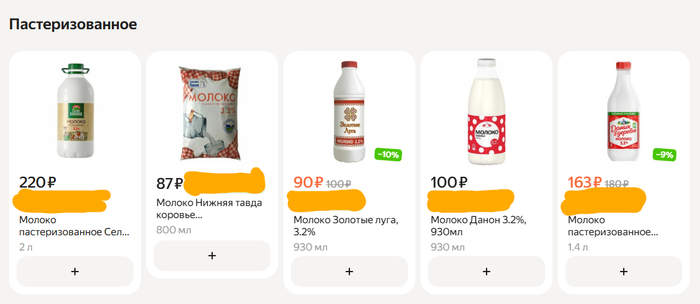
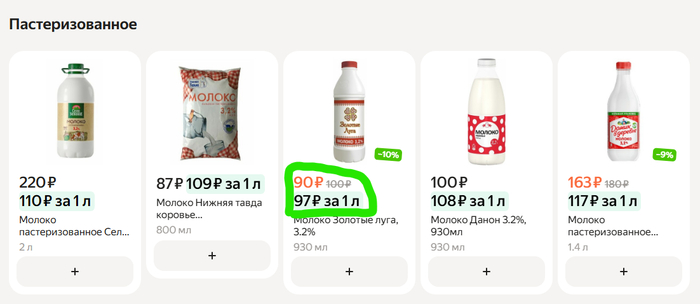
1) Неравные объёмы. Оооо, эта тема сильно развита в молочке. Как думаете, что выгодней купить 800 мл, 930 мл, 1.4 литра и 2 литра молока? Следующие изображения как раз об этом:
Как думаете, какое предложение самое выгодное?
а вот и победитель!
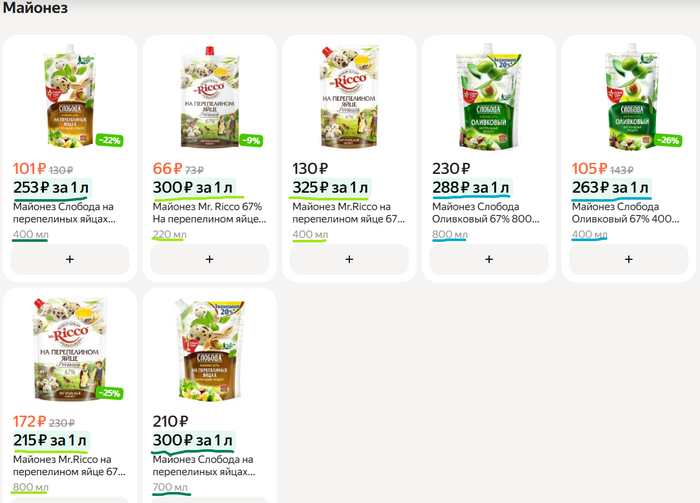
2) Оптовый эффект. Кажется, что большая упаковка должна быть выгодней. Но это не всегда работает. В результате потребитель может купить больше товара по невыгодной цене, получается такой двойной урон по кошельку.
Слобода (на перепелиных яйцах) самое выгодное предложение 400 мл (253 рубля/литр против 300 в фасовке 700 мл), Слобода Оливковый 400 мл (263 рублей/литр против 288 в фасовке 800 мл), у ricco самая выгодная фасовка самая большая 215 рублей/литр
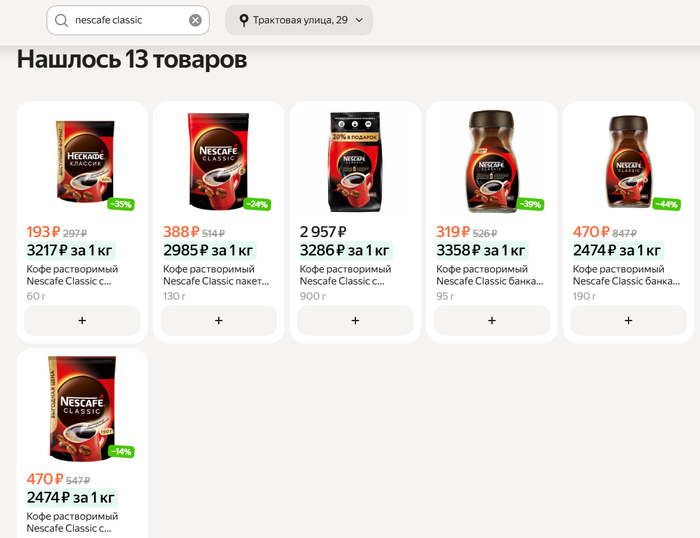
3) Промо-упаковки. «+10 % бесплатно» на пачке чипсов или кофе — итоговая стоимость за грамм остаётся скрытой
То самое чувство, когда кофе с 20% от объема в качестве подарка выходит дороже, чем без подарка ;)
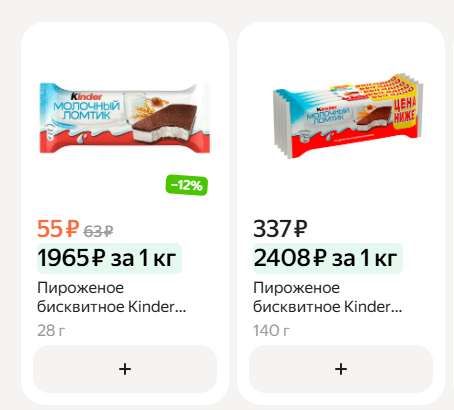
4) Акционные блоки. Товар в «специальной акции» может стоить дороже аналога без акции, если не считать граммы и миллилитры.
Если написано, что цена ниже, значит это наверное правда? Да, ведь? По секрету скажу - даже без скидки Молочный ломтик цена ниже за 1 штуку, чем за упаковку 5 штук (2250 рублей/кг)
Как заКило закрывает пробел
Пока законопроект о единых юнит-прайсах пылится в кабинетах, заКило берёт на себя всю работу по подсчёту цены за килограмм или литр — прямо в вашем браузере. Расширение автоматически считывает вес и объём товара из страницы, делает все вычисления локально и выводит рядом с привычной ценой понятную метку «₽/кг» или «₽/л».
— Никаких ручных калькуляций: вам не нужно помнить формулы и перебирать варианты — всё готово в один клик.
— Единообразный интерфейс: заКило выводит юнит-прайс в одном и том же месте и в одном стиле на всех поддерживаемых сайтах, избавляя от необходимости искать мелкие надписи.
— Реальная экономия: сразу видно, какая фасовка выгоднее, и не придётся переплачивать за «промо-упаковки» или странные объёмы.
— Простая интеграция: расширение уже работает на крупнейших сервисах доставки продуктов (Ашан, Яндекс.Маркет, Перекрёсток, Пятёрочка и др.) — достаточно установить и сравнивать.
ЗаКило закрывает пробел между законодателями и реальными покупателями, переводя борьбу за честную цену на практический уровень
Как можно помочь?
1) Предложить свою идею для доработки расширения - это я всегда строго приветствую
2) Помочь с дизайном - на некоторых сайтах какое то обилие цифр и текста и при добавлении цены за кг смотреть, на мой взгляд, становится сложно. Круто было бы разработать какой-нибудь универсальный макет для отображение цены и цена за единицу, чтобы было проще сравнивать товары, а также проще интегрировать расширение на новые сайты
3) Сейчас расширение показывает цену за ту единицу, которая указана на сайте - если литры, то за 1 литр, если килограммы, то за 1 кг. Но в некоторых категориях (молоко, например) какие-то товары показываются в мл, какие то в граммах. И сравнивать тоже не совсем корректно граммы с мл из-за плотности молока. Тут мне нужна помощь с тем, в каких категориях есть еще такое не соответствие. Про молоко я себе уже внес задачку, но про другие категории могу лишь догадываться
Я работаю с PyQt6 и в функции retranslateUi нужно передать num, которая содержит переносы строк и если ее вывести через принт то получается аккуратная таблица. а когда эта функция передает текст окну , в котором он должен быть, то текст выводится в одну строку.
Хз, может быть кто то знает как исправить, добавить <br> пробовал, ничего не вышло. Помогите плиз а то голова уже не варит
В мире программирования чит-листы — это секретное оружие каждого разработчика. От новичков до опытных программистов, эти чит-листы помогают быстро найти нужную информацию и повысить продуктивность. Сегодня я собрал для вас лучший набор чит-листов по различным языкам программирования и инструментам, от Python до Docker. Обязательно сохраняйте в закладки!
1. Python
Python — это высокоуровневый язык программирования, который широко используется для различных приложений. В этом чит-листе собраны основные синтаксические конструкции, структуры данных и популярные библиотеки Python. Python чит-лист
2. Git
Git — это самая популярная система управления версиями на данный момент. Этот чит-лист поможет вам легко справляться с коммитами кода, управлением ветками и разрешением конфликтов. Git чит-лист
3. JavaScript
JavaScript — это основной язык фронтенд-разработки. В этом чит-листе собраны основные синтаксические конструкции, работа с DOM и часто используемые функции JavaScript. JavaScript чит-лист
4. Bash
Bash — это стандартный командный интерпретатор для систем Linux и Unix. В этом чит-листе собраны основные команды Bash и советы по написанию скриптов. Bash чит-лист
5. SQL
SQL — это стандартный язык для управления и работы с реляционными базами данных. В этом чит-листе собраны основные SQL-запросы, манипуляции данными и команды управления базами данных. SQL чит-лист
6. HTML
HTML — это основной язык для создания веб-страниц. В этом чит-листе собраны основные теги HTML, атрибуты и структура. HTML чит-лист
7. CSS
CSS используется для управления стилем и макетом веб-страниц. В этом чит-листе собраны основные селекторы CSS, атрибуты и советы по макету. CSS чит-лист
8. Sass
Sass — это препроцессор CSS, который предоставляет более мощные функции и лаконичный синтаксис. В этом чит-листе собраны основные конструкции и функции Sass. Sass чит-лист
9. Tailwind
Tailwind — это утилитарный CSS-фреймворк, предлагающий множество предопределенных классов. Этот чит-лист поможет вам быстро найти нужные классы Tailwind. Tailwind чит-лист
10. React.js
React.js — это библиотека JavaScript для создания пользовательских интерфейсов. В этом чит-листе собраны основные концепции React, компоненты и часто используемые API. React.js чит-лист
11. Angular
Angular — это фреймворк для создания динамических веб-приложений. В этом чит-листе собраны основные концепции Angular, директивы и сервисы. Angular чит-лист
12. Vim
Vim — это высоконастраиваемый текстовый редактор, любимый многими разработчиками. В этом чит-листе собраны основные команды Vim и горячие клавиши. Vim чит-лист
13. Linux
Linux — это операционная система с открытым исходным кодом, широко используемая на серверах и в средах разработки. В этом чит-листе собраны основные команды Linux и советы по работе с системой. Linux чит-лист
14. Docker
Docker — это контейнерная технология, упрощающая развертывание и управление приложениями. В этом чит-листе собраны основные команды и операции Docker. Docker чит-лист
Надеюсь, эти чит-листы помогут вам на вашем пути в программировании. Если у вас есть другие рекомендации по чит-листам, поделитесь ими в комментариях!