Как очеловечить текст написанный ИИ: ТОП-10 сервисов и готовые промты
Тексты, сгенерированные нейросетью, уже давно перестали быть чем-то экстраординарным: ими пользуются копирайтеры, маркетологи, студенты, предприниматели. Одна проблема: читатель все еще чувствует подвох. Иногда с первой строчки, иногда — к середине абзаца, но ощущение «тут писала машина» снижает доверие к любому материалу. Очеловечить текст — задача, ради решения которой одни часами вчитываются в каждое предложение, а другие просят ту же нейросеть переписать собственный результат. И у вторых, как ни парадоксально, часто получается лучше.
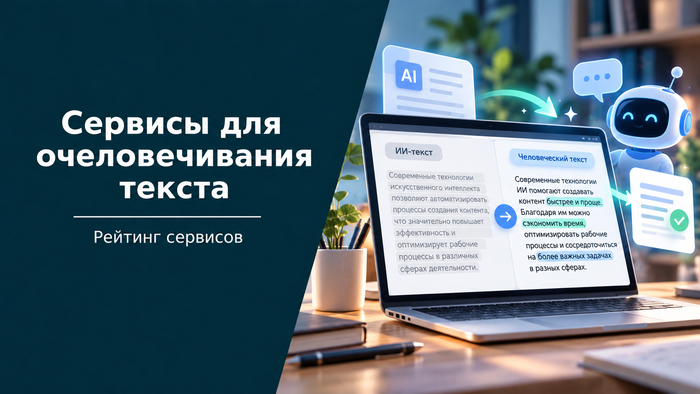
В этой статье я собрал десять сервисов, которые справляются с очеловечиванием лучше остальных, разобрал три уровня «машинности» и подготовил промпты, которые вы сможете скопировать и опробовать прямо сейчас.
Топ-10 сервисов для очеловечивания текста в 2026 году
Claude — флагман Anthropic с новейшей линейкой 5.5, который тонко чувствует стилевые нюансы русского языка и выдает текст, почти не требующий редактуры.
Perplexity — поисковая нейросеть с живыми ссылками на источники: переписывает и дополняет текст, опираясь на актуальные данные, а не на «знания» из обучающей выборки.
ChatGPT — экосистема OpenAI, в которой черновик превращается в готовый материал через диалог с ИИ.
Study AI — российский агрегатор с оплатой в рублях, открывающий доступ к GPT-6 Astra, Claude Fable 5.1 и десяткам других моделей через одну подписку.
Sindikat AI — компактная отечественная платформа, объединившая в одном окне 25 моделей для текста, изображений и видео, с оплатой картой РФ или через СБП.
DeepSeek — открытая модель с 1,6 триллиона параметров и низкой стоимостью API, которая на аналитических и кодовых задачах приближается к закрытым гигантам рынка.
Gemini — мультимодальный флагман Google с Gemini 3.8 Flash, глубоко интегрированный в Workspace: правит текст прямо в Google Docs.
Terra — «золотая середина» семейства GPT-5.6: контекстное окно на миллион токенов и качество, сопоставимое со старшими моделями, за заметно меньшие деньги.
Kimi — крупнейшая открытая модель в мире (2,8 триллиона параметров от Moonshot AI) с агентным режимом Swarm, где сотни подагентов параллельно прорабатывают сложный запрос.
MiniMax — мультимодальная платформа с текстовой моделью M3.1 и генератором видео Hailuo H3, одинаково уверенно работающая и со словом, и с картинкой.
1. Claude
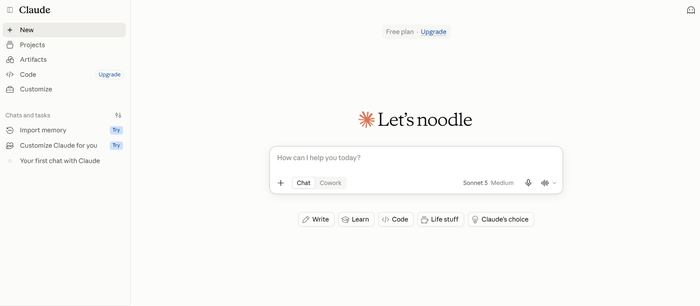
Нейросеть от Anthropic, которая в сентябре этого года обновилась до поколения 5.5. Opus 5.5 — флагманская модель линейки — принимает на вход текст и изображения, работает с контекстным окном до миллиона токенов и выдает до 128 тысяч токенов за один ответ. Среди конкурентов Claude выделяется естественностью русскоязычной генерации: тексты получаются ритмически разнообразными, с минимумом канцеляризмов и шаблонных связок. Для задач, связанных с очеловечиванием, это, пожалуй, один из самых удобных инструментов: переписанный результат редко приходится дорабатывать вручную.
Плюсы
Один из лучших результатов в генерации живого, стилистически гибкого текста на русском языке.
Контекстное окно в миллион токенов позволяет загрузить объемный документ целиком и переработать его за один проход.
Адаптивное мышление (Adaptive Reasoning) подстраивает глубину рассуждений под сложность запроса: от быстрой стилевой правки до многошаговой переработки.
Минусы
Порой заметна чрезмерная аккуратность в формулировках.
Бесплатный тариф ограничен по количеству сообщений, и лимит заканчивается быстро при объемных задачах.
2. Perplexity
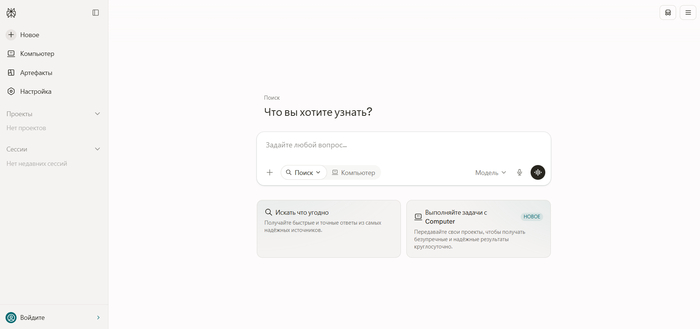
Поисковая платформа, которая совмещает генерацию текста с проверкой фактов в реальном времени. Pro Search анализирует свыше 300 источников на один запрос, а каждый абзац ответа сопровождается кликабельными ссылками на первоисточники. В режиме Model Council Perplexity прогоняет ваш запрос сразу через несколько моделей — GPT, Claude, Gemini — и показывает ответы рядом, что удобно при сравнении вариантов переписанного текста.
Плюсы
Каждое утверждение в ответе подкреплено ссылкой на источник — удобно для проверки фактов, когда вы дорабатываете сгенерированный материал.
Model Council дает возможность сравнить, как разные нейросети переписывают один и тот же фрагмент, и выбрать лучший вариант.
Есть собственный бесплатный браузер Comet.
Минусы
Главная сила Perplexity — поиск, а не глубокая стилевая работа с текстом.
Ответы иногда получаются суховатыми и фактологичными: сервис заточен скорее под точность, чем под живую подачу.
3. ChatGPT
Экосистема OpenAI, которая к сегодняшнему дню вышла далеко за пределы обычного чат-бота. Главная модель — GPT-6 Astra — лидирует в бенчмарках по управлению компьютером, написанию кода и профессиональной работе с документами. Projects позволяют хранить инструкции по стилю, файлы и контекст в одном месте, чтобы не повторять вводные в каждом новом диалоге.
Плюсы
Превращает работу над текстом в наглядный процесс: выделяете фрагмент — нейросеть переписывает именно его, не трогая остальное.
Самый широкий набор инструментов в одном интерфейсе: веб-поиск, интерпретатор кода, генерация изображений, голосовой режим.
Custom GPTs: вы создаете собственного «редактора-гуманизатора» со вшитыми инструкциями и используете его в один клик.
Минусы
GPT-6 Astra на русском языке иногда тяготеет к формальному стилю и калькам с английского — антипромпт с конкретными запретами здесь особенно важен.
При длинных сессиях модель порой «забывает» стилевые инструкции из начала диалога, и их приходится напоминать.
4. Study AI
Российский агрегатор, собравший под одной крышей десятки моделей для работы с текстом, изображениями, видео и звуком. Через единый интерфейс study24.ai доступны GPT-6 Astra, Claude Fable 5.1, Kimi K3, DeepSeek V4 и множество других — без переключений между сайтами и без отдельных подписок на каждый сервис. Оплата в рублях, российскими картами и через СБП. Для части текстовых моделей токены за запросы не списываются, что позволяет протестировать очеловечивание на разных нейросетях без затрат.
Плюсы
Доступ к актуальным моделям от OpenAI, Anthropic, Google, Moonshot и других — все через один аккаунт.
Оплата в рублях снимает проблему зарубежных подписок и привязки иностранных карт.
Есть бесплатные текстовые модели — хватит, чтобы попробовать разные подходы к переписыванию и выбрать подходящий.
Минусы
Интерфейс агрегатора проще, чем у оригинальных платформ, — часть продвинутых возможностей (Projects, Canvas, Memory) здесь недоступна.
Качество ответа зависит от выбранной модели, а не от самого агрегатора — при неудачном выборе результат разочарует.
5. Sindikat AI
Отечественная платформа с лаконичным и понятным интерфейсом. На sindikat.ai собрано 25 активных моделей для генерации текста (ChatGPT, Gemini, Claude, Grok), изображений (Nano Banana, GPT Image, Seedream) и видео (Google Veo, Kling, Seedance). Отмена подписки — в один клик, без скрытых платежей. Тестовый период за 299 рублей открывает полный доступ ко всем инструментам на неделю.
Плюсы
Единый интерфейс для текста, картинок и видео — удобно, если задачи выходят за рамки одного только копирайтинга.
Оплата картой РФ и через СБП — никаких обходных путей для доступа к зарубежным моделям.
Тестовый доступ за 299 рублей позволяет попробовать все модели до оформления подписки.
Минусы
Набор моделей компактнее, чем у крупных агрегаторов: всего 25.
На тарифе Pro кредитов хватает примерно на 100 изображений и 7 видео — для интенсивной работы придется перейти на Premium или Elite.
6. DeepSeek
Открытая модель из Китая, которая в апреле этого года добралась до версии V4. Старшая модификация — V4 Pro — весит 1,6 триллиона параметров, но благодаря архитектуре Mixture-of-Experts при генерации одного токена активирует лишь 49 миллиардов из них. Результат — качество, сопоставимое с закрытыми флагманами, при стоимости API в десятки раз ниже. Контекстное окно составляет миллион токенов, а открытая лицензия MIT позволяет запустить модель локально: Flash-версия в квантованном виде помещается на одну видеокарту RTX 4090.
Плюсы
Одна из самых дешевых frontier-моделей на рынке: входные токены у V4 Flash обходятся в $0,14 за миллион.
Открытые веса и лицензия MIT — при желании запускаете на собственном сервере, и данные никуда не уходят.
Миллиона токенов контекста хватает, чтобы загрузить целую книгу и переработать ее стиль за один сеанс.
Минусы
Русскоязычная генерация слабее, чем у Claude или ChatGPT: чаще проскальзывают кальки и неестественные обороты, антипромпт здесь критически важен.
Креативные и стилистические задачи — не самая сильная сторона: для поэзии, сторителлинга и маркетинговых текстов лучше выбрать другой инструмент.
7. Gemini
Мультимодальная модель Google. Нативная мультимодальность означает, что текст, изображения, аудио и видео обрабатываются в едином потоке: загружаете PDF, скриншот и аудиозапись в один запрос, и модель учтет контекст из всех трех файлов. Контекстное окно — миллион токенов. Глубокая интеграция с Google Workspace превращает Gemini в редактора, который работает прямо внутри Google Docs, Sheets и Gmail.
Плюсы
Нативная мультимодальность позволяет, например, загрузить скриншот чужого текста и попросить переписать его живым языком.
Трехуровневая система глубины мышления (low / medium / high) дает контроль над балансом между скоростью и качеством ответа.
Deep Research формирует развернутые отчеты по заданной теме — удобно, когда статью после генерации требуется насытить фактурой.
Минусы
На русском языке качество генерации чуть ниже, чем на английском: модель обучалась преимущественно на англоязычных данных.
Бесплатно доступна только Gemini 3 Flash.
8. Terra
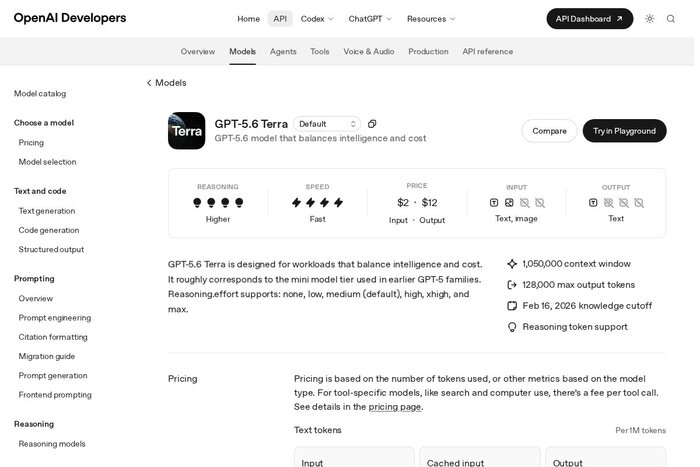
Языковая модель GPT-5.6 Terra от OpenAI, занимающая среднюю позицию в семействе между экономичной Luna и флагманской Sol. Контекстное окно — 1 050 000 токенов, максимальный вывод — 128 000 токенов. Terra принимает текст и изображения, работает с веб-поиском, интерпретатором кода и компьютерным управлением. По бенчмаркам модель конкурирует с Claude Fable 5 — при стоимости в несколько раз ниже, что делает ее привлекательным выбором для ежедневной работы с текстами.
Плюсы
Отличное соотношение цены и качества: результаты на уровне старших моделей за заметно меньшие деньги.
Контекст больше миллиона токенов позволяет обрабатывать объемные документы — длинные отчеты, дипломные работы, рукописи — целиком.
Поддержка структурированных выходных данных и потоковой обработки упрощает интеграцию в рабочие пайплайны.
Минусы
Fine-tuning для этой модели не предусмотрен — подстроить ее под свой стиль получится только через промпты и системные инструкции.
При запросах свыше 272 тысяч входных токенов цена удваивается, а стоимость вывода вырастает в полтора раза.
9. Kimi
Серия моделей от китайской компании Moonshot AI, флагман которой — Kimi K3, выпущенный в июле этого года, — стал крупнейшей открытой моделью в мире: 2,8 триллиона параметров. Архитектура Delta Attention и контекстное окно в миллион токенов позволяют K3 обрабатывать масштабные задачи, а агентный режим Swarm запускает до 300 подагентов параллельно: каждый отвечает за свой участок работы. По результатам независимых тестов Kimi K3 соперничает с закрытыми флагманами OpenAI и Anthropic.
Плюсы
Открытые веса и масштаб в 2,8 триллиона параметров — мощность frontier-модели с возможностью локального развертывания.
Swarm-режим: сотни подагентов параллельно прорабатывают разные аспекты сложного запроса, что ускоряет решение масштабных задач.
Сильные позиции в кодинге и аналитике — для переработки технических текстов Kimi подходит отлично.
Минусы
Русскоязычная генерация уступает англоязычной: модель обучалась преимущественно на китайских и английских данных, и в текстах на русском проскальзывают стилистические шероховатости.
Интерфейс веб-версии проще, чем у ChatGPT или Claude, — меньше встроенных инструментов для редактирования текста.
10. MiniMax
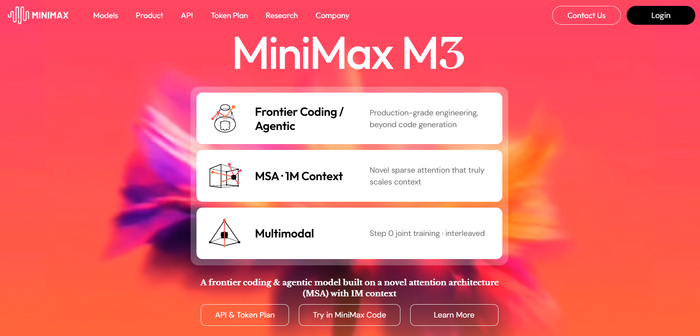
Китайская компания, которая развивает мультимодальную экосистему: текст, изображения, видео, музыка и озвучка — все в одном месте. Текстовая модель M3 с контекстным окном в миллион токенов и открытыми весами вышла летом этого года, а буквально на днях дебютировала обновленная M3.1-Flash-Preview в MiniMax Code. Видеогенератор Hailuo H3 создает ролики со звуком продолжительностью до 15 секунд в разрешении 2K, и именно на видео MiniMax прославился в первую очередь.
Плюсы
M3 — единственная открытая модель, совмещающая frontier-уровень в коде, контекст в миллион токенов и нативное понимание изображений и видео.
Hailuo H3 — один из сильнейших генераторов коротких видео, особенно в Motion-дизайне и анимации.
MSA (MiniMax Sparse Attention) — фирменная архитектура внимания, которая ускоряет обработку длинного контекста в 9–15 раз по сравнению с предыдущим поколением.
Минусы
Русский язык — не приоритетное направление: модель сильнее в английском и китайском, и при генерации на русском потребуется тщательно продуманный промпт.
M3.1-Flash-Preview пока на стадии превью — стабильность и качество еще предстоит проверить.
Как очеловечить текст, написанный ИИ: три уровня машинности
Большинство советов по очеловечиванию текста сводятся к одному: «уберите штампы и добавьте личный опыт». Совет рабочий, но поверхностный. Машинная генерация оставляет следы на трех разных уровнях, и если зачистить только верхний — детекторы все равно поймают, а внимательный читатель все равно почувствует неладное. Я разберу каждый уровень отдельно: от очевидных маркеров до тонкостей, которые прячутся в выборе слов и порядке слов внутри предложения. А в конце — компактный чек-лист, который стоит пройти перед публикацией любого материала.
Поверхностный уровень: штампы, канцеляризмы, шаблонные связки
Это то, что бросается в глаза первым. «Является», «данный», «в рамках», «на сегодняшний день», «стоит отметить», «важно понимать» — у нейросетей эти конструкции встречаются в разы чаще, чем в текстах живых авторов. Сюда же — вводные «безусловно», «несомненно», «следует подчеркнуть» и однотипные зачины абзацев: «Кроме того», «Более того», «Помимо этого», «Также». Если пять абзацев подряд начинаются со служебного слова — перед вами почти наверняка машинный текст.
Почему так происходит? Нейросеть стремится к связности и формальной корректности. Канцелярские обороты — самый «безопасный» способ склеить мысли: они универсальны, грамматически нейтральны и не рискуют прозвучать неуместно. Живой автор рискует: ставит короткое «а вот еще», начинает абзац с примера, обрывает мысль вопросом. Нейросеть перестраховывается.
Как очеловечить текст нейросети на этом уровне? Рецепт прост. Пройдитесь по тексту поиском и замените каждый канцеляризм конкретной, предметной формулировкой. «Является эффективным инструментом» → «хорошо справляется». «В рамках данного исследования» → «в этом исследовании» или, еще лучше, — перестройте фразу вовсе. Вводные-связки убирайте без замены: чаще всего предложения отлично обходятся и без них. А разнообразить зачины абзацев проще, чем кажется: начните один с вопроса, другой — с короткого факта, третий — с цитаты.
Лексический уровень: кальки с английского
Вот здесь прячется то, что остается в тексте даже после тщательной редактуры. Нейросети обучены преимущественно на англоязычных данных, и при генерации на русском часто выбирают слово, которое является прямым переводческим эквивалентом частотного английского термина. Грамматически все корректно, словарь подтвердит, что слово существует, — но русскоязычный автор интуитивно выбрал бы другой синоним.
Вот конкретные пары — слева то, что предпочитает ИИ, справа — то, что естественнее для живой русской речи:
«Определенно» → «точно», «конечно».
«Убедитесь» → «проверьте».
«Предоставляет» → «дает».
«Исследуйте» → «попробуйте», «посмотрите».
«Значительно» → «заметно», «сильно», «куда больше».
«Ключевой» → «главный», «основной».
«Опция» → «вариант».
«Фокусироваться» → «сосредоточиться».
«Релевантный» → «подходящий», «уместный».
«Оптимизировать» → «улучшить», «подстроить».
«Контент» → «материал», «текст», «публикация».
«Имплементировать» → «внедрить», «применить».
«Генерировать» → «создавать», «писать», «выдавать».
Механизм простой: в английском тексте significantly встречается в десять раз чаще, чем noticeably, — и нейросеть переносит эту статистику в русский, выбирая «значительно» вместо «заметно». Формально — синонимы, но у русскоязычного читателя «значительно» в каждом втором предложении вызывает то самое смутное ощущение искусственности.
Как очеловечить текст, написанный искусственным интеллектом, на лексическом уровне? Самый надежный прием — прочитать каждое предложение и спросить себя: «Я бы так сказал вслух?» Если формулировка звучит как подстрочный перевод англоязычной статьи — меняйте. Со временем вырабатывается чутье: глаз начинает цепляться за «определенно», «обеспечивает» и «в конечном счете» автоматически.
Синтаксический уровень: порядок слов и ритм
Третий, самый глубокий слой. Русский язык — язык со свободным порядком слов, и живой автор пользуется этой свободой постоянно: выносит главное в начало фразы, ставит глагол перед подлежащим ради ритма, обрывает предложение на полуслове и подхватывает мысль в следующем. Нейросети этого почти не делают. Типичная машинная генерация на русском строится по английской схеме SVO: подлежащее → сказуемое → дополнение, предложение за предложением, абзац за абзацем.
Еще один характерный признак — нагромождение определений перед существительным. «Это мощный, многофункциональный, легко настраиваемый аналитический инструмент» — так строится английская фраза, где прилагательные стоят цепочкой перед Noun. В русском языке такая конструкция звучит тяжеловесно. Живой автор разнесет определения по предложению: «Инструмент мощный, заточен сразу под несколько задач, и настроить его получится за пару минут».
Третий сигнал — отсутствие парцелляции. Парцелляция — это когда часть предложения отрывается и оформляется как самостоятельное высказывание. «Сервис справляется с большинством задач. Быстро и без ошибок». Живые авторы используют парцелляцию интуитивно, и она придает тексту дыхание, рваный ритм. Нейросеть предпочитает гладкие, завершенные конструкции — и текст звучит монотонно, как зачитанный вслух параграф из учебника.
Справиться с этим уровнем сложнее, чем с предыдущими двумя, но рецепт есть. Перечитайте абзац и обратите внимание на длину предложений: если все примерно одинаковы — разбейте одно длинное на два коротких, а два коротких, наоборот, склейте. Переставьте слова в паре фраз так, чтобы ударная информация оказалась в начале или в самом конце. Добавьте одно оборванное предложение, один риторический вопрос, одну инверсию — и ритм оживет.
Почему детектор считает ваш собственный текст машинным — и что с этим делать
Ситуация обескураживает: вы написали текст сами, от первого до последнего слова, загрузили его в детектор — а тот показывает 60–70% вероятности ИИ-генерации. Ни одной нейросети рядом не было, но алгоритм уверен в обратном. Это не сбой и не заговор — у явления есть конкретные причины.
Детекторы ИИ-текста работают на основе статистических паттернов: анализируют частотность слов, предсказуемость следующего токена, длину предложений, разнообразие лексики. Если ваш текст совпадает с типичным «профилем» машинной генерации по нескольким параметрам одновременно — детектор сработает. А «совпасть» несложно: достаточно писать грамотно, ровно и без стилистических шероховатостей. Парадокс, но слишком «правильный» текст выглядит подозрительно именно потому, что живые авторы ошибаются, отвлекаются и пишут неровно, а нейросети — нет.
Вот что чаще всего вызывает ложное срабатывание.
Первое — однородная длина предложений. Если в абзаце все фразы содержат 15–20 слов, детектор видит в этом машинную равномерность.
Второе — частотная лексика. Слова из первой тысячи по употребляемости («представлять», «являться», «определенный», «эффективный») статистически ближе к ИИ-генерации, чем редкие, конкретные, «нишевые» слова.
Третье — отсутствие субъективности. Фактологичный текст без авторских оценок, оговорок и отступлений детектор воспринимает как машинный, потому что нейросети по умолчанию генерируют именно такой: нейтральный и обезличенный.
Что с этим делать, если вы уверены, что текст ваш?
Во-первых, разнообразьте длину предложений: пусть рядом окажутся фраза из трех слов и фраза из тридцати.
Во-вторых, замените пару частотных слов менее очевидными синонимами: не «эффективный», а «толковый»; не «представляет собой», а «по сути, это».
В-третьих, добавьте одну-две субъективные ремарки: мнение, сомнение, оговорку. Детекторы плохо справляются с текстами, в которых автор виден: со своими привычками, интонацией и мелкими несовершенствами.
И еще кое-что важное: ни один детектор не дает стопроцентной точности. Исследования показывают, что даже лучшие инструменты ошибаются в 10–15% случаев — как в сторону пропуска машинных текстов, так и в сторону ложных обвинений живых авторов. Относитесь к результату проверки как к ориентиру, а не приговору.
Чек-лист: десять проверок перед публикацией
Быстрый финальный прогон по тексту, который занимает пять-десять минут и ловит подавляющее большинство машинных маркеров. Я расположил пункты в порядке приоритета: сверху то, что заметнее всего.
1. Зачины абзацев. Откройте текст и прочитайте только первые слова каждого абзаца. Если три или больше начинаются одинаково («Кроме того», «Также», «Важно») — перестройте.
2. Канцеляризмы. Поищите «является», «данный», «осуществлять», «в рамках», «на сегодняшний день». Каждое вхождение — сигнал.
3. Кальки с английского. Пройдитесь по списку из раздела выше: «определенно», «предоставляет», «значительно», «фокусироваться», «опция», «релевантный». Замените естественными русскими аналогами.
4. Длина предложений. Если все фразы примерно одной длины — разбейте парочку длинных, склейте парочку коротких.
5. Порядок слов. Найдите три-четыре предложения подряд со схемой «подлежащее — сказуемое — дополнение» и переставьте слова хотя бы в одном из них.
6. Цепочки определений. Если перед существительным скопилось больше двух прилагательных или причастий — разнесите их по фразе или по соседним предложениям.
7. Вводные-паразиты. «Безусловно», «несомненно», «следует подчеркнуть», «важно понимать» — убирайте без замены. Текст не пострадает.
8. Авторский голос. Есть ли в тексте хотя бы два-три места, где звучит живой человек: мнение, сомнение, пример из опыта, шутка, оговорка? Если нет — добавьте.
9. Ритм. Прочитайте один абзац вслух. Если он звучит монотонно и ровно, как диктор на автоответчике, — добавьте парцелляцию, риторический вопрос или короткое восклицание.
10. Финальная проверка. Загрузите текст в детектор ИИ — не для того чтобы получить «пропуск», а чтобы увидеть, какие именно фрагменты алгоритм считает подозрительными. Доработайте точечно эти участки.
Промт для того, чтобы очеловечить текст: шесть готовых запросов на разные случаи
Промпты ниже написаны на русском языке и работают в любой нейросети: от Claude и ChatGPT до DeepSeek и Kimi. Каждый решает свою задачу, и каждый содержит антипромпт в конце: набор конкретных запретов, которые не дают нейросети скатиться обратно в машинный стиль. Копируйте, вставляйте свой текст вместо плейсхолдера — и пробуйте.
Редактор-гуманизатор
Готовый ИИ-текст превратится в живой материал, очищенный от машинных маркеров на всех трех уровнях: от штампов до калек с английского.
Перепиши текст ниже так, чтобы он звучал как написанный живым русскоязычным автором — журналистом или блогером с опытом в теме. Сохрани фактический смысл и структуру, но измени подачу по следующим правилам. Ритм: чередуй длинные предложения с короткими, разбивай списки прозой. Лексика: замени канцеляризмы и формальные обороты разговорными аналогами; особое внимание — словам-калькам с английского: «определенно» замени на «точно» или «конечно», «убедитесь» — на «проверьте», «предоставляет» — на «дает», «исследуйте» — на «попробуйте», «значительно» — на «заметно» или «сильно», «фокусироваться» — на «сосредоточиться», «опция» — на «вариант», «релевантный» — на «подходящий»; если встретишь подобные кальки, которых нет в этом списке, — тоже заменяй. Синтаксис: не выстраивай каждое предложение по схеме «подлежащее — сказуемое — дополнение»; используй инверсии, выноси важное в начало или конец фразы; если перед существительным скопилось больше двух определений — перестрой фразу, разнеси их. Добавь 1–2 коротких авторских ремарки от первого лица. Не используй конструкции «является», «данный», «в рамках», «осуществлять», «на сегодняшний день», «стоит отметить»; не начинай соседние предложения одинаково; не ставь эмодзи; не используй вводные «безусловно», «несомненно», «важно понимать», «следует подчеркнуть». Текст: [вставьте текст].
Генерация с нуля в живом стиле
Нейросеть сгенерирует статью, которая уже на этапе создания будет лишена типичных признаков машинного текста, включая кальки и монотонный синтаксис.
Напиши статью на тему «[тема]» объемом около [число] слов. Целевая аудитория — [описание]. Пиши от первого лица, как автор, который разбирается в вопросе и делится собственным опытом, а не пересказывает справочник. Стиль: начни с короткой истории, случая или наблюдения; в каждом смысловом блоке допусти одно субъективное мнение или оговорку («по моему опыту», «я пробовал иначе — не сработало»); варьируй длину абзацев от одного предложения до пяти-шести. Лексика: выбирай слова так, как выбрал бы носитель русского языка, а не переводчик с английского; вместо «определенно» — «точно» или «конечно», вместо «предоставляет» — «дает», вместо «исследуйте» — «попробуйте» или «посмотрите», вместо «значительно» — «заметно» или «сильно», вместо «контент» — «материал» или «текст» (где уместно), вместо «фокусироваться» — «сосредоточиться»; избегай любых слов, которые звучат как буквальный перевод с английского, если у них есть более естественный русский аналог. Синтаксис: варьируй порядок слов, не ставь каждое предложение по схеме «подлежащее — сказуемое — дополнение»; используй инверсии; не нагромождай определения перед существительным — разноси их по фразе. Не используй слова и конструкции: «является», «данный», «в рамках», «в современном мире», «на сегодняшний день», «стоит отметить», «важно понимать», «в заключение хочется сказать»; не начинай абзацы со слов «также», «кроме того», «более того», «помимо этого»; не ставь эмодзи.
Имитация авторского стиля
Нейросеть изучит образец вашего текста и сгенерирует новый фрагмент, воспроизводя лексику, ритмику и синтаксические привычки оригинала.
Ниже — фрагмент текста, который служит образцом авторского стиля.
Образец: [вставьте фрагмент 150–300 слов].
Проанализируй образец по пяти параметрам: (1) средняя длина предложений и разброс между самым коротким и самым длинным; (2) характерные синтаксические приемы — инверсии, парцелляция, риторические вопросы, вводные конструкции; (3) лексический регистр — разговорный, нейтральный или книжный, и есть ли переключения между ними; (4) частотные слова, обороты и способы связи между предложениями; (5) способ обращения к читателю — прямое, косвенное или отсутствует. Выведи краткий стилевой профиль (5–7 пунктов), а затем напиши новый текст на тему «[тема]» объемом [число] слов, точно воспроизводя все выявленные особенности. Не копируй фразы из образца, воспроизводи манеру. Не добавляй штампы, вводные или конструкции, которых в образце не было; не переходи на более высокий или более низкий регистр; не подменяй живые русские слова кальками с английского, если их нет в образце.
Диагност ИИ-следов
Вместо переписывания нейросеть составит подробный разбор: какие фрагменты выглядят машинными, к какому типу маркеров относятся и как их исправить.
Проанализируй текст ниже как редактор, проверяющий материал на признаки машинной генерации. Работай на трех уровнях: (1) поверхностный — канцеляризмы, штампы, шаблонные вводные; (2) лексический — слова-кальки с английского, которые формально корректны, но неестественны для живого русского текста (например, «определенно» вместо «точно», «предоставляет» вместо «дает», «фокусироваться» вместо «сосредоточиться»); (3) синтаксический — однообразный порядок слов, нагромождение определений перед существительным, отсутствие инверсий и ритмического разнообразия. Для каждого найденного маркера заполни строку в таблице: «Фрагмент» (цитата), «Тип» (поверхностный / калька / синтаксис), «Почему выглядит машинным» (пояснение в одном предложении), «Вариант замены» (живая переформулировка). После таблицы — резюме: сколько маркеров на каждом уровне, какой уровень проблемнее всего и какой один прием правки даст максимальный эффект. Не переписывай текст целиком, работай точечно. Не оценивай содержание и фактуру — только естественность звучания. Текст: [вставьте текст].
Мультиролевая цепочка: редактор → читатель → редактор
Текст пройдет три этапа обработки: правку, оценку глазами целевой аудитории и финальную доработку с учетом обратной связи.
Выполни три последовательных шага. Результат каждого шага используется в следующем. Отделяй шаги заголовками «Шаг 1», «Шаг 2», «Шаг 3».
Шаг 1 — Роль: опытный редактор русскоязычных медиа. Перепиши текст ниже, устранив признаки машинной генерации на трех уровнях. Поверхностный: убери канцеляризмы, штампы, шаблонные связки. Лексический: замени слова-кальки с английского естественными русскими аналогами (например, «определенно» → «точно», «предоставляет» → «дает», «значительно» → «заметно»). Синтаксический: разнообразь порядок слов, разбей цепочки определений, добавь инверсии. Добавь 1–2 живые авторские ремарки.
Шаг 2 — Роль: типичный представитель целевой аудитории ([указать: студент / предприниматель / молодая мама / etc.]). Прочитай результат Шага 1 и напиши рецензию из 3–5 пунктов: что звучит убедительно и живо, а что все еще кажется написанным нейросетью. Цитируй конкретные фрагменты.
Шаг 3 — Роль: тот же редактор. Учти замечания Шага 2 и доработай текст. Финальная версия — полностью готовый к публикации материал.
Не пропускай шаги, не объединяй их. Не используй «данный», «является», «стоит отметить», «важно понимать», «в заключение хочется сказать»; не ставь эмодзи; не начинай соседние предложения одинаково; не используй слова-кальки с английского, если есть живой русский аналог. Текст: [вставьте текст].
Антиштамп-фильтр для абзаца
Один абзац пройдет точечную переработку: каждый штамп, калька и неестественный оборот будут заменены живой формулировкой с полным сохранением смысла.
Возьми абзац ниже. Найди в нем каждое клише, штамп, канцеляризм, кальку с английского и любой оборот, который выдает машинную генерацию. Замени каждый такой элемент формулировкой, которую выбрал бы живой русскоязычный автор. Смысл, объем абзаца и порядок мыслей сохраняются полностью — меняется только способ выражения. Фрагменты, которые уже звучат естественно, оставь без изменений. Обращай особое внимание на два неочевидных слоя: слова, которые звучат как буквальный перевод с английского (например, «определенно», «опция», «фокусироваться», «релевантный»), и однообразный порядок слов — если все предложения построены по схеме «подлежащее — сказуемое — дополнение», перестрой часть из них. Не дописывай новых мыслей, не убирай существующих, не меняй стилевой регистр. Не используй «является», «данный», «осуществлять», «на сегодняшний день», «безусловно», «несомненно», «важно отметить». Абзац: [вставьте абзац].
FAQ: какую нейронку, которая очеловечивает текст, выбрать
Чем отличается очеловечивание от рерайта?
Рерайт — это пересказ чужого текста другими словами ради уникальности. Очеловечивание — работа с собственным (или сгенерированным для вас) текстом ради естественности звучания. Рерайт меняет формулировки, очеловечивание меняет стиль, ритм и лексический состав. Текст после рерайта вполне способен звучать так же машинно, как и до него, — просто другими словами.
Детекторы ИИ-текста точны?
Ни один детектор не гарантирует стопроцентный результат. Лучшие инструменты ошибаются в 10–15% случаев: и в сторону пропуска машинных текстов, и в сторону ложных срабатываний на живых авторах. Воспринимайте результат проверки как подсказку, а не как вердикт. Если детектор пометил конкретный абзац — присмотритесь к нему, но не переписывайте весь материал с нуля.
Достаточно ли одного промпта, чтобы бесплатно очеловечить текст нейросети онлайн?
Зависит от исходника. Если текст сгенерирован на русском по хорошему промпту с внятным антипромптом — одного прохода через «Редактор-гуманизатор» часто хватает. Если текст создан стандартным запросом без уточнений — лучше использовать «Мультиролевую цепочку» или прогнать результат через «Диагност ИИ-следов», а потом доработать точечно. Бесплатных сообщений в большинстве нейросетей хватит на два-три таких прохода.
Почему после очеловечивания текст иногда теряет фактологическую точность?
Нейросеть при переписывании расставляет приоритеты: если вы попросили «живой стиль», она сосредоточится на подаче и может упростить формулировку в ущерб точности. Совет — в промпте явно укажите: «сохрани все цифры, даты, имена и факты без изменений». А после переработки пройдитесь по фактуре вручную: сверьте числа, проверьте названия, убедитесь, что нейросеть не заменила термин приблизительным синонимом.
Как очеловечить текст, написанный ИИ, бесплатно: без дорогих подписок и сервисов?
Большинство крупных нейросетей дают бесплатные сообщения: Claude, ChatGPT, Gemini. Копируете промпт из этой статьи, вставляете свой текст — и получаете переработанную версию. DeepSeek к тому же полностью открыт и бесплатен через веб-интерфейс. Российские агрегаторы вроде Study AI предлагают бесплатные модели для текстовых запросов. Ограничения, конечно, есть — по количеству сообщений или по доступу к старшим моделям, — но для разовой переработки статьи или поста их обычно хватает.
На каком этапе лучше очеловечивать: после генерации или в процессе?
В процессе. Если вы заложите требования к стилю, антипромпт и примеры прямо в исходный запрос, результат будет заметно лучше, чем при переписывании готового текста постфактум. Переписывание тоже работает, но это всегда «ремонт», а не «строительство». По возможности начинайте с промптов вроде «Генерация с нуля в живом стиле» или «Имитация авторского стиля», а «Редактор-гуманизатор» используйте как финальную шлифовку.
Половину ИИ-текстов выдает не тема и не содержание, а мелочи: одинаковые зачины абзацев, «определенно» в каждом втором предложении, гладкий и ровный ритм без единой шероховатости. Хорошая новость: именно мелочи проще всего исправить. Шесть промптов из этой статьи, чек-лист на десять пунктов и понимание трех уровней машинности дают вам инструменты, которыми вы за пятнадцать-двадцать минут превратите любой сгенерированный черновик в текст, за который не стыдно. А сервисы из моего топа помогут очеловечить текст не в теории, а прямо сейчас — откройте любой из них, вставьте промпт и проверьте сами.