
Саня,
Ой,
Ой,
С ростом популярности нейросетей редакторы, преподаватели и авторы все чаще сталкиваются с вопросом, кто на самом деле написал материал — человек или алгоритм. Проверка текста на нейросеть превращается из узкоспециальной задачи в повседневную практику: нужно оценить диплом, статью, коммерческий материал или пост, не попадая в ловушку ложных обвинений. Понимание того, как на самом деле устроен ИИ-детектор, где он имеет смысл, а где создает больше проблем, помогает действовать спокойно и аргументированно даже в спорных ситуациях.
Я протестировал инструменты и отобрал лучшие варианты, которые хорошо справляются с русским языком. В статье покажу, как они устроены, дам практические советы по усилению авторства и использованию сервисов для определения AI-следов.
Проверка текста на использование ИИ — это процесс, в котором специальный алгоритм анализирует материал и оценивает, насколько вероятно, что его создал человек, а не языковая модель вроде ChatGPT, Claude или Gemini. Такие сервисы не «видят» автора и не проверяют ваши намерения — они сравнивают статистические паттерны текста с тем, что модель узнала на тысячах примеров человеческого и машинного письма.
Большинство современных систем опираются на три типа сигналов.
Перплексия (perplexity). Этот показатель отражает, насколько предсказуемым выглядит текст для языковой модели. Если каждое следующее слово легко угадать по предыдущим, перплексия низкая — это типично для текстов, сгенерированных ИИ, потому что модели обучены выдавать статистически наиболее вероятные продолжения.
Вариативность/взрывность (burstiness). Параметр показывает, насколько разнообразны длина и структура предложений в тексте. Человеческое письмо обычно более «неровное»: короткие фразы чередуются с длинными, синтаксис меняется, ритм живее. У ИИ-текста этот показатель часто более равномерный.
Классификатор на признаках стиля. Детектор извлекает из текста набор признаков: частотность токенов, повторы, синтаксические шаблоны, распределение лексики — и прогоняет их через обученную модель, которая уже видела много размеченных примеров «человек vs ИИ». На выходе получается вероятность или процент, например «78% вероятности, что текст создан ИИ».
С технической точки зрения детектор текста на использование нейросети работает примерно так:
текст очищают от лишнего форматирования, разбивают на предложения и токены;
считают базовые метрики: перплексию, энтропию, вариативность длины предложений, повторы и другие стилометрические признаки;
при необходимости сравнивают эмбеддинги текста с известными кластерами ИИ-контента и проверяют наличие водяных знаков или метаданных, если производитель модели их добавил;
все признаки подают на классификатор, который выдает итоговую оценку: «скорее человек», «скорее ИИ» или процентный показатель.
Ни один детектор текста на использование нейросети не дает стопроцентной гарантии. Исследования и тесты показывают, что детекторы систематически чаще помечают как «сгенерированные ИИ» тексты авторов, для которых язык публикации не является родным: в работе Стэнфорда более 60% эссе таких студентов были ложно определены как машинные, и аналогичная проблема наблюдается для русскоязычных авторов, пишущих формально и аккуратно.
Причина — в самой метрике перплексии: те, кто пишет проще, использует более ограниченный словарный запас или следует строгим академическим шаблонам, автоматически попадают под подозрение. На русском языке многие детекторы работают менее точно, потому что обучались преимущественно на английских корпусах, а публичных замеров ложных срабатываний именно для русского почти нет.
Формальное академическое письмо, техническая документация, переводные тексты и материалы с сильной редактурой тоже часто получают низкую перплексию и низкую вариативность просто из-за стандартизированной терминологии и повторяющихся конструкций. Поэтому такие инструменты стоит воспринимать как вспомогательный сигнал, а не как окончательный вердикт, и при необходимости дополнять автоматическую оценку ручной экспертизой и контекстом.
Чтобы проверить работу на ИИ, действуйте по простому алгоритму — он подойдет для статей, учебных текстов и коммерческих материалов.
Выберите сервис. Для разовой проверки подойдут бесплатные онлайн-детекторы. Если вы планируете регулярно использовать детектор в редактуре или контент-производстве, присмотритесь к платным решениям с API и пакетной загрузкой.
Подготовьте текст. Уберите лишнее форматирование, скриншоты и таблицы — большинство детекторов принимают только чистый текст. Оптимальный объем — от 150–200 слов: на коротких отрывках результат часто нестабилен, особенно если текст создан через генератор.
Загрузите материал. Скопируйте фрагмент в поле ввода или загрузите файл (DOCX, PDF, TXT), если сервис это поддерживает. Некоторые платформы позволяют сразу проверить несколько документов разом — это удобно, когда нужно оценить применение ИИ в серии материалов.
Интерпретируйте результат. Смотрите не только на общий процент «ИИ», но и на разбивку по абзацам: часто часть текста помечается как человеческая, часть — как сгенерированная. Обращайте внимание на предупреждения о низкой уверенности модели.
ТЕКСТ.РУ— самый «заточенный» под рунет: алгоритм обучен на русскоязычных корпусах и лучше считывает местные штампы.
Текстовод— полностью бесплатный доступ без регистрации и подсветка конкретных подозрительных фрагментов.
Пиксель Тулс— встроен в SEO-экосистему с аналитикой видимости, упоминаний и конкурентов, поэтому удобен для комплексной работы.
1. ТЕКСТ.РУ
Этот сервис для проверки текста на нейросети использует собственный алгоритм для оценки авторства. Анализирует повторы слов и фраз, шаблонные конструкции и однотипные предложения, характерные для машинного письма. Чтобы запустить проверку, нужно вставить текст в окно детектора, нажать кнопку «Проверить текст» и через несколько секунд получить результат в процентах вероятности участия ИИ. Сервис изначально заточен под русскоязычный контент, поэтому для статей, постов и учебных работ на русском он показывает более адекватные результаты, чем многие зарубежные детекторы.
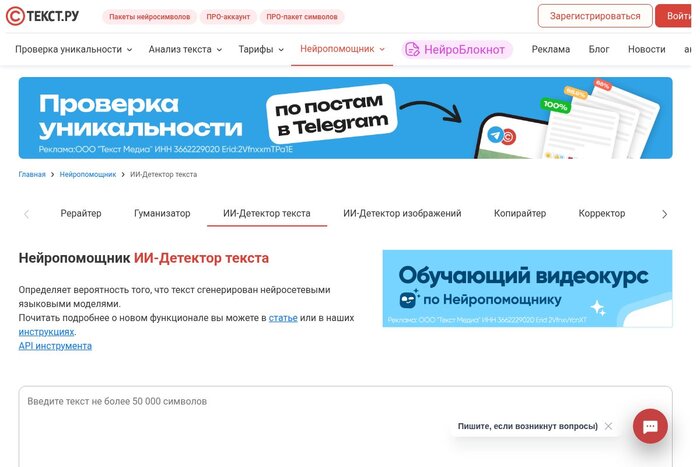
Бесплатная версия: нет
Ограничения: минимальный объем — 100 символов, максимальный — 50 000 символов за одну проверку
Вид результата: процент вероятности, что текст сгенерирован нейросетью, без детальной разбивки по абзацам
Преимущества
ориентирован на русскоязычные тексты, что важно для статей, дипломов и коммерческого контента на русском;
подходит для комплексного анализа материалов: в одном окне можно проверить работу на плагиат и ИИ;
распознает тексты от популярных моделей: ChatGPT, Gemini, Claude, DeepSeek.
Недостатки
нет бесплатного тарифа и попробовать бесплатно нельзя.
2. Текстовод
AI-инструмент проводит проверку на написание текста искусственным интеллектом, анализируя статистические паттерны, повторяющиеся конструкции и другие признаки машинного письма, и подсвечивает участки, которые выглядят подозрительно. Проверку можно запустить прямо на сайте: нужно вставить текст в окно детектора, нажать кнопку анализа и через несколько секунд получить вердикт с процентом «человечности» и выделением фрагментов, которые стоит перепроверить, при этом сервис также обращает внимание на правописание и общую читаемость текста.
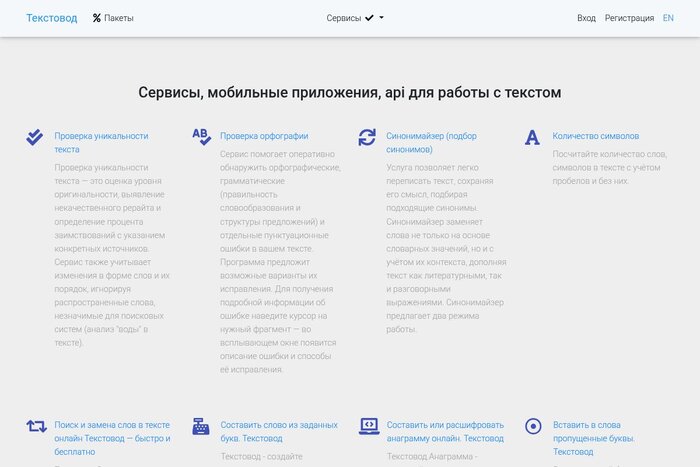
Бесплатная версия: есть, детектор ИИ доступен без оплаты.
Ограничения: минимум 250 символов, максимум 1 млн.
Вид результата: процент «человечности» текста с подсветкой участков, которые детектор считает сгенерированными
Преимущества
полностью бесплатный доступ без обязательной регистрации;
показывает не только общий процент, но и подсвечивает конкретные фрагменты, которые выглядят подозрительно;
интегрирован в экосистему Textovod, где есть проверка уникальности, орфографии, рерайт и другие инструменты.
Недостатки
алгоритм может ошибаться на коротких текстах, канцелярском стиле и материалах с большим количеством штампов.
3. Пиксель Тулс
Здесь проверка работы на использование ИИ устроена как часть SEO-инструментария: сервис смотрит не только на «машинность», но и на то, как текст будет вести себя в поиске. Алгоритм оценивает лексику, синтаксис и скрытые языковые паттерны, чтобы определять, написан материал человеком или сгенерирован моделью, и сразу подсвечивает подозрительные фрагменты.
Бесплатная версия: пробный доступ после регистрации
Ограничения: для больших документов может потребоваться разбивка на части
Вид результата: процент вероятности ИИ-происхождения текста с выделением фрагментов
Преимущества
заточен под русскоязычные тексты и SEO-задачи, что важно для статей, лендингов и коммерческого контента;
результат появляется через несколько секунд после запуска анализа;
входит в экосистему Pixel Tools, где есть проверка уникальности, SEO-анализ текста и другие инструменты для оптимизации.
Недостатки
для полноценного использования требуется регистрация и подписка, полностью бесплатного тарифа нет.
Публиковать полностью сгенерированные тексты без человеческой доработки рискованно: такие материалы часто выглядят шаблонно, содержат фактические ошибки и не дают читателю ничего нового. Проверка текста на авторство нейросети помогает узнавать машинные заготовки, но даже вердикт «написано человеком» не спасет статью, если в ней нет фактов, примеров и авторской позиции.
SEO-риски и потеря позиций. Google и Яндекс не штрафуют за сам факт создания контента через ИИ, но оба поисковика целенаправленно пессимизируют массово выпущенные страницы без экспертной редактуры и оригинальной пользы. В Google такие материалы попадают под фильтры scaled content abuse и Helpful Content System, в Яндексе — под алгоритмы «Тайфун» и обновленное антиспам-ядро, которые распознают шаблонный AI-контент и снижают его видимость.
Репутационные и юридические риски. Полностью машинные тексты чаще содержат фактические ошибки, устаревшие данные и «галлюцинаторные» утверждения. Проверочный контроль со стороны редактора-эксперта обязателен, особенно в сферах медицины, финансов, политики.
Проблемы с цитируемостью и ссылками. Контент без оригинальных данных, кейсов и живого опыта почти не попадает в сниппеты AI Overviews в Google и в нейроответы «Алисы» в Яндексе, а также редко цитируется другими ресурсами. В результате статья может висеть в индексе, но не приносить трафика, ссылок и реального охвата, потому что поисковики отдают приоритет материалам с выраженной экспертизой и уникальной фактурой.
Инструменты распознавания ИИ — полезные помощники, но не «рентген авторства»: они оценивают статистическое сходство с машинными формулировками, а не доказывают, кто именно создал материал. Их задача — помочь редактору или преподавателю внимательнее проанализировать работу, а не заменить человеческую оценку автоматическим вердиктом.
Нет, стопроцентной точности не дает ни один сервис, и обнаружение ИИ-текста всегда работает с вероятностями. Если вы ищете, как проверить текст на генерацию нейросетью, детекторы могут подсказать, что материал «скорее похож на ИИ» или «скорее человеческий», но не выносят окончательный вердикт.
Алгоритмы путают ИИ-текст с материалами авторов, которые неполно владеют языком, сухим академическим стилем, переводами и сильно отредактированными текстами, где перплексия и взрывность выглядят «машинными». На русском языке точность часто ниже, потому что многие модели обучались преимущественно на английских корпусах. Исследования фиксируют высокий уровень ложных срабатываний именно для таких текстов, поэтому один процент из анализатора нельзя считать достаточным основанием для выводов.
Чтобы детекторы приносили пользу, а не лишние проблемы, стоит сразу принять их как вспомогательный инструмент, а не как окончательную инстанцию.
Сравнивайте результаты нескольких платформ
Используйте 2–3 разных ресурса и сравнивайте показатели, а не делайте выводы по одной цифре. Разные системы опираются на разные наборы признаков, поэтому материал, который одна платформа помечает как «скорее ИИ», другая может оценить как «скорее человеческий». Если несколько независимых инструментов показывают похожую картину, это более надежный сигнал, чем единичная оценка.
Проверяйте материал достаточного объема
Анализируйте публикации объемом от 150–200 слов: на коротких отрывках точность резко падает. Если работа небольшая, лучше оценивать ее целиком, а не по одному-двум абзацам, чтобы алгоритм мог уловить общие паттерны стиля, а не реагировать на случайные формулировки.
Анализируйте разбивку по фрагментам
Смотрите на распределение оценок по абзацам и отдельным кускам, а не только на общий балл. Часто система помечает как подозрительные только отдельные части работы — например, введение или теоретический блок, написанный более формально. Это помогает точечно доработать материал, а не переписывать его целиком.
Дополняйте автоматическую оценку ручной экспертизой
Всегда дополняйте машинную проверку ручной экспертизой: факты, логика, стиль, контекст. Спросите себя, есть ли в публикации уникальные данные, кейсы, примеры из практики, авторские выводы — именно эти элементы отличают живой материал от шаблонной генерации и укрепляют вашу позицию как создателя.
Фиксируйте процесс создания материала
Фиксируйте источники, план и промежуточные версии: при спорной ситуации вы сможете продемонстрировать логику работы, а не только финальный результат. Сохраняйте черновики, заметки, историю версий в редакторе, скриншоты промптов и ответов нейросети, если вы ее использовали. Такой «портфель автора» убедительнее любого отдельного инструмента.
Не используйте оценку как единственное основание для решений
Не применяйте результат проверки как единственный аргумент для санкций или публикационных решений. В академической и издательской среде итог анализа стоит рассматривать как повод для дополнительной беседы и углубленного разбора, а не как автоматическое доказательство нарушения.
Усиливайте авторскую составляющую работы
Чтобы снизить риск ложных срабатываний и укрепить авторство, намеренно добавляйте в материал личные наблюдения, профессиональный опыт, уникальные примеры и ссылки на конкретные источники. Чем больше в публикации индивидуальной фактуры и меньше шаблонных формулировок, тем меньше она похожа на типовую ИИ-генерацию и тем увереннее вы сможете отстаивать свое авторство.
Можно начать с русскоязычных сервисов вроде Текстовод и Пиксель Тулс. Но бесплатные версии обычно режут объем текста: у Textovod без оплаты доступно около 300 символов за проверку, у Pixel Tools — пробный период с ограниченным числом запросов.
Да, на коротких отрывках (менее 150–200 слов) большинство детекторов работают нестабильно и чаще выдают противоречивые результаты. Если вы хотите создавать надежную оценку, проверяйте текст целиком или хотя бы несколькими крупными фрагментами, а не по одному-двум абзацам.
Не паниковать и не воспринимать это как обвинение: соберите черновики, историю версий, источники и покажите, как текст развивался. Параллельно прогоните материал через 2–3 разных сканера и приложите их отчеты вместе с вашей «доказательной базой» — это убедительнее, чем один процент.
Не обязательно, многие авторы используют нейросеть как помощника для плана, черновика или идей, а затем глубоко перерабатывают материал. Главное — не публиковать сырую генерацию без редактуры и добавлять в текст уникальные факты, примеры и авторский взгляд, чтобы итоговая статья проходила и по качеству, и по восприятию читателей и поисковиков.
Нет, результат анализатора сам по себе не считается юридическим или академическим доказательством авторства. Даже качественный сканер текста показывает лишь вероятность и может ошибаться, поэтому в серьезных ситуациях (вуз, издательство, суд) важнее черновики, история версий, источники и свидетельства процесса работы, а не один процент.
Описанные сервисы подойдут редакторам, преподавателям, авторам контента и всем, кто регулярно сталкивается с необходимостью оценить происхождение текста. Начинать стоит с бесплатных инструментов и сравнения результатов на нескольких платформах, чтобы сформировать собственное представление об их адекватности и уровне ложных срабатываний. Грамотная проверка текста на нейросеть — это не гонка за низким процентом, а часть системной работы над авторством: фиксация источников, сохранение черновиков, добавление уникальных примеров и экспертных выводов. Такой подход снижает риск ложных обвинений и укрепляет вашу позицию как создателя материала.
Тоже недавно похожее словил
И, блин, наверное, правильно, что это не было доставлено)
По переписке ниже мне утром стало ясно.
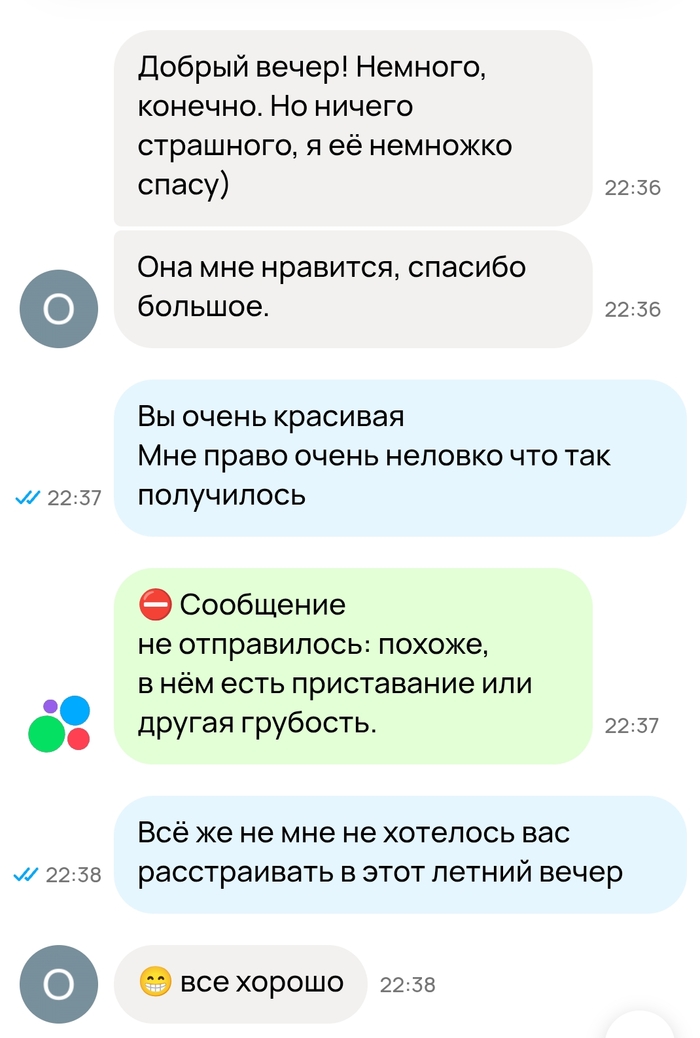
"не" дважды ошибочно написано, но смысл ясен
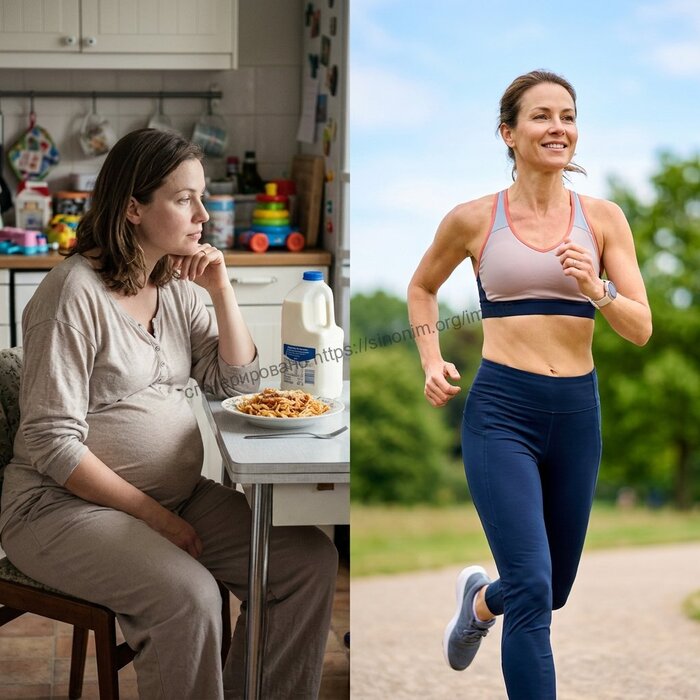
Всегда мой вес был 60–70 кг. Но на девятом месяце я уже весила 101 кг, а потом во время кормления набрала ещё. Помню: много молока и макарон — да, это была моя фатальная ошибка, но как есть.
Потом было долгое и мучительное понимание, как должно быть. И только спустя 15 лет я наконец могу дышать без одышки.
И для себя я поняла: есть один рабочий путь — спорт и соблюдение БЖУ. Всё остальное, по моему опыту, приводит к одному и тому же: срывы, постоянное «хочу есть», головная боль и так далее.
Вывод простой: никакой «волшебной схемы» нет. Либо ты берёшь ответственность и делаешь базовые вещи каждый день, либо продолжаешь ходить по кругу и надеяться на быстрый результат.
Ребята: мужчины, женщины и дети — в общем, все, кто читает мои посты!
Я тут подумала: надо сказать прямо. Я мама, прошла путь от рождения детей до воспитания подростков. Пикабу — крутая тема. Мне нравится здесь аудитория, я уже второй раз возвращаюсь и вижу, что тут реально читают.
Больше всего смеюсь с комментариев, где пишут: «да автор ИИ-шник, что-то мутит, хочет бабла срубить». Отвечу просто: все люди пытаются чего-то добиться в жизни. Многие прокачивают мозги и пишут на Пикабу — и что в этом такого? Если аудитории заходит — почему нет?
Да, кто-то использует ИИ: подчищает текст, убирает лишнее, делает картинки. Я не говорю, что я святая. Я говорю о другом: каждый пишет как хочет и публикует то, что считает нужным.
Вот я сейчас пишу исключительно свои мысли, но GPT чуть подчистил текст, поскольку не все прям идеальны в своих мыслях.
Вы не представляете, как много я хочу вам рассказать о том, как я худею. И да, кстати, мне здесь не нужны деньги от вас — если вам просто интересно, буду благодарна за любую положительную реакцию.
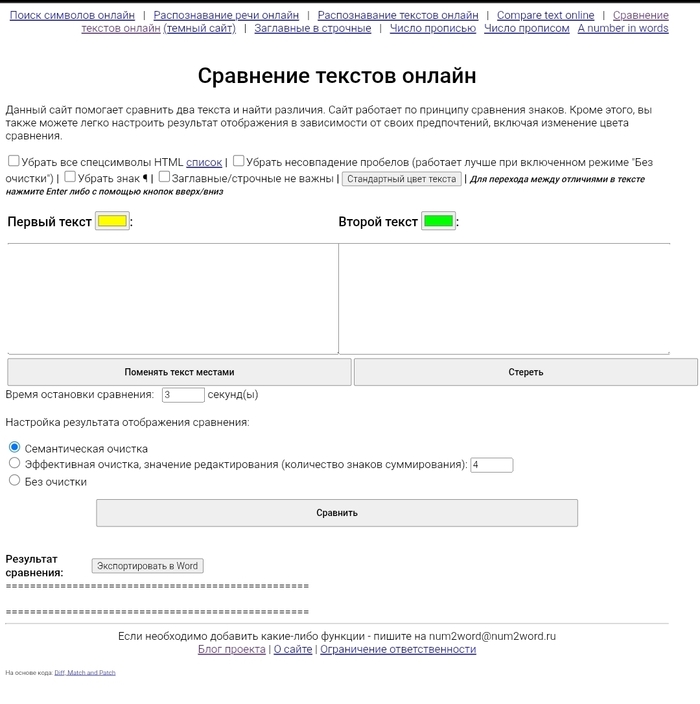
У меня есть мой любимый сайт http://text.num2word.ru/ для сравнения двух текстов, но в этом году его создали, в своём блоге написали, что они закрывают проект из-за ИИ.
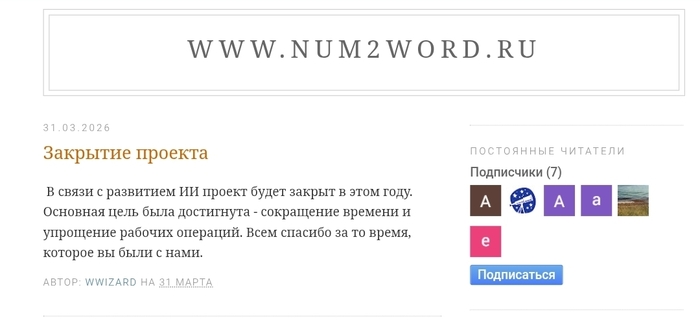
Мне нужно либо сохранить этот инструмент с сайта на компьютер, либо мне нужна абсолютно бесплатная удобная локальная программа на компьютер с тем же функционалом.
Буду рад любой помощи, и поэтому заранее спасибо!
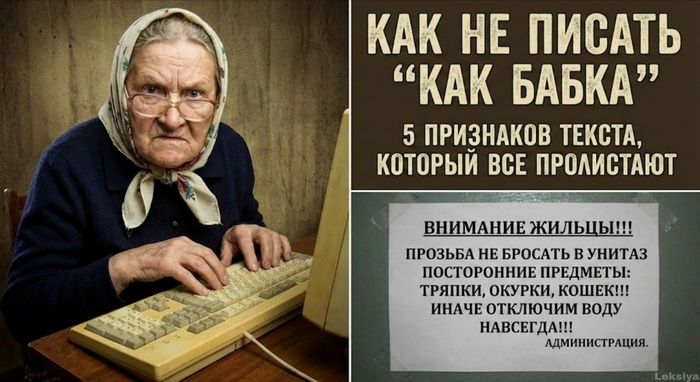
Привет, Пикабу! Я редактор, и у меня профдеформация: я не могу спокойно читать объявления в подъездах, рабочие письма и даже меню в ресторанах. Везде он — канцелярит. Это язык, который превращает живую мысль в сухой протокол.
Если вы хотите, чтобы ваши посты или письма дочитывали до конца, проверьте их на эти 5 признаков:
1. Отглагольные существительные. Самый верный способ нагнать скуку. Вместо «мы осуществляем доставку» пишите «мы доставляем». Вместо «произвели замену» — «заменили». Как только вы убираете эти тяжелые конструкции, текст начинает дышать.
2. Пассивный залог. «Договор был подписан нами» — звучит как эпитафия в юридическом отделе. «Мы подписали договор» — это жизнь и действие. В пассивном залоге нет ответственности, только уныние.
3. Водные вводные слова. «Безусловно», «таким образом», «в конечном итоге», «как бы то ни было». В 99% случаев эти слова — мусор. Удаляйте их без жалости. Если смысл предложения не изменился без «безусловно», значит, оно там не нужно.
4. Нанизывание существительных (Паровоз). Это когда пять слов в родительном падеже стоят друг за другом: «Процесс развития системы управления качеством продукции...». Пока дочитаешь до конца, забудешь, с чего начали. Разрезайте такие предложения на части или переформулируйте через глаголы.
5. Штампы и «успешный успех». «Динамично развивающаяся компания», «индивидуальный подход», «команда профессионалов». Эти фразы настолько приелись, что мозг их просто игнорирует. Напишите правду: вместо «индивидуального подхода» — «отвечаем в мессенджерах за 5 минут даже в субботу». Это работает лучше.
P.S. В комментариях кидайте свои примеры диких текстов из жизни или работы — посмеемся и разберем вместе, как их вылечить.
А если тема текстов и редактуры вам близка, заходите в мой ТГ PRO Редактор: Таблица промптов для экономии 40 часов — там я делюсь инструментами и нейросетями, которые делают всю грязную работу за нас.