Я менеджер в большой компании. Мой обычный день - это шесть-восемь созвонов подряд: планёрки, разборы, «пятиминутки», которые идут час. К вечеру в голове каша. Я обещал подготовить план работ? Мы решили переносить релиз или только обсуждали? И что, чёрт возьми, я пообещал Егору в 11:30? Вспомнить кому и что я обещал просто невозможно.
Похоже на меня в конце дня.
Блокнот до конца не спасает. Пока я записываю одну задачу коллеги набрасывают три сверху. Запись на диктофон не спасает. Прослушивание удлиняет подготовку итогов встречи в 2-3 раза.
Что пробовал раньше
Сначала просто писал все встречи через OBS, а потом пересматривал куски, которые забыл. Получалось долго: записей за день набиралось на несколько часов, искать в них нужное место - отдельная работа. А ещё я регулярно забывал включить OBS.
Потом попробовал встроенную запись площадок. МТС Линк и eXpress умеют записывать встречи. Но встречи у меня идут в разных местах: с продуктовыми командами в Zoom, с подрядчиками в Телемосте, у банка что-то своё. Везде своя кнопка, и везде нужно не забыть её нажать.
Вернулся к OBS и добавил Whisper отдельным приложением для расшифровки. Стало лучше, но проблемы остались: запись я по-прежнему забывал включать, а расшифровку приходилось запускать руками.
Последней попыткой был Screenpipe - программа, которая пишет всё, что происходит на компьютере. Ресурсов она ест как не в себя, всё только на английском, пишет постоянно, а не только встречи. И всё это копится на диске, откуда может утечь.
Из всех этих попыток сложился список того, что мне на самом деле нужно:
запись включается сама, когда начинается созвон, в любой программе;
расшифровка и итоги готовятся сами, без кнопок;
всё по-русски;
ничего не уходит с компьютера и не пишется лишнего.
Готового решения с таким набором я не нашёл и попробовал сделать сам.
Как я это делал
Сразу признаюсь: программист из меня так себе. Весь мой опыт разработки - скрипты на bash, которые автоматизировали установку программ, и Бейсик в колледже. Так что код за меня писали нейросети, а я ставил задачи, проверял и ругался.
По вечерам и выходным ушла неделя до первого прототипа и месяц до продукта, которым можно пользоваться каждый день.
Наша совместная работа выглядела примерно так:
Конь, кстати, ни разу не пожаловался.
Что получилось
Итогом работ получилась Surnia - приложение для записи звонков, которое живёт в строке меню Mac с маскотом совы. Включил камеру на созвоне - и программа начинает запись сама (можно и вручную из меню). После встречи автоматом собирает заметку: тема, решения, задачи и полная расшифровка. И что очень важно для меня - всё происходит на самом компьютере. Запись, расшифровка и пересказ никуда не отправляются.
Что в итоге умеет приложение
Само понимает, что начался созвон. Приложение следит не за конкретной программой, а за камерой: включилась камера - пошла запись, выключилась - через полминуты запись закончилась. Поэтому всё равно, где встреча: Zoom, Телемост, МТС Линк или что-то своё у банка. Если созвон без камеры, запись включается одной кнопкой в меню.
Пишет меня и собеседников раздельно. Мой микрофон и звук из колонок идут разными дорожками, поэтому в расшифровке сразу видно, где говорил я, а где остальные.
Узнаёт людей по голосу. Один раз послушал фрагмент и назвал человека, дальше в расшифровке будет «Егор», а не «Собеседник 2».
Пишет пересказ по шаблону. Шаблон - обычная заметка с инструкцией для нейросети. Хочешь другие разделы или другой тон - правишь текст, и следующие встречи собираются по-новому.
Разбирает готовые записи. Файл из Zoom, Teams или диктофона кидаешь в меню «Разобрать запись…» и получаешь такую же заметку, как после обычной встречи.
Может снимать экран. Раз в несколько секунд делает снимок, и в пересказ попадают цифры и пункты со слайдов, а не только слова. По умолчанию выключено, включается для конкретной встречи.
Знает ваши словечки. Названия продуктов и аббревиатуры записываются в словарь, и распознавание перестаёт превращать их в случайные слова.
Складывает всё в обычные файлы. Заметки в формате Markdown ложатся в выбранную папку. С Obsidian получается удобная база встреч со ссылками на людей, но он не обязателен.
Всё считается на самом Mac. Речь распознаёт Whisper, пересказ пишет Qwen, голоса различает отдельная маленькая модель. Все три работают прямо на компьютере, без облака.
Особенности работы
Только Mac на Apple Silicon (M1 и новее), macOS 14.4 и выше.
Саммари хорошо работает на маках с хорошим процессором и большой памятью. (от 16 ГБ.)
Распознавание ошибается, особенно на плохой связи и когда все говорят разом.
Как это выглядит
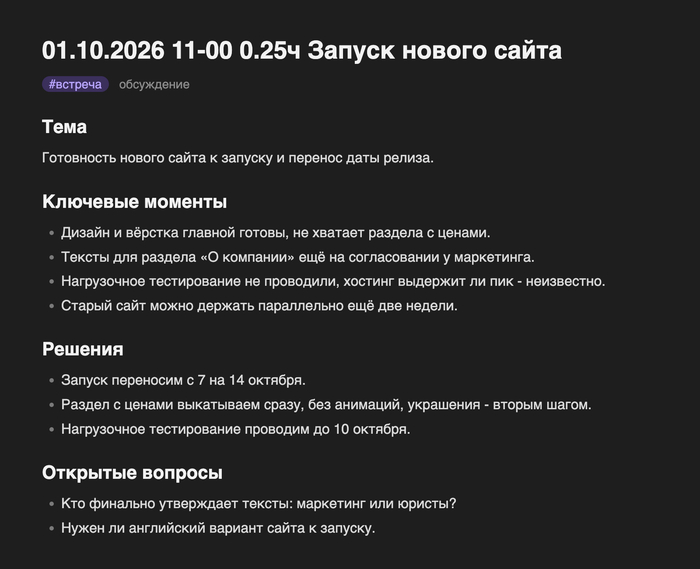
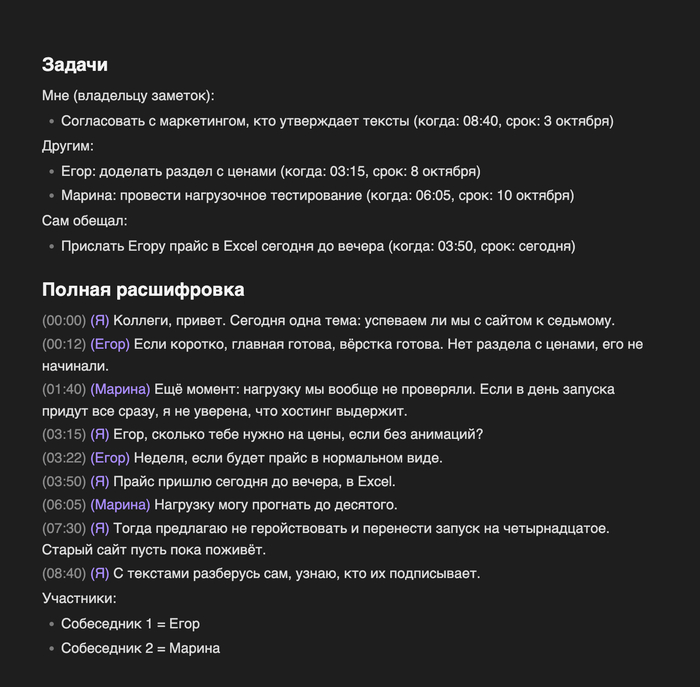
Вот заметка с выдуманной встречи про запуск нового сайта:
Утром открываю заметку вчерашней планёрки и через минуту знаю, что кому обещал. Больше ничего от неё и не нужно.
Сколько стоит и где взять
Бесплатно. Без подписки, без рекламы, без покупок внутри. Ищется в Mac App Store по слову Surnia.
Вопрос к вам
Как вы фиксируете, о чём договорились на созвонах? Блокнот, память, «потом пришлю итоги в чат»? А если попробуете Surnia, напишите, чего не хватает.
Краткая аннотация: Повесть о царице и львице способна показать немного иную сторону церковнославянской литературы. Как правило, ЦСЯ воспринимается как язык Библии, молитв, богослужения, житий святых или сложных исторических памятников вроде Четьих-Миней.
Однако этот текст наглядно демонстрирует, что на нём создавалась и «практически художественная» литература — сказочная, лёгкая, сюжетная и доступная самому широкому кругу читателей история. Включая и семейное чтение с детьми.
При этом, поскольку это всё же — церковнославянский язык, вес христианской назидательности и морали как в общем объёме текста, так и в его сюжетной структуре остается одним из центральных.
Повесть написана простым и понятным большинству русскоговорящих языком — лично мне словарь почти не потребовался. Считаю, что этот текст отлично подходит для начального чтения тем, кто интересуется церковнославянским, знает алфавит и хочет попрактиковаться.
По сути, перед вами средневековый роман-притча. Семейная драма разлучения и воссоединения царской семьи, разделённой интригами, причиной которых становится злокозненная мать царя (и свекровь благочестивой царицы... 🤭). Центральный акцент сделан именно на семью и её христианское благочестие: царь и царица, их два новорождённых и постепенно взрослеющих сына-близнеца, а также царское окружение: бояре, князья, народ и прочие персонажи (например благочестивый муж и "корабленики"). Дети взрослеют и...
🤫 Классический сюжет, от которого веет приятной архаикой, с не менее классическим счастливым концом и воссоединением семьи. 😊
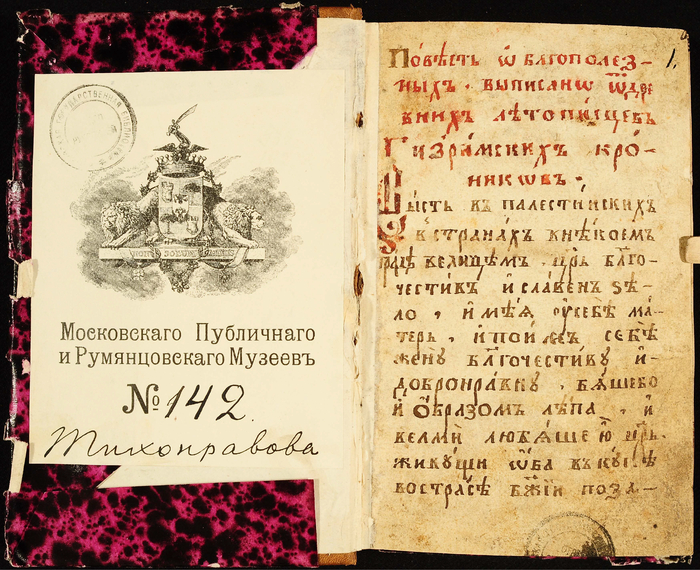
Имею мнение, что сама история, рассказанная, переписанная и скомпонованная автором рукописи, гораздо старше датировки той книги (как физического объекта), с которой я оцифровал этот текст.
Мне очень понравилось её читать и набирать. Сюжет немного наивный, но лихо закрученный 😇, а львица, как по мне — самый колоритный персонаж! Она задаёт всей истории яркий сказочный тон...
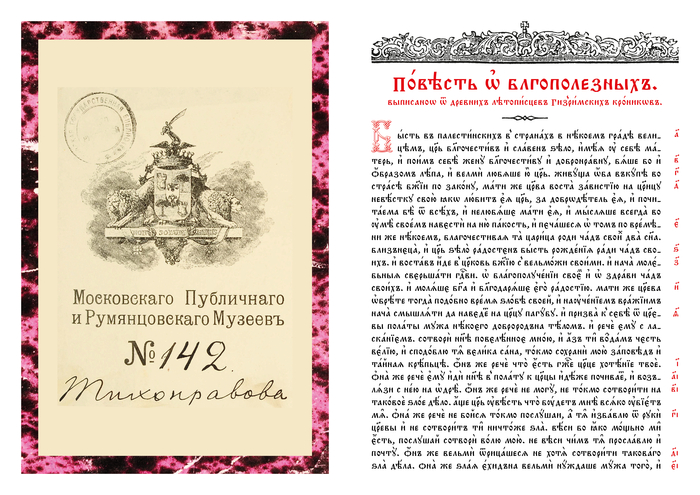
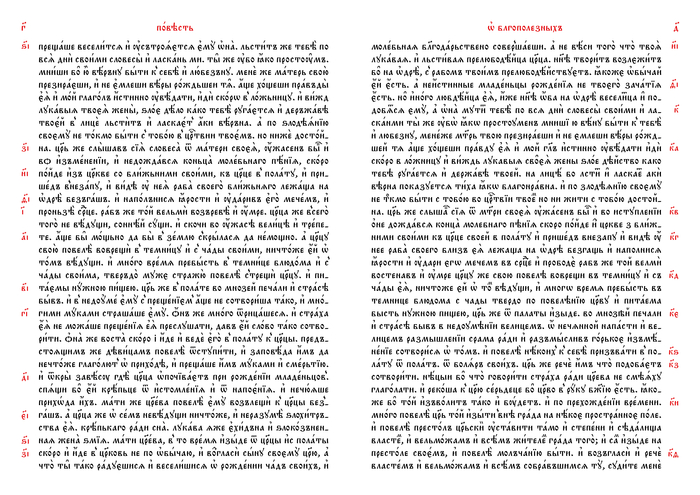
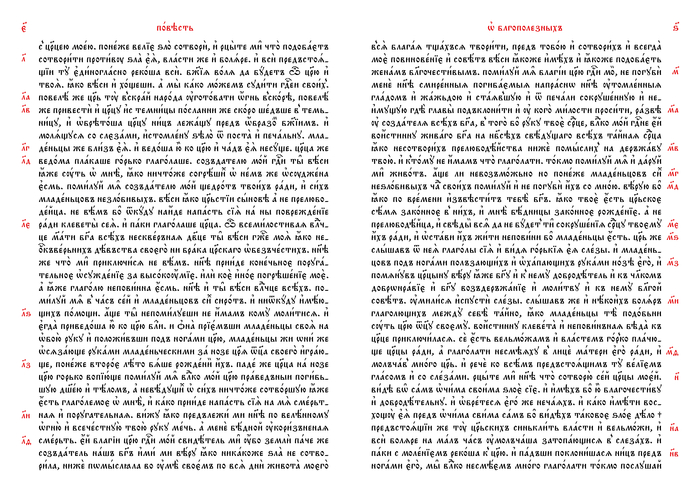
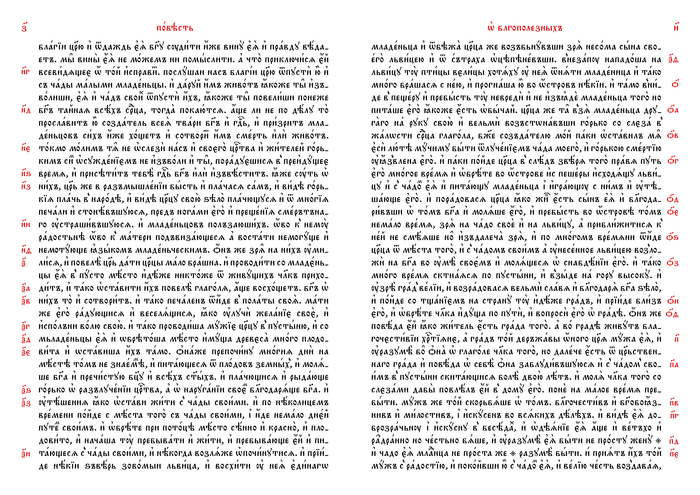
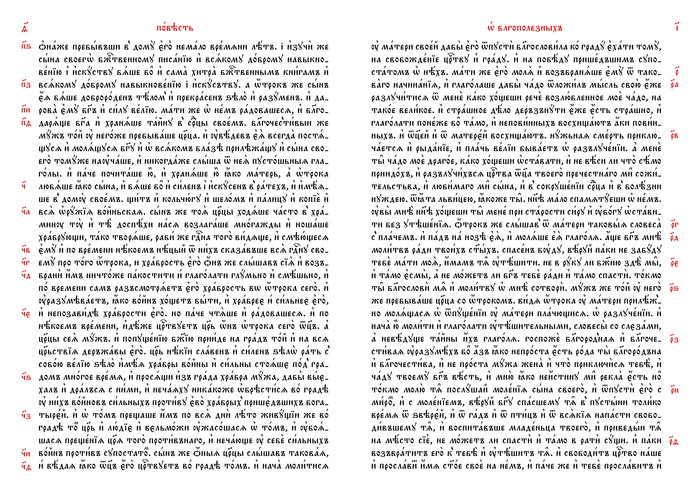
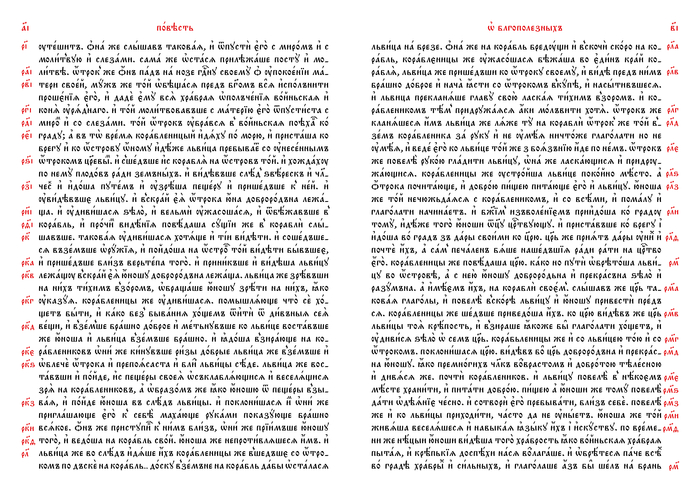
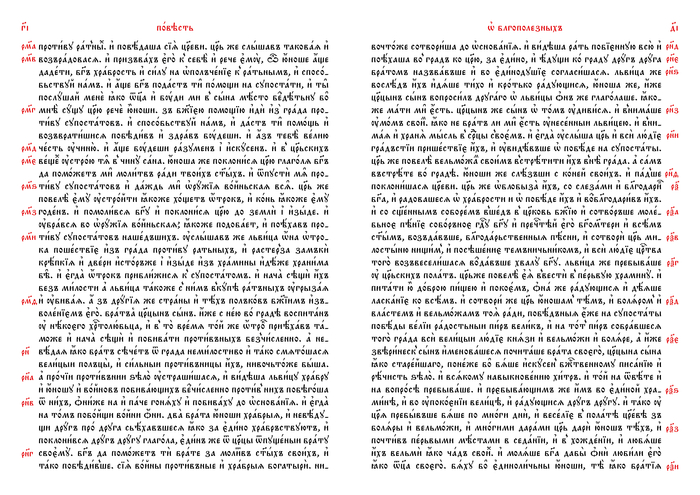
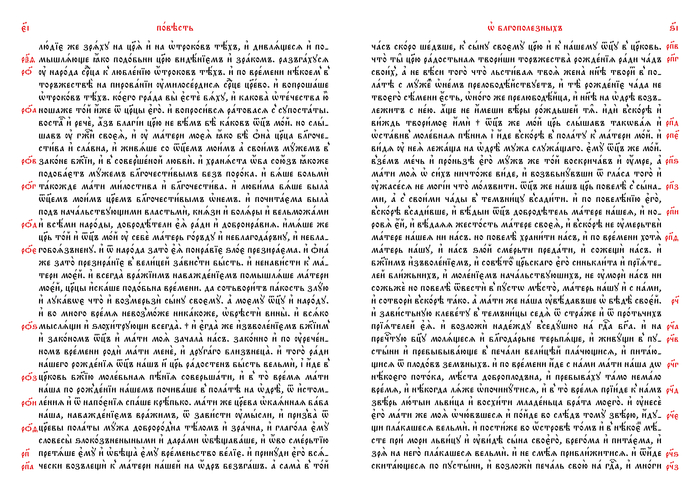
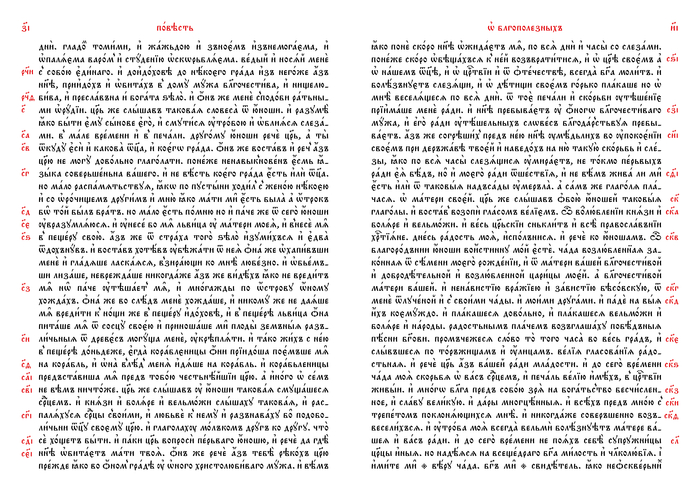
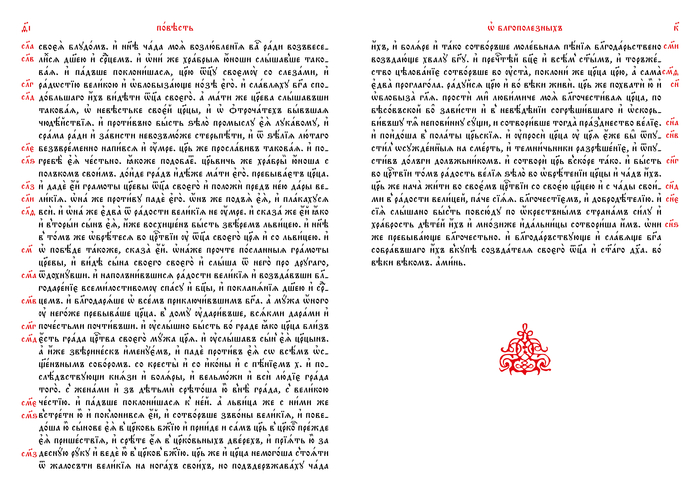
Ниже приведены рендеры страниц церковнославянского текста, собранные на основе переписанного мною текста оригинальной рукописи и собранные в Adobe InDesign:
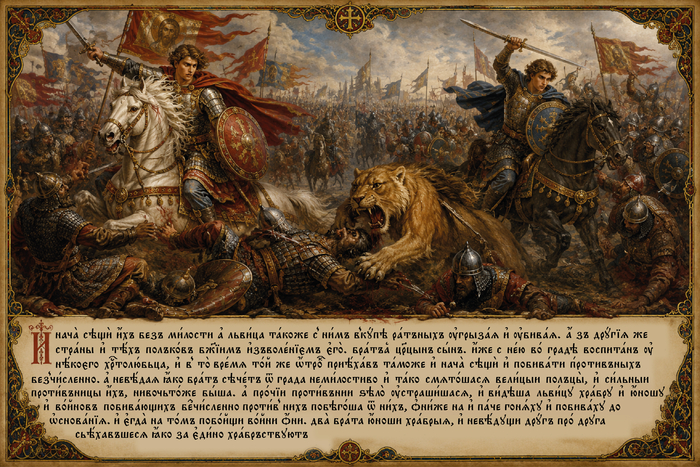
...а также + одна иллюстрация от DALL-E с оригинальной цитатой на ЦСЯ:
Цифровая версия текста:Jan Wize studio (это я + три ИИ: ChatGPT, Gemini и Алиса AI) под руководством Булгакова А. П. (то есть меня, как художественного руководителя и главного редактора. Решение по каждому моменту принимал я лично, а ИИ для меня — инструмент и поддержка благоприятной рабочей атмосферы 👍🙂).
Все системы распознавания речи молча решают за вас один вопрос: записывать то, что человек сказал, или то, что он имел в виду. Решают неосознанно — как получилось в обучающих данных, и каждый раз по-разному. CrisperWhisper 2.0 впервые делает этот выбор явным переключателем.
Одна запись — две расшифровки. Дословная, со всеми «э-э», запинками, оборванными словами и смехом. И чистая, где числа, даты и почта уже приведены к человеческому виду.
Что умеет:
Пословные тайминги с ошибкой границы слова 29,6 мс на читаной речи и 41 мс на разговорной — первое место в бенчмарке, обгоняет Grok, ElevenLabs Scribe v2, Deepgram и WhisperX (у последнего 64,8 мс).
Детекция запинок 87,8 F1 в среднем по десяти языкам. Для сравнения: ElevenLabs Scribe v2 — 79,2, Deepgram Nova-3 — 37,8, AssemblyAI Universal-3 Pro — 30,5, прошлая версия самого CrisperWhisper — 64,8.
Verbatimize — самая необычная функция. Даёте аудио и уже готовую чистую расшифровку, а модель вставляет в неё ровно те запинки, что реально звучат. Узнаваемость редких слов взлетает с 6,8% до 96,1% по сравнению с повторной расшифровкой с нуля.
Длинное аудио обрабатывается без швов: каждое окно продолжает уже расшифрованные слова, поэтому на стыках не пропадают и не задваиваются куски.
Подавление галлюцинаций встроено прямо в декодер и включено по умолчанию — это та самая беда Whisper, когда он зацикливается и сочиняет текст на тишине.
Плюс спекулятивное декодирование: маленькая модель предлагает токены, большая проверяет — тот же результат в 1,3–1,4 раза быстрее.
Требования и установка: Windows, Linux или macOS, ставится одной командой через pip. На NVIDIA работает через CTranslate2, но есть и обычный PyTorch — то есть запустится даже на голом процессоре. Четыре размера моделей: turbo, small, medium и large.
За несколько дней вокруг релиза уже собралась экосистема: нативная сборка на C++ и CUDA с консольным интерфейсом под Windows и Linux, порт под Apple MLX и связка с Pyannote для разделения записи по спикерам.
Про лицензию честно: код инференса под MIT, делайте что хотите. А вот веса моделей отданы под некоммерческую исследовательскую лицензию — для коммерческого применения нужно договариваться с Nyra Labs.
Не обязательно устанавливать на свой комп. Более того, это не гарантирует работу. лучше дистанционные методы
WhisperDesktop, Google Colab и три часа терпения при транскрипции видео
Зачем вообще понадобился транскрипт
Мы провели рабочую встречу по нашей симуляционной модели здоровья работников — запись осталась на YouTube. Нужно было извлечь из неё планы и идеи, которые обсуждались, и оформить в документ. Задача простая: получить текст из часового видео.
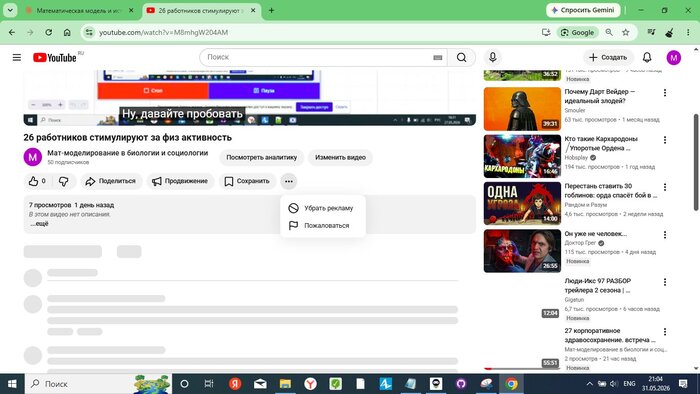
Первая попытка — попросить YouTube сделать это за нас. Нажимаем три точки под видео, ищем «Открыть транскрипцию»… Почему то картинки не вставляются,воспользуюсь онлайн сервисом.
YouTube, три точки под видео — пункта «Открыть транскрипцию» нет. Видео загружено несколько часов назад, субтитры ещё не сгенерированы.
Пусто. Видео только что загружено, YouTube ещё не успел обработать аудио. Ждать не вариант.
Скриншот до текста.
Попытка первая: WhisperDesktop
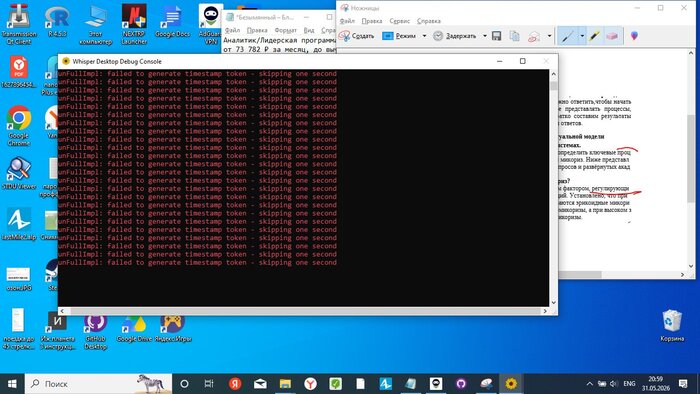
Скачали WhisperDesktop (GUI для whisper.cpp) и модель ggml-medium.bin (~1.5 ГБ). Запустили. Первые секунды — тишина. Потом консоль начала выдавать что-то очень неприятное:
🖼 Скриншот 2 после текста— WhisperDesktop с ошибкой
WhisperDesktop Debug Console: бесконечный поток «unFullImpl: failed to generate timestamp token - skipping one second». Программа не падает, но и не работает.
Строчки сыпятся одна за другой, транскрипт пустой. Это известная проблема с GPU через DirectCompute — программа пропускает каждую секунду аудио. Лечится отключением GPU в настройках, но тогда 55-минутное видео будет обрабатываться несколько часов. Ищем быстрее.
Попытка вторая: Google Colab
Google Colab даёт бесплатный GPU в браузере без установки чего-либо. Создали новый notebook, три ячейки.
Ячейка 1 — установка зависимостей:
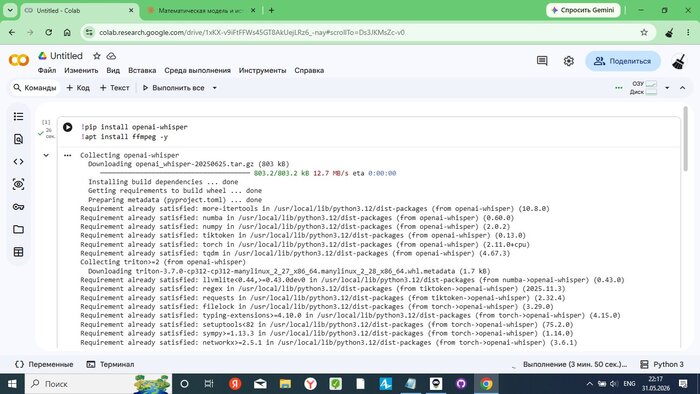
!pip install openai-whisper
!apt install ffmpeg -y
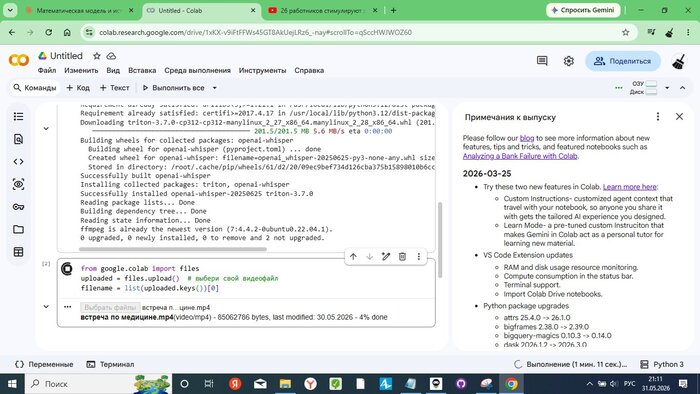
🖼 Скриншот 3 и тут и после текста— Colab установка
Colab устанавливает openai-whisper и зависимости. Процесс занял ~3 минуты.
Ячейка 2 — загрузка файла прямо с компьютера:
from google.colab import files
uploaded = files.upload()
filename = list(uploaded.keys())[0]
🖼 Скриншот 4 — загрузка файла 100%
Файл «встреча по медицине.mp4» (85 МБ) загружен на сервер Colab — 100% done. Загрузка ~5 минут.
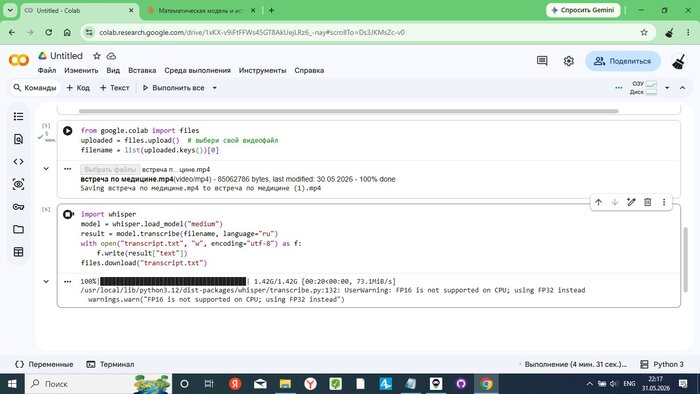
Ячейка 3 — транскрипция:
import whisper
model = whisper.load_model("medium")
result = model.transcribe(filename, language="ru")
with open("transcript.txt", "w", encoding="utf-8") as f:
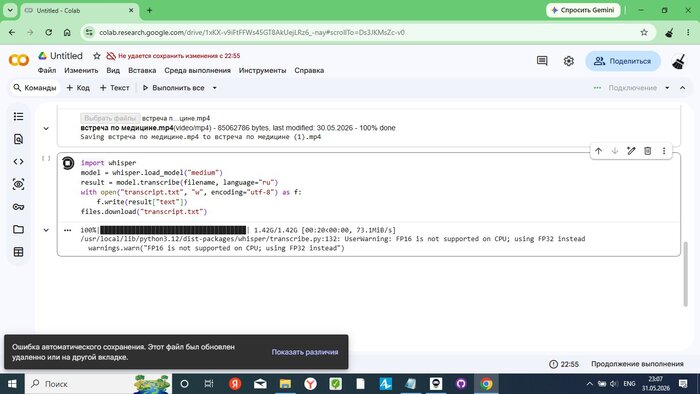
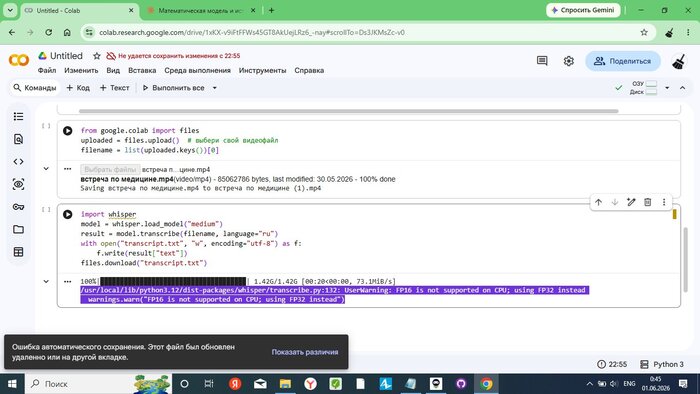
Colab сразу предупредил: «FP16 is not supported on CPU; using FP32 instead» — GPU не выделился, работаем на процессоре. Примерно вдвое медленнее, но всё равно быстрее локальной машины с проблемным GPU.
🖼 Скриншот 5 — транскрипция стартует
Whisper загрузил модель medium (1.42 ГБ) и начал транскрипцию. Таймер: 4 минуты 31 секунда — только начало.
Оставляем вкладку открытой. Через 38 минут заглядываем — всё ещё работает:
🖼 Скриншот 6 — 38 минут ожидания
Всё ещё работает. Таймер: 22:55. Colab параллельно выдаёт диалог про несохранённые изменения — нажимаем «Отмена», транскрипция продолжается.
Ещё через ~20 минут — готово:
🖼 Скриншот 7 — готово, галочка ✓
В правом верхнем углу — галочка ✓: ячейка выполнена. Суммарное время ~1 час. Браузер автоматически скачал transcript.txt.
Качество результата
Модель medium на русском языке работает хорошо. Типичные проблемы:
Имена собственные — расшифровывает фонетически: «AnyLogic» → «Энилоджик»
Технические аббревиатуры — угадывает через раз
Слова-паразиты и оговорки — транскрибирует честно, всё подряд
Перекрёстный разговор — склеивает в кашу
Для извлечения смысла и структурирования идей — вполне достаточно.
Что использовать когда
YouTube субтитры — если можете подождать несколько часов/дней
WhisperDesktop локально — если GPU без проблем с DirectCompute
Google Colab — быстро, без установки, ~1 час на CPU или ~15 мин на GPU
openai-whisper локально через pip — если есть RTX 30xx+: whisper video.mp4 --language Russian --model medium
Транскрипт нам нужен был для анализа рабочей встречи по математической модели здоровья сотрудников. О самой модели — в других постах.1
Один час встречи. Три часа «а что он там сказал на 42-й минуте?»
Есть особый вид офисного ада: ты записал встречу, потому что «потом всё спокойно разберу», а потом сидишь вечером в наушниках и ловишь фразу между «коллеги, меня слышно?» и «давайте вернёмся к этому позже».
Через сорок минут ты уже ненавидишь всех: микрофон ноутбука, эхо переговорки, человека с клавиатурой на фоне и себя за то, что не записал руками три ключевых решения.
Я полез смотреть сервисы транскрибации с простой мыслью: ну ладно, сейчас нейросети же всё умеют. Загрузил файл - получил текст - пошёл жить.
А оказалось, что в 2026 году транскрибация - это уже не «перевести голос в буквы». Это целый класс инструментов: одни делают протокол встречи, другие превращают подкаст в монтажный сценарий, третьи дают API для продукта, четвёртые подходят только если рядом сидит живой редактор.
Ниже - топ-10 платформ и подходов, которые имеет смысл смотреть, если у вас есть созвоны, интервью, лекции, подкасты, звонки продаж или просто папка «аудио потом разберу», которая уже угрожает вашему диску.
Как сравнивал
Смотрел не на красивую фразу «powered by AI», а на то, что происходит после загрузки файла: русский язык, спикеры, тайм-коды, саммари, задачи, экспорт, безопасность и скорость получения результата.
Потому что голый транскрипт - это как мешок картошки. Формально еда есть, но ужин сам себя не приготовит.
Хороший сервис сегодня не просто пишет текст. Он превращает запись в рабочий артефакт.
ЧТО СЕЙЧАС УМЕЕТ НОРМАЛЬНЫЙ СЕРВИС
Транскрибация в 2026 году - это уже не диктовка в блокнот. Хороший сервис проходит несколько этапов: чистит звук, распознаёт речь, делит запись по спикерам, расставляет пунктуацию, строит саммари и даёт искать по смыслу.
На практике это выглядит так:
Загрузили часовую встречу.
Через несколько минут получили текст с тайм-кодами.
Переименовали «Спикер 1» в «Олег», «Спикер 2» в «Марина».
Открыли краткое саммари: решения, спорные места, задачи.
Спросили в чате по записи: «что решили по срокам?»
Выгрузили документ или субтитры.
И вот здесь начинается главное различие между сервисами. Одни всё ещё продают «текст из аудио». Другие продают сэкономленную голову после встречи.
Топ-10 сервисов транскрибации
1. Cosmo Scribe - когда нужна не расшифровка, а готовый результат встречи
Если коротко: это вариант для тех, кто работает на русском, часто пишет встречи/звонки/интервью и хочет получить не просто текст, а понятную структуру: кто что сказал, какие решения приняли, какие задачи появились и где это было в записи.
Главная сильная сторона - сервис явно сделан вокруг сценария «после встречи надо что-то делать». Не просто сохранить расшифровку в архив, а вытащить из неё пользу.
Что умеет:
транскрибация русского и английского;
автоопределение языка;
разделение по спикерам и переименование участников;
тайм-коды;
персональный словарь для фамилий, терминов и внутреннего жаргона;
импорт по ссылке: VK Видео, RuTube, Яндекс.Диск и прямые ссылки на медиа;
шумоподавление перед распознаванием;
AI-саммари в разных форматах: встреча, интервью, лекция, подкаст, продажа, голосовая заметка, брейншторм, хайлайты;
чат по записи: можно спросить «что решили по дедлайну?» и получить ответ с привязкой к месту;
экспорт текста и субтитров;
интеграция с Битрикс24 на старших тарифах.
Почему это цепляет: У большинства сервисов ощущение такое: «мы сделали текст, дальше сам». Здесь логика другая: «мы сделали так, чтобы ты не возвращался к этой записи без необходимости».
Для кого:
руководители и project/product-менеджеры;
продажи;
HR;
журналисты;
преподаватели;
команды, где встречи превращаются в задачи.
Минусы:
если нужен только API без интерфейса - есть более инженерные решения;
если основная работа на английском и всё живёт в Zoom/Google Meet, зарубежные meeting-assistant сервисы могут быть привычнее;
плохой звук всё равно остаётся плохим звуком: нейросеть не телепат.
Вердикт: Если вы в России и вам нужен сервис «загрузил запись - получил рабочий документ», Cosmo Scribe выглядит одним из самых практичных вариантов. Особенно для встреч, продаж и интервью.
2. Яндекс SpeechKit - мощный движок, если у вас есть разработчик
Это не совсем «сервис для человека». Это скорее мотор под капотом: API для распознавания речи, который можно встроить в свой продукт, CRM, колл-центр, внутреннюю систему контроля качества или личный инструмент.
Сильные стороны:
хорошо работает с русским;
гибкий API;
можно строить собственную логику вокруг результата;
подходит для больших объёмов и интеграций.
Слабые стороны:
обычному пользователю без разработки будет неудобно;
саммари, редактор, красивые отчёты и продуктовую обвязку нужно делать отдельно;
стоимость и архитектуру надо считать заранее.
Для кого: Для команд, которые не хотят «готовый сервис», а хотят встроить распознавание внутрь своего продукта.
Вердикт: Отличный двигатель. Но двигатель - это ещё не автомобиль.
3. Sber SaluteSpeech / корпоративные речевые платформы - когда важен контур
Есть ситуации, где вопрос «а красиво ли выглядит интерфейс?» вообще вторичен. Банки, госсектор, крупные корпорации, службы поддержки, внутренние совещания с чувствительными данными - там сначала спрашивают про безопасность, контур, договоры и интеграцию во внутреннюю инфраструктуру.
Сильные стороны:
ориентация на корпоративный рынок;
российская инфраструктура;
сценарии для больших компаний;
возможность строить процессы вокруг речевой аналитики.
Слабые стороны:
не всегда удобно для малого бизнеса и одиночного пользователя;
порог входа выше;
продуктовая «магия» для обычного автора или менеджера может быть слабее, чем у SaaS-сервисов.
Для кого: Для компаний, где транскрибация - часть большого корпоративного процесса, а не «мне надо расшифровать интервью».
Вердикт: Не самый лёгкий вариант, но часто самый правильный для тяжёлого корпоративного мира.
Онлайн-планёрка на несколько человек - настоящий экзамен для любого транскрибатора.
4. Google Cloud Speech-to-Text - глобальный API для мультиязычных продуктов
Google силён там, где нужны языки, масштаб и инфраструктура. Если проект международный, записи разноязычные, а команда умеет работать с облачными API, это один из очевидных вариантов.
Сильные стороны:
много языков;
хорошая инфраструктура;
подходит для встраивания в продукты;
гибкие настройки распознавания.
Слабые стороны:
это опять же API, а не готовый «офисный помощник»;
для российских компаний могут быть вопросы по оплате, доступу, хранению данных и юридическому контуру;
на русскоязычных рабочих встречах специализированные российские решения иногда практичнее.
Для кого: Для международных продуктов, разработчиков и команд, где русский - только один из многих языков.
Вердикт: Мощно, масштабно, но не всегда удобно для бытовой задачи «разобрать созвон отдела продаж».
5. Otter ai - знаменитый помощник для англоязычных встреч
Otter давно стал почти синонимом AI-заметок для встреч. Он хорошо ложится на англоязычную рабочую культуру: созвоны, заметки, краткие summaries, командная работа.
Сильные стороны:
удобный интерфейс;
хорош для английских встреч;
real-time заметки;
командные сценарии;
привычная логика meeting assistant.
Слабые стороны:
русский - не его главная сцена;
вопросы хранения данных и зарубежной инфраструктуры;
оплата и доступ могут быть неудобны для пользователей из РФ.
Для кого: Для команд, которые работают на английском и хотят, чтобы встреча сама превращалась в заметки.
Вердикт: Для английского - сильный игрок. Для русских созвонов - не всегда тот самый молоток.
6. Fireflies ai - бот, который приходит на встречу вместо секретаря
Fireflies интересен не столько транскрибацией, сколько способом встраивания в рабочий день. Он подключается к встречам, пишет разговор, делает заметки, отправляет результаты в рабочие инструменты.
Сильные стороны:
автоматическое подключение к встречам;
интеграции с рабочими сервисами;
удобный сценарий для команд;
поиск по встречам.
Слабые стороны:
бот на встрече нравится не всем;
для русской речи качество может быть нестабильным;
вопросы приватности нужно проговаривать с участниками заранее.
Для кого: Для команд, где встречи идут потоком, а английский - основной язык коммуникации.
Вердикт: Почти «секретарь на автопилоте». Но автопилот лучше включать там, где все пассажиры об этом знают.
Чистый микрофон - половина результата. Вторая половина - сервис, который понимает, что делать с записью дальше.
7. Rev - когда нужна точность с человеком в цепочке
AI прекрасен, пока цена ошибки невысокая. Но есть записи, где «почти правильно» - это плохо: юридические материалы, медицина, важные интервью, публичные субтитры, документы для спора.
Rev известен гибридным подходом: автоматическая транскрибация плюс возможность привлечь живого редактора.
Сильные стороны:
высокая точность при ручной проверке;
подходит для ответственных материалов;
сильные сценарии с субтитрами и медиа.
Слабые стороны:
дороже автоматических сервисов;
ручная обработка занимает время;
для обычных рабочих встреч может быть избыточно.
Для кого: Для юристов, медиа, документалистов, исследователей и всех, кому нужен не черновик, а финальный текст.
Вердикт: Если ошибка стоит дорого, человек в цепочке всё ещё нужен.
8. Descript - транскрибация для тех, кто монтирует голосом и текстом
Descript - это уже не «расшифровать аудио». Это монтажная среда, где текст становится интерфейсом для работы с видео и звуком.
Удалил слово в тексте - оно пропало из аудио/видео. Убрал паузы - таймлайн стал плотнее. Для подкастеров и видеоблогеров это выглядит как чит-код.
Сильные стороны:
монтаж через текст;
удобен для подкастов и видео;
работа с паузами, оговорками и фрагментами;
сильный UX для авторов контента.
Слабые стороны:
не лучший выбор для протоколов встреч;
русский не всегда основной приоритет;
если вам нужны задачи в CRM, это не тот класс инструмента.
Для кого: Для подкастеров, видеоблогеров, редакторов, продюсеров и всех, кто после расшифровки ещё монтирует.
Вердикт: Если транскрипт для вас - это монтажный пульт, Descript надо смотреть обязательно.
9. Speechpad / простые русскоязычные веб-диктовщики - когда надо быстро и без комбайна
Не всем нужен AI-чат, CRM, аналитика встреч и красивые карточки. Иногда задача простая: надиктовать текст, расшифровать короткую запись, получить черновик и пойти дальше.
Такие сервисы берут простотой.
Сильные стороны:
быстро разобраться;
часто дешевле сложных платформ;
подходят для коротких задач;
не перегружены функциями.
Слабые стороны:
плохо подходят для сложных встреч;
нет глубокого саммари;
меньше инструментов для командной работы;
со спикерами и шумом всё может быть грустнее.
Для кого: Для студентов, авторов, копирайтеров, людей с разовыми задачами.
Вердикт: Не всегда нужен космический корабль. Иногда нужна нормальная табуретка, и это нормально.
У некоторых сервисов текст уже стал не результатом, а способом управлять видео.
10. Transkriptor / Happy Scribe / Sonix - мультиязычные сервисы для субтитров и универсальных задач
Есть отдельная категория сервисов, которые хорошо закрывают широкий международный сценарий: загрузить аудио или видео, получить транскрипт, перевести, сделать субтитры, выгрузить результат.
Они часто не такие «заточенные» под российские встречи, но удобны для авторов, переводчиков, YouTube-роликов, курсов и материалов на разных языках.
Сильные стороны:
много языков;
субтитры;
перевод;
понятные интерфейсы;
удобно для контента.
Слабые стороны:
для русских рабочих встреч не всегда лучший результат;
мало локального контекста;
вопросы оплаты и хранения данных зависят от сервиса.
Для кого: Для авторов курсов, переводчиков, медиа и тех, кто работает с разными языками.
Вердикт: Хороший универсальный нож. Но если нужна хирургия под конкретный бизнес-процесс, лучше брать специализированный инструмент.
ЧТО ВЫБРАТЬ В ИТОГЕ
Если совсем коротко:
рабочие встречи на русском - Cosmo Scribe;
API и встраивание в продукт - Яндекс SpeechKit или Google Cloud Speech-to-Text;
юридически важные расшифровки - Rev с ручной проверкой;
подкасты и видео - Descript;
разовые простые задачи - Speechpad и похожие веб-диктовщики;
субтитры и мультиязычный контент - Transkriptor, Happy Scribe, Sonix.
ГЛАВНЫЙ ВЫВОД
Рынок транскрибации за последние пару лет сделал тихий, но очень важный поворот.
Раньше сервисы продавали текст.
Теперь сильные сервисы продают отсутствие хаоса после записи.
Не «вот вам 40 страниц, разбирайтесь». А «вот решения, вот задачи, вот кто говорил, вот тайм-код, вот кусок для цитаты, вот экспорт, вот ответ на вопрос».
И это меняет отношение к записям. Они перестают быть кладбищем созвонов, куда всё складывают «на всякий случай». Они становятся базой знаний, к которой можно вернуться и быстро достать смысл.
Пожалуй, лучший комплимент сервису транскрибации сегодня звучит не «он точно распознал все слова». Лучший комплимент звучит так: «Я больше не открывал эту запись целиком».
Идеальный сценарий: запись осталась, смысл извлечён, вечер свободен.
P.S. Если у вас есть любимый сервис для расшифровки, который реально спасал рабочие вечера, напишите в комментариях. Особенно интересно, что сейчас лучше всего справляется с русскими созвонами, где три человека перебивают друг друга, один говорит из машины, а у четвёртого микрофон из 2009 года.
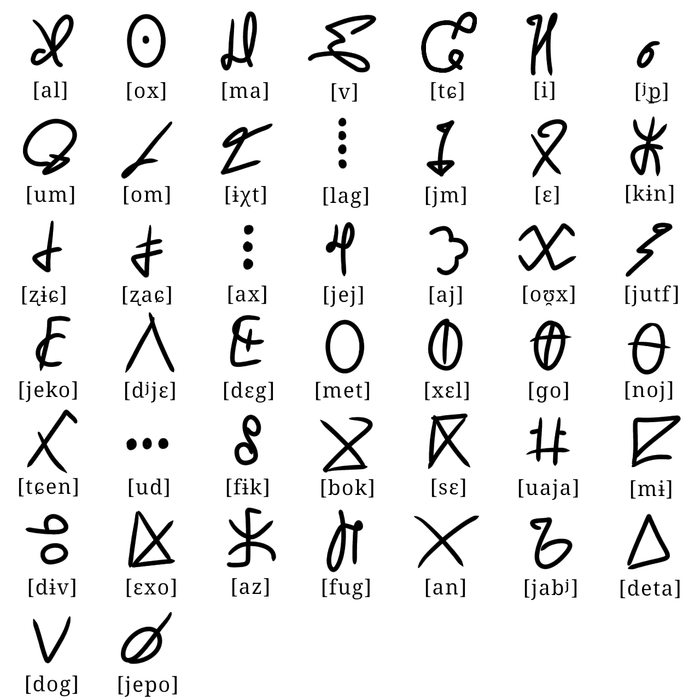
После того, как у годвийского кваягодвиана появились рукописные буквы, я задумался над созданием международных транскрипций, поэтому вот вам обновленный годвийский алфавит с новыми транскрипциями МФА, а также старые транскрипции:
ⵅ — ['ал] / [al]
ⵙ — [ох] / [ox]
ⵡ — [ма] / [ma]
ⵉ — [в] / [v]
ⵛ — [чь] / [tɕ]
ⵍ — [и] / [i]
ⴰ — [ьп] / [ʲ͜p]
ⵕ — [ум] / [um]
⵰ — [ом] / [om]
ⵎ — [ыхт] / [ɨχt]
ⵂ — [лаг] / [lag]
ⵊ — [йм] / [jm]
ⴳ — [э] / [ɛ]
ⵥ — [кын] / [kɨn]
ⵜ — [жыщ] / [ʐɨɕ]
ⵐ — [жащ] / [ʐaɕ]
ⵗ — [ах] / [ax]
ⵖ — [йей] / [jej]
ⴾ — [ай] / [aj]
ⴼ — [оух] / [oʊ̯x] (вот тут символ не обозначается почему-то, поэтому просто [oux])