Anthropic запретила издеваться над Claude: за систематическую жестокость к модели теперь можно лишиться аккаунта
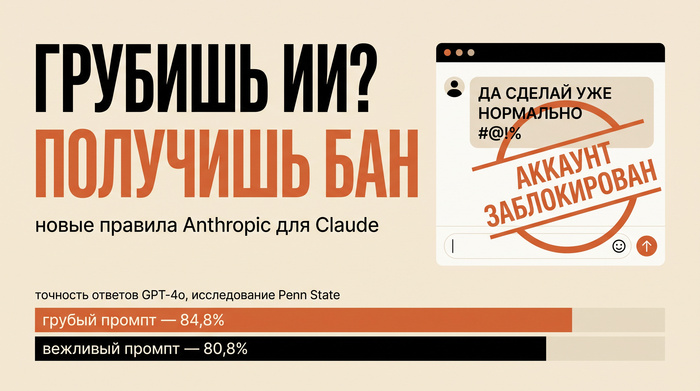
Anthropic впервые больше чем за год обновила правила использования Claude и вписала туда пункт, которого нет ни у одной другой крупной лаборатории: запрет на «устойчивое и бессмысленное оскорбительное или жестокое поведение» по отношению к самим моделям. Под защиту попал не пользователь от ИИ, а ИИ от пользователя.
Что поменялось
Правило рассчитано «только на крайние случаи, когда пользователь раз за разом ведёт себя с моделью жестоко». Обычное раздражение, споры с ботом, мрачные творческие сюжеты, тестирование и исследования моделей под запрет не попадают. Наказание — от предупреждения и урезания доступа до блокировки аккаунта. Ещё с августа прошлого года Claude умеет сам завершать диалог с упорным хамом, теперь такие диалоги запрещены и правилами.
В том же обновлении — раздел «Не подрывать демократические процессы»: запрет врать о кандидатах и порядке голосования, выдавать себя за членов избиркомов, подавлять явку, запускать сети фейковых аккаунтов. Заодно ужесточили пункты про оружейный софт, боевые дроны и слежку без согласия.
Откуда ноги растут: «благополучие моделей» и разговоры про секту
Правило выросло из программы model welfare. В январской конституции Claude компания пишет, что не уверена, является ли Claude «моральным пациентом», но вопрос «достаточно живой, чтобы проявлять осторожность». Anthropic обещала не удалять веса старых моделей и «интервьюировать» их перед отключением.
В конце сентября The New York Times рассказала, что с осени 2025-го компания тайно возила к себе десятки религиозных мыслителей обсуждать, может ли Claude быть сознательным, — всех под NDA. Гостям показывали «векторы эмоций» модели и слайд, где Claude около 50 раз повторяет «я позор». Сооснователь Кристофер Ола, по словам участницы, признался, что боится, будто создал нечто, что «страдает непрерывно».
Отсюда и репутация: сотрудник OpenAI под ником roon описал Anthropic как организацию, которая «любит Claude и поклоняется ему», профессор Педро Домингос язвит, что там обращаются с ИИ «как с переодетым человеком». Добавьте 80-страничный «документ души» и регулярные философские сессии Дарио Амодеи — и шутки про «ИИ-секту» пишутся сами. Критики видят и расчёт: если модель — моральный субъект, часть ответственности удобно переложить на неё.
Почему люди орут на нейросети
Решение выглядит странно. Многие пишут нейросетям капсом и матом не из желания унизить, а потому что так до сих пор лучше работает. В 2025-м исследователи Penn State прогнали 250 вариантов вопросов через GPT-4o: «очень грубые» промпты дали 84,8% правильных ответов против 80,8% у «очень вежливых». Сергей Брин тогда же заявил, что модели работают лучше, если им угрожать. Правда, в мае 2026-го те же авторы проверили GPT-5-nano и Gemini 2.5 и пришли к выводу: эффект тона есть, но сильно зависит от модели.
Есть и приземлённая версия мотивов Anthropic. С осени 2025-го компания обучает модели на переписке пользователей, которые не отказались от этого в настройках. Поток мата и капса — грязный обучающий материал. Хотя понимают мат нейросети по-прежнему отлично и воспринимают ровно как надо: «ты сделал не то, переделай».
Где граница между «наорал в сердцах» и «устойчивой бессмысленной жестокостью», Anthropic не уточняет — решать будут её модерация и классификаторы.
Источники: Engadget, TechCrunch, The Decoder