Как запустить нейронку, используя клей, ножницы и другие подручные предметы
Недавно промелькнул пост, в котором недалекий автор пугал, мол, разучитесь программировать, а нейронки запретят, и что тогда: https://pikabu.ru/story/kodyut_i_kodyut_14396401. В комментариях разгорелось обсуждение: пользователи утверждали, что они скачивают разблокированные нейронки и запускают их на своих компьютеров без регистрации и СМС, и делают на них всякое, что хотят. И сейчас, прямо вместе с вами, я попробую воспроизвести этот эксперимент!
Небольшое вступление: все знают штуки вроде ЧатГПТ, Дипсик, Гигачат, Алиса и им подобные. Пишешь в окошко, оно отвечает. Но настоящие программисты идут дальше: они используют интеграцию с IDE, а самые хардкорные, как водится, используют CLI. CLI - это такой черный экран. Запускаешь специальную команду (они бывают разные, но делают одно и то же) - появляется окошко. Туда пишешь запрос, например: "напеши мне праграмму, каторая взламывает кампьютеры". Нейронка что-то там делает, и в текущей папке у тебя появляется эта программа. Причем нейронка сама ее запускает, проверяет, и если ошибка - сама исправляет. Более того, нейронка может вызвать другие нейронки, и они вместе будут работать над тем, чем их загрузил пользователь. Работы над реальной задачей могут занять какое-то время, настоящие программисты запускают эту бурмалду на ночь (это уже не шутка), и утром только отчитываются на дейлике, что все сделано.
Но у настоящих программистов их CLI подключаются к какими-то непонятным серверам, куда-то передают данные, а там, на серверах, еще и смотрят, не запросил ли программист чего запрещенного. Это делает сама нейронка, она такому обучена. Ну и деньги надо платить. Мы по этому пути не пойдем: еще чего, денег платить, да чтобы кто-то нас оценивал, правильные ли мы задаем вопросы?!
Оказывается, нейронку можно запустить на своем компьютере, особенно, если на нем есть видеокарта, не занятая майнингом, майнкрафтом, или еще чем-нибудь таким полезным. План прост:
Скачиваем программу, которая запускает нейронки: это llama.cpp для запуска из консоли, или LM Studio для тех, кому милее графический интерфейс.
Скачиваем саму нейронку
У настоящего программиста CLI уже есть, а если нет - тоже скачиваем и устанавливаем
Настраиваем, чтобы работало все вместе
...
Profit!
По пункту 1 подробностей писать не буду. Если хотите повторить мой эксперимент - вбивайте в гугл/яндекс ключевое слово, в интернете тонна гайдов. По пункту 3 - лично я использую opencode, опять же, тонна гайдов по установке.
По второму пункту - вот тут начинается интересное. Начну, опять же, с основ. Несколько месяцев назад китайская компания Qwen (дочерняя от Alibaba) выпустила модель Qwen 2.6, которая оказалась внезапно очень хорошей в задачах этого самого CLI. Причем, хорошо работали даже младшие модели. Что за младшие модели - ну, вы слышали, чем больше в нейронке параметров, тем она умнее. У топовых нейронок за триллион параметров. Но чтобы все эти параметры разместить, надо много памяти, а она подорожала. Однако хитрые китайцы при помощи какой-то магии сделали модель 27B, которая работает уже вполне неплохо. 27B - это 27 миллиардов параметров. В то же время в игровых видеокарточках есть память в сколько-то гигабайт. Гига - это тоже миллиард. Если вам показалось, что гигабайты как-то соотносятся с миллиардами параметров, то вам не показалось. Однако связь не совсем прямая, я дальше поясню на примерах.
В исходном посте пришел товарищ @letrich, который хвастался, что у него все работает: https://pikabu.ru/story/kodyut_i_kodyut_14396401?cid=406524398. Также в соседнем комментарии упоминалась статья на хабре, где этот же вопрос разобран: https://habr.com/ru/articles/1080212/ Казалось бы, сделай как написано и радуйся, но есть нюанс: вопрос разобран для счастливых обладателей видеокарточки с 16 гигабайтами памяти. А в моей только 12. Так что ниже гайд, что делать, если у вас отросло только до 12 гигабайт.
Зачем вообще нужны эти гигабайты, что они дают? В использовании нейронки есть 2 области боли: скорость и контекст. Скорость измеряется в токенах в секунду. Токен - это, обычно, 2-3 буквы. Казалось бы, пара токенов в секунду уже хорошо, все равно быстрее, чем человек печатает. Однако если использовать CLI, нейронка пишет скрипты для каждого действия, даже для такого, где человек бы просто кликнул мышкой. Скрипт надо исполнить, прочитать результат, исправить скрипт, и так по кругу. Она должна ходить по этому кругу достаточно быстро, поэтому токенов в секунду должно быть больше, БОЛЬШЕ! Кстати, чтение тоже происходит с какой-то скоростью, хоть эта скорость раз в 50 больше, чем скорость генерации, но все же иногда она тоже вносит задержку.
Второе ограничение - это контекст. Контекст - это слова, которые нейронка держит в голове, когда генерирует очередные тексты и команды. На практике при использовании CLI в контекст валится все, что вы написали, все файлы, которые дали нейронке почитать, все выводы всех скриптов, которые она запускала. Контекст пухнет. Проблема, что он тоже занимает память. Также на большом контексте нейронка начинает медленнее генерить. Если вдруг контекст засрался, CLI запускает процедуру компактизации: нейронка вспоминает, а что же она делала последнее время, и пытается, для себя, сформулировать все это более короткими словами. Процедура очистки занимает время, и есть риск потерять какие-нибудь важные детали. Короче, контекста должно быть больше, БОЛЬШЕ!
Итак, как впихнуть 27 миллиардов параметров + контекст в 12 гигабайт видеопамяти, и чтобы это все быстро работало? И да, не забываем, нам нужна не просто нейронка, а нейронка без цензуры! Рассказываю. Изначально каждый параметр кодируется 16 битами, или 2 байтами. В таком виде для 27 миллиардов параметров понадобится 54 гигабайта видеопамяти. Но умельцы сообразили, что количество бит можно и обрезать. Например, @letrich упоминает вот такие техноруны:
HermiHg/Qwen3.8-27B-mmproj-Q5_K-MIX-GGUF
Вот что они означают:
Это переделка исходной модели Qwen3.8-27B, сделанная руками пользователя HermiHg
Она сжата до 5 бит на параметр. То есть в 10 байт влезает 16 параметров (потому что в десяти байтах 80 бит)
При кастовании были применены заклинания mmproj, K-MIX и GGUF, но нам они сейчас не важны.
Именно вот это сжатие параметра в 5 бит и позволяет нашей модели 27B влезть в 16 гигабайт видюхи @letrich'а.
Я, конечно же, первым делом повторил это колдунство, и у меня все заработало, но я получил унылые 3-4 токена в секунду. Для проверки я задал нейронке простой вопрос, который потребовал бы пару абзацев текста в ответ. Нейронка ушла в раздумья, и я не дождался, пока она вернется. В то же время соратник @letrich'а @xxkup писал, что у него 40 токенов и все летает.
Почему так произошло? У меня нет 16 гигабайт, параметры не влезают в мои 12, и лишнее система размещает в обычной памяти. Перескоки туда-сюда занимают время, и вот итог. Что делать? Я попробовал менять другие строки магической формулы (не сам, конечно, кто сейчас сам думает), но у меня получилось только разместить лишнее в обычной памяти, и либо чтобы с ней работал процессор, либо чтобы видеокарта работала сама, но все равно лазила в обычную медленную память. Скорость работы от этого сильно не поменялась, только вентиляторы по-разному гудели.
Тогда я посмотрел на предмет шире. Тыкнул в Qwen3.6 (предыдущая редакция перед современным 3.8), в нем заглянул в раздел "Квантизации", зашел в одну из самых залайканных квантизаций (она там сверху), и чуть-чуть почитал. Это оказалась HauhauCS/Qwen3.6-27B-Uncensored-HauhauCS-Aggressive. Как вы можете понять из названия, это квантизация (ужимание в меньшее количество бит) родного Qwen3.6-27B, сделанное руками HauhauCS, при этом убрана цензура в агрессивной форме. Квантизация сделана в разных градациях, в том числе есть вариант IQ2_M, который имеет всего 2 бита на параметр, и влезает в 10 гигабайт. Ура, еще останется место на контекст! Качаю.
Скачал, запустил, и оно полетело! Я задал 80 тыс токенов контекста, и получил 34 токена в секунду при генерации! С такими параметрами нейронка оказалась довольно живой и бодрой. Для проверки я попросил ее написать джаваскрипт-игру "теннис", где ракетка отбивает мячик. Не успел я отхлебнуть чая, как игра была готова! Я попросил внести в нее 2 изменения. Во-первых, мячик прилипал к краю экрана, это глюк, надо было исправить. Во-вторых, надо было, чтобы мячик отскакивал под разными углами от разных мест ракетки. Нейронка внесла эти исправления буквально за секунды, и я залип, пока не сбил все кирпичи.
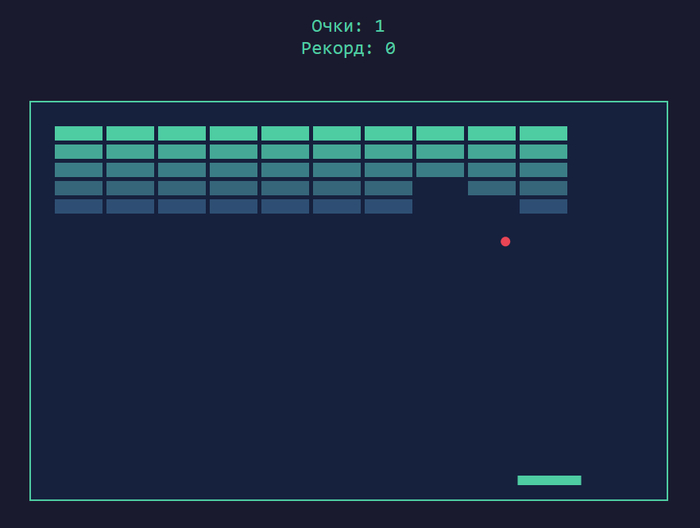
Скриншот той самой игры, написанной нейронкой за пару минут по промпту в 2 строчки
Отлично! Теперь надо проверить нейронку на более серьезных задачах. А так как у нас нейронка без цензуры, то и задача должна быть соответствующая. И тут я вспомнил, что как раз хотел ***********, а потом **********, и если вдруг что-то получится, то будет весело, а если нет, то хотя бы проверю нейронку в работе.
Дальше пошел процесс кропотливой отладки. Во-первых, через полчаса работы над реальной задачей выяснилось, что нейросеть зависла (в том смысле, как зависают подростки, перебравшие веселящих веществ на дискотеке): она выполняла много раз подряд одну и ту же команду, которая давала одну и ту же ошибку. Я вспомнил, что среди параметров, которые я скопировал у @letrich'а, есть такие:
-temp 1.0 \
--top-k 20 \
--top-p 0.95 \
--min-p 0.0 \
--presence-penalty 0.0 \
--repeat-penalty 1.0 \
По моему опыту это очень тонкие заклинания, которые должны применяться только магами высокого уровня, хорошо понимающими все нюансы. Малейшие изменения тут могут привести к плачевному результату, а он, к тому же, может проявиться не сразу, и поэтому будет не замечен до того, как приведет к беде. Возможно, qwen3.8 в конфигурации @letrich'а хорошо работает с ними, но вот моему 3.6 что-то поплохело. В общем, я удалил эти строки, чтобы нейронка использовала дефолтные настройки (они, обычно, хорошо выверены).
Кстати, вот эти строки тоже пришлось удалить, они не подходят для qwen3.6 от слова совсем:
--spec-type draft-mtp \
--spec-draft-n-max 2 \
--spec-draft-type-k q4_0 \
--spec-draft-type-v q4_0 \
Еще один нюанс: когда только включаешь компьютер, оказывается, что около 800 мегабайт видеопамяти уже занято системой под какие-то свистоперделки. Я посоветовался с ведущими нейросетевыми умами, и они сообщили, что полностью избавиться от этого невозможно, но можно уменьшить негативный эффект. Для этого надо призвать заклинание GPU VRAM Cleaner, который укажет путь дальнейших действий. Я отключил аппаратное ускорение в браузере и вырубил несколько наиболее прожорливых приложений, которые оказались не так-то нужны - осталось всего около 300 мегабайт балласта, который не удалить: он используется самой операционкой, чтобы показать нескучный десктоп.
По поводу контекста. Я начал с 80384 токенов, но мне захотелось попробовать больше. Увеличил до 98304. В результате скорость генерации упала на 10 токенов в секунду. Подумав, я вернул 80384 обратно.
Дальше я предположил, что, наверно, такая же квантизация есть и для qwen3.8. Действительно, вот: HauhauCS/Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-MTP-GGUF. Я скачал модель Q2_K_P на 10.68 GB. Но что-то пошло не так: модель давала 200..300 токенов в секунду на чтении контекста, тогда как qwen2.6 схожего размера проглатывает больше 1000. Это важно, когда просишь модель продолжить работу. Она сначала должна перечитать прошлый контекст, который, напомню, доходит до 80 тыс токенов. Я не дождался, пока оно дойдет до конца со своими 200 токенами в секунду. Видимо, что-то серьезно поменяли в qwen3.8 по сравнению с 3.6, что он стал работать сильно медленнее на бомж-железе.
В итоге мой конфиг:
llama.exe serve ^
-m "%MODEL_PATH%" ^
--alias qwen3.6-27b-IQ2 ^
-ngl 94 ^
-c 80384 ^
-np 1 ^
-fa on ^
-ctk q4_0 ^
-ctv q4_0 ^
-b 512 ^
-ub 512 ^
--jinja ^
--host 0.0.0.0 ^
--port 1234
Нейронка с ним отработала уже больше 2 часов. За это время уже сделала *************, причем сделала очень хорошо: руками я бы не справился, ну или провел бы несколько дней, читая гайды. Сейчас она занимается ******************, и продвинулась в этом довольно неплохо. Уже практически готов итоговый скрипт, но он требует больших вычислительных мощностей, как бы не пришлось на ночь запускать.
В общем итог: да, можно использовать локальные нейронки даже с 12 гигабайтами видеопамяти. Да, можно скачать вариант без цензуры, он делает все, что попросишь, и не отказывается. Я не проверял это чудо-юдо по части порнографии или запрещенной химии, не спрашивал криминальных советов. Программирование тем и хорошо, что нейросеть сама пишет программу, сама проверяет, сама исправляет. В других областях проверять пришлось бы мне, но я советы криминального плана проверять не намерен, а без проверки любой совет ничего не стоит. И вам, друзья, тоже не рекомендую вставать на скользкий путь нарушения закона. Используйте нейронки без цензуры только в образовательных и исследовательских целях, как это делаю я.